Dropout神经网络的逼近理论:Sobolev速率与置信界

为带Dropout的ReLU网络建立首个非渐近、带概率保证的Sobolev函数逼近上下界理论
这篇论文研究在Dropout正则化(边以概率$p$随机保留)下,ReLU网络逼近Sobolev空间$W^{n,\infty}([0,1]^d)$函数的能力。核心贡献是给出了一个显式构造:规模约为$\widetilde O(p^{-9}\varepsilon^{-\max\{d/n,2\}}\log(1/\delta))$的常数深度网络,能以至少$1-\delta$的概率实现$\varepsilon$精度的一致逼近。与此同时,作者从Sobolev容量和仿射函数逼近两个角度建立了下界,证明Dropout的随机性强制要求输出层至少付出$(1-p)/p\cdot\varepsilon^{-2}\log(1/\delta)$的代价。在$d\leq 2n$等参数条件下,上下界在精度指数和置信依赖上完全匹配,说明构造在量级上最优。保留概率的最优幂次和对数因子的精确刻画仍是开放问题。
研究背景:普适逼近之外的问题
神经网络的普适逼近定理(Universal Approximation Property)告诉我们,足够宽或足够深的网络可以逼近任意连续函数。但这个经典结论有一个常被忽略的盲点:它并没有回答一个更实际的问题——要达到特定精度,究竟需要多大规模的网络? 当引入 Dropout 这种随机正则化机制后,网络的边是以概率 $p$ 独立保留的,问题变得更加微妙。此时,一个随机采样出的网络能否稳定地给出高精度逼近,就不再是确定性的保证,而是一个带概率的命题。
这篇 arXiv 预印本(arXiv:2610.02253v1)正是针对这一空白展开研究。作者关注的核心对象,是 Sobolev 空间 $W^{n,\infty}([0,1]^d)$ 单位球中的目标函数,并试图用带 Dropout 的 ReLU 网络去逼近它,同时在整个输入域上以**一致误差(uniform error)**衡量逼近质量。
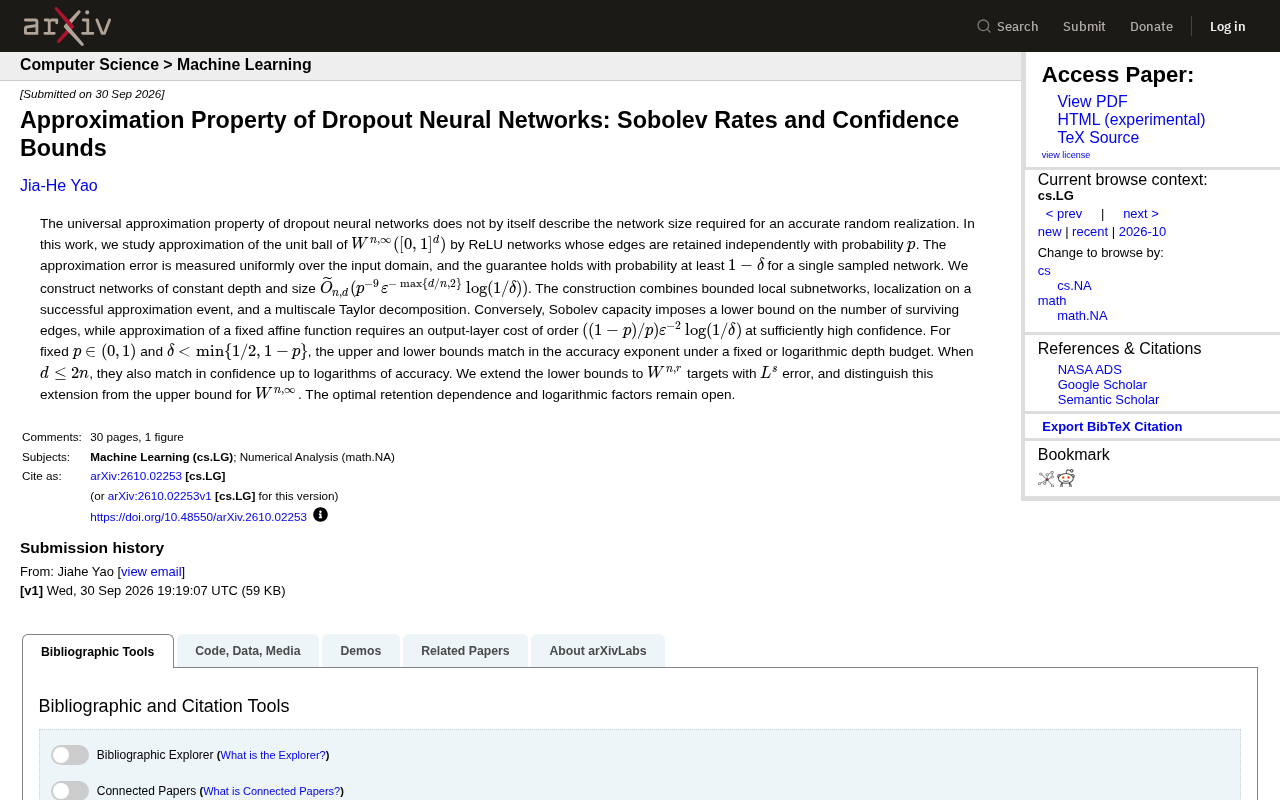
Sobolev 空间 $W^{n,\infty}([0,1]^d)$ 是函数逼近理论中的标准舞台。直观来说,$W^{n,\infty}$ 中的函数不仅连续,其直到 $n$ 阶的所有偏导数都在 $L^\infty$ 意义下有界,这使得函数具备良好的光滑性。参数 $n$ 可以理解为"光滑度",$d$ 是输入维数。选择这个空间的原因在于:它既足够一般(覆盖实际应用中常见的光滑函数类),又有经典的逼近率理论可以对照——在没有 Dropout 的确定性设定下,最优逼近率早已被 Barron、DeVore 等人研究清楚,以 $\varepsilon^{-d/n}$ 的参数复杂度为基准。这篇论文正是在这一成熟背景下,追问 Dropout 究竟带来多少额外代价。
核心设定:带概率保证的逼近
理解这项工作的关键,在于它的误差度量方式。传统逼近分析往往针对确定性网络,而这里研究的是单次采样网络(single sampled network)的行为。具体而言,作者要求逼近误差在整个输入域 $[0,1]^d$ 上一致成立,并且该保证以至少 $1-\delta$ 的概率对一个随机采样出的网络有效。
这种设定更贴近 Dropout 的实际使用场景:在推理或训练过程中,网络的连接是随机断开的,我们希望即便在这种随机性下,网络依然能可靠地完成逼近任务。$\delta$ 这个参数衡量的就是"失败概率"——允许多大比例的采样网络达不到目标精度。
构造性的上界结果
作者给出的正向结果是一个显式的网络构造。他们证明,存在常数深度、规模为
$$\widetilde O_{n,d}\left(p^{-9}\varepsilon^{-\max{d/n,2}} \log(1/\delta)\right)$$
的网络,能够满足上述带概率的逼近要求。这个表达式包含三个关键因子:
- 保留概率的依赖 $p^{-9}$:Dropout 保留概率越低,所需网络规模急剧膨胀,呈九次方关系。
- 精度指数 $\varepsilon^{-\max{d/n,2}}$:这里体现了维数灾难的影子——当输入维数 $d$ 相对于光滑度 $n$ 较大时,指数由 $d/n$ 主导;反之则由常数 2 托底。
- 置信因子 $\log(1/\delta)$:对数级的代价意味着提升可靠性相对廉价。
构造方法融合了三个技术要素:有界的局部子网络、在"成功逼近事件"上的局部化处理,以及多尺度 Taylor 分解。这套组合拳的思路是先在局部用低阶多项式逼近,再通过多尺度拼接覆盖整个域,同时用冗余设计来对抗 Dropout 带来的随机失效。
多尺度 Taylor 分解是构造上界的核心技术。其基本思想是:在每个局部小块上,用目标函数的 $n$ 阶 Taylor 展开作为多项式近似,逼近误差由块的尺寸和函数的 $n$ 阶导数界控制;然后将整个域 $[0,1]^d$ 分割成若干小块,在各块上分别构造局部 ReLU 子网络来实现对应的多项式。"多尺度"指的是为了对抗 Dropout 的随机失效,同一局部区域会有多个冗余副本参与逼近,不同层级的冗余度匹配不同的失效概率。这种冗余设计正是 $p^{-9}$ 这一高次依赖的来源——每一个逼近步骤都需要保证以高概率至少有一个副本存活,多个步骤的概率乘积效应逐渐累积,最终体现为对 $p$ 的高次幂依赖。
下界:随机性带来的不可规避代价
仅有上界还不足以说明问题,真正有价值的是匹配的下界。作者从两个角度论证了网络规模的必要性。
其一来自 Sobolev 容量(Sobolev capacity) 的约束,它对"存活边"的数量施加了下限——无论如何构造,达到目标精度所需保留的边不能太少。其二更有启发性:即便只是逼近一个固定的仿射函数,在足够高的置信水平下,输出层的代价也必须达到
$$\frac{1-p}{p},\varepsilon^{-2}\log(1/\delta)$$
这个结果相当漂亮,它揭示了 Dropout 的随机性如何直接转化为计算代价。当保留概率 $p$ 较小时,$(1-p)/p$ 这一项会放大,说明高 Dropout 率必然要求更冗余的输出层——这是随机采样方差所强加的硬性约束。
上下界何时匹配
理论工作的价值很大程度上取决于上下界能否"对上"。作者给出了明确的匹配条件:
对于固定的 $p\in(0,1)$ 和 $\delta<\min{1/2,1-p}$,在固定或对数深度预算下,上界与下界在精度指数上完全吻合。更进一步,当 $d\leq 2n$(即光滑度相对维数足够高)时,二者在置信依赖上也匹配,仅差精度的对数因子。
这意味着在这些参数区间内,论文给出的构造在量级上是"最优"的——不存在渐近意义上显著更小的网络。
Sobolev 容量(Sobolev capacity)是泛函分析中量化函数类"信息量"的工具。其核心思想是:若目标函数类足够复杂(包含足够多相互可区分的函数),则任何逼近方案都必须使用足够多的参数(或"存活边")才能将它们区分开来。在 Dropout 的框架下,容量下界转化为对期望存活边数目的约束——即使网络总边数很多,如果每条边只以概率 $p$ 保留,那么期望上能用来表达信息的边数是受限的。这一角度将组合信息论与概率分析联系起来,是获得与网络总规模相关的下界的标准路径。
上下界"匹配"在理论研究中意味着构造已达到信息论最优:不存在渐近更高效的方案。这里的匹配是在 $\widetilde O$ 意义下(即忽略多对数因子)成立的,并非精确等式。条件 $d \leq 2n$ 意味着函数的光滑度相对于输入维数足够高,此时函数类的复杂度不会因维数爆炸而完全压倒 Dropout 代价,上下界才能在置信依赖(即 $\log(1/\delta)$ 项)上也对齐。当 $d > 2n$ 时,置信依赖上的缺口尚未弥合,这正对应了论文留下的开放问题之一——当前上界中 $p^{-9}$ 因子是否最优,以及高维低光滑度情形下对数因子的精确刻画,都还有待后续工作解决。
推广与遗留问题
除主结果外,作者还将下界推广到了更一般的情形:以 $L^s$ 误差衡量对 $W^{n,r}$ 空间目标的逼近。他们明确区分了这一推广与 $W^{n,\infty}$ 情形下上界之间的差异,说明误差度量和目标函数空间的选择会实质性影响结论。
论文也坦诚地留下了开放问题:保留概率 $p$ 的最优依赖关系(当前上界的 $p^{-9}$ 是否可以改进)以及对数因子的精确刻画仍未解决。这为后续研究指明了方向。
意义与展望
这项研究的价值不在于提出新的网络结构,而在于为 Dropout 这一广泛使用的技术建立了非渐近的、带概率保证的逼近理论。它把"网络能逼近"这个定性结论,细化为"需要多大规模、以多大概率成功"的定量刻画,并在相当宽的参数范围内给出了匹配的上下界。
对于理论研究者而言,这类结果填补了随机网络逼近理论中的重要空白;对于实践而言,它提示我们:过高的 Dropout 率(即 $p$ 过小)在逼近能力上要付出沉重代价,这一点在设计正则化策略时值得权衡。当然,作为一篇理论预印本,其结论仍处于严格数学框架内,距离直接指导工程实践还有一定距离。
相关推荐
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
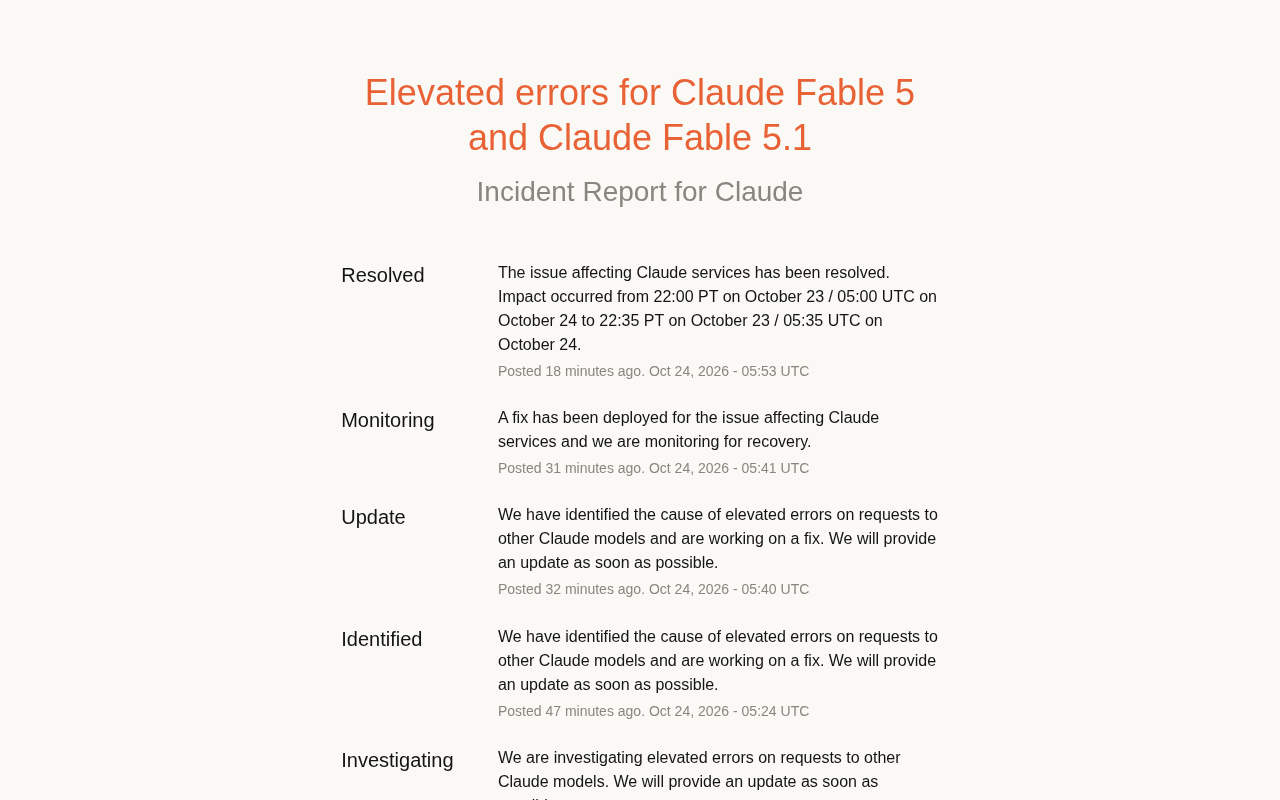
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。