DSH省token必装的4个插件,别再无脑装了

token成本主要来自模型读了多少、想了多少、重复读了多少,四个插件分别从少读、少想、少重读三条路径省钱。
文章指出,token消耗并不取决于用户说了多少话,而在于模型读取、生成和重复读取的量。同一段内容第二次读取的价格仅为第一次的五十分之一,模型自己生成的内容单价更高,长对话越到后面越贵,因为每轮都要重读全部历史。据此可归纳出少读、少想、少重读三条省钱路径,并对应介绍四个插件:DSH Shops用更紧凑的工具输出减少每轮读取量,Billion Context把早期上下文折成摘要以控制长度,DSH Vision Router先把图片转成文字以避免每轮重读,DSH Thinking Levels则根据任务难度自动调节思考深度。文章还提醒装前备份、先统计支出结构、装前装后对比花费验证效果。
为什么你说了没多少,token账单却一直涨
很多人以为token消耗取决于自己说了多少话,但据B站UP主紫月的分析,真正烧钱的部分往往是你没注意的地方。同一段话,DSH第二次读取它的价格只有第一次的五十分之一,而模型自己「想出来」的那些字,还要额外计价。换句话说,真正决定成本的不是你输入了多少,而是模型读了多少、想了多少、重复读了多少。
这也解释了为什么长对话越到后面越贵:每发一句话,模型都会把前面的全部内容从头读一遍。读过的部分算缓存命中,价格低;没读过的按原价计;模型自己生成的内容单价更高。
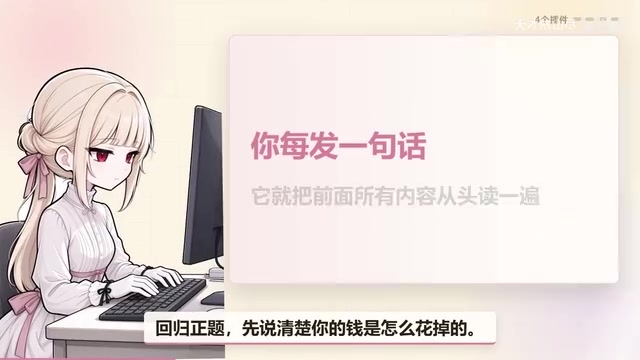
由此可以归纳出省token的三条路径:少读、少想、少重读。下面这四个插件,分别对应这三个方向。
上下文窗口与重复计费
大语言模型本身是无状态的:每次生成回复时,模型都要把“当前对话的全部历史”(系统提示、用户消息、模型回复、工具返回结果等)作为输入重新读一遍。这个可容纳的最大长度叫上下文窗口(context window),通常以 token 计量。因此长对话中第 N 轮的输入量约等于前 N-1 轮所有内容的累积,成本会随轮次快速叠加,而不是只按你这一句的长度计费。
缓存命中与单价差异
主流 API 提供提示缓存(prompt caching):如果本次请求的前缀与上一次完全相同,这部分内容可按“缓存命中”的较低价格计费;新增或变化的部分按原价计。这解释了文中“第二次读取只有第一次五十分之一”的说法。缓存通常有有效期(几分钟到几小时不等),间隔太久会失效,需要重新按原价读。
输入与输出 token 的定价不对称
模型“想出来”的字属于输出 token,单价通常显著高于输入 token(常见为 3~5 倍)。文中的“少读、少想、少重读”,分别对应减少未命中缓存的输入、减少输出生成、以及减少重复读取,这三者正是账单的主要构成。
一、DSH Shops:让工具调用的输出更紧凑
DSH Shops 的思路是替换官方那套读取、搜索、执行命令的工具,换成输出更紧凑、更短的版本。工具返回的内容越短,模型需要读的字就越少。
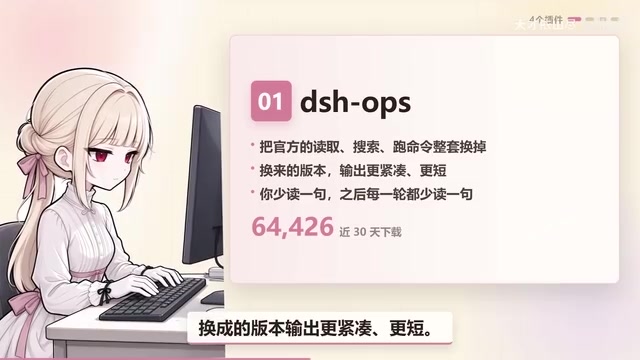
这个插件的价值在于「乘数效应」:它减少的不是一次性的量,而是每一轮对话中都要重复读取的量。UP主的说法很直接——你少读一句,之后每一轮都少读一句。对于需要频繁调用搜索或命令的长会话,这种累积节省相当可观。
二、Billion Context:把早期上下文折成摘要
Billion Context 是下载量第一的插件,属于「填材」类工具。它的逻辑是:随着对话中读过的东西越来越多,当累积到一定量时,把最早的那一段折成摘要,从而控制上下文长度。
这对应的是「少重读」这条路。上下文越长,每一轮的重复读取成本越高,而摘要压缩能把早期内容的体积降下来。适合长期使用、话题跨度大的场景。
三、DSH Vision Router:把图片先转成文字
图片一旦进入对话,就会一直留在上下文里,之后每一轮都跟着重读一遍。DSH Vision Router 提供的是一条「免K」的路径:先把图翻译成文字再送进来,图变成几行字,体积小得多。
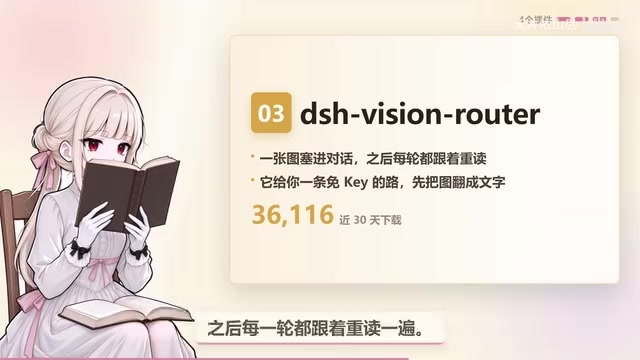
据UP主介绍,这种处理方式从第二次读取开始,价格只要原来的五十分之一。对于经常在对话里贴截图、看图表的用户,这个插件的节省效果会非常明显。
四、DSH Thinking Levels:给「想多久」装一个自动挡
复杂的任务想久一点,简单的任务想快一点,道理大家都懂,但很多人手上并没有那个开关。DSH Thinking Levels 提供的就是这个自动挡:它会观察你最近在做什么,简单活多就往下调,碰上需要动脑的任务再往上调。
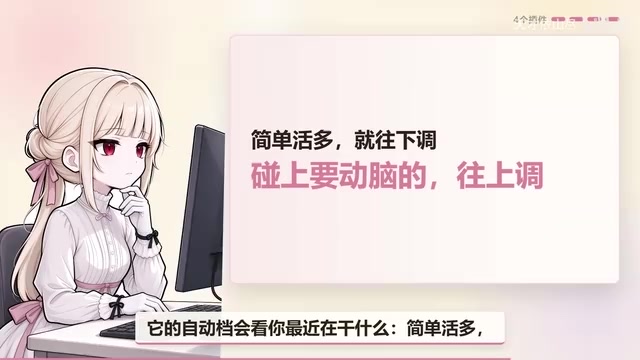
这对应的是「少想」这条路——控制模型生成内容的量,也就控制了那部分按更高单价计费的开销。
安装注意事项:别无脑装
UP主在视频里特别提醒了几点,值得在动手前先看清楚:
- 装之前先备份。 部分插件之间存在冲突,也可能出现版本不匹配导致报错的情况。
- 不是每个都要装。 先问你的DSH,统计自己到底在哪一块支出更多,再针对性地选插件。
- 装前装后各看一眼数字。 记录安装前每轮的花费,装完再看一次,数字动了才算真正省下来。
这四个插件都可以在插件市场里搜名字找到,也可以直接问DSH。
一点观察
这类省token插件的流行,说明一个趋势:随着AI编程和日常AI应用的使用强度上升,成本优化正在从「模型选型」下沉到「上下文管理」层面。少读、少想、少重读这三条路,本质上都是对上下文和生成量的精细控制。对高频用户来说,装对插件带来的节省可能比换一个更便宜的模型更直接。
但插件生态也带来新的复杂度:冲突、版本、兼容性,都是需要自己承担的维护成本。先测量、再安装、后验证,这套流程比盲目跟风更重要。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。