dSpark:用调度蒸馏让扩散语言模型学会"先解锁谁"
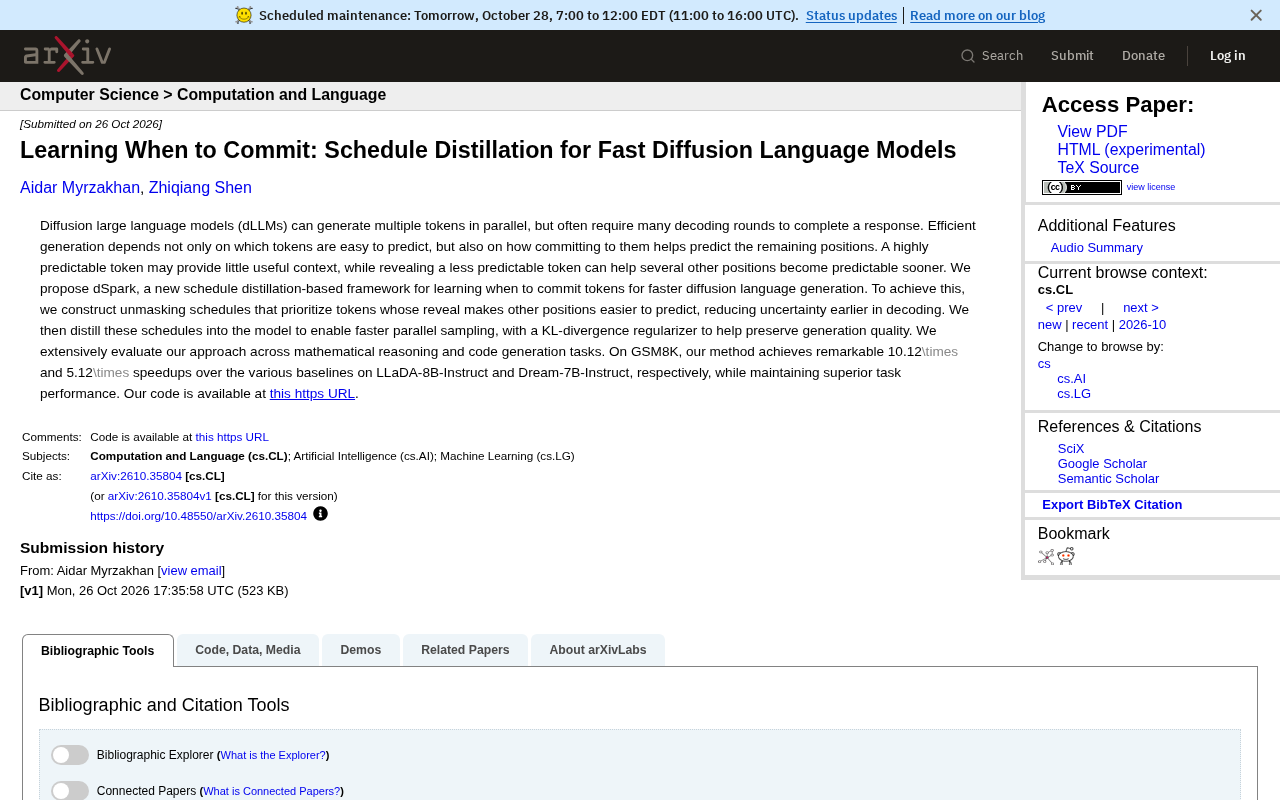
dSpark 用调度蒸馏优化扩散语言模型的解除掩码顺序,实现数倍推理加速。
扩散语言模型并行生成 token 时,解码轮数往往过多,瓶颈在于先揭示哪个 token 的顺序选择。VILA-Lab 提出 dSpark,指出 token 的价值不仅在于自身是否容易预测,更在于揭示它能否让其他位置连锁变得可预测。方法分两步:先离线构造优先揭示高"信息外溢"token 的解除掩码调度,再通过蒸馏把该调度对齐进模型并行采样行为,并用 KL 散度正则约束质量。在 GSM8K 上,LLaDA-8B-Instruct 实现 10.12 倍加速,Dream-7B-Instruct 实现 5.12 倍加速,任务表现保持甚至更优。该工作把解码顺序从推理时启发式规则转化为模型习得能力。
扩散语言模型(dLLM)最大的卖点之一是并行生成多个 token,但实际用起来常有一个尴尬:明明每个 token 单独看都不难预测,却要来回解码很多轮才能把整句话"填"完。问题出在"承诺"的顺序上——先确定哪个 token,会直接影响剩下位置的可预测性。
来自 VILA-Lab 的研究提出了 dSpark,一个基于调度蒸馏(schedule distillation)的框架,核心思路是:不要只盯着"哪个 token 容易预测",而要问"先揭晓哪个 token,能让其他位置更快变得可预测"。
为什么"容易预测"不等于"应该先出"
扩散语言模型的解码过程可以理解为逐步解除掩码(unmasking)。每一步选择哪些位置先"落子",决定了后续每一步的难度。
直觉上,先确定高置信度的 token 似乎最稳妥。但论文指出了一个反直觉的现象:一个高度可预测的 token 可能对上下文帮助很小,而提前揭示一个不太确定的 token,反而能让好几个其他位置一下子变得可预测。换句话说,token 的价值不只是它自身的置信度,还包括它对剩余位置的"信息外溢"。
这就像填字游戏:先填一个显而易见的短词,未必能帮你解开长词;而先攻克一个关键的交叉字母,可能让一整片区域豁然开朗。现有 dLLM 的解码策略大多没有显式建模这种"连锁解锁"效应。
扩散语言模型(dLLM)与掩码语言模型的关系
dLLM 的骨架与 BERT 类掩码语言模型高度相似:训练时随机遮盖一部分 token,让模型根据剩余上下文还原。区别在于推理阶段——BERT 通常只做一次预测,而 dLLM 从全掩码或高掩码率出发,反复迭代、逐步减少掩码,直到整句被"填满"。每一轮迭代中,模型对所有被掩码位置并行给出分布,然后按某种策略挑选一部分位置"落子"(unmask),被选中的 token 从此固定,不再修改。因此,单次前向的计算量近似于一次并行预测,总耗时取决于迭代轮数。轮数越少,加速越明显,而轮数直接由"每轮选哪些位置"决定。这也是调度策略成为 dLLM 推理效率核心杠杆的原因。
dSpark 的两步走:构造调度,再蒸馏进模型
dSpark 的做法分成两个阶段。
首先是构造"好"的解除掩码调度。研究者设计的调度策略会优先揭示那些能让其他位置更容易预测的 token,从而在解码早期就压低整体不确定性。这相当于在离线阶段先算出一条更聪明的路径。
然后是把这条路径蒸馏进模型本身。光有离线调度还不够——它需要和模型的实际并行采样行为对齐,才能真的加速。dSpark 通过蒸馏让模型学会更快的并行采样,并引入 KL 散度正则项来约束生成质量,避免为了提速而牺牲输出。
这个设计的巧妙之处在于,它把"解码顺序"从推理时的启发式规则,变成了模型内部习得的能力。
调度蒸馏(schedule distillation)的含义
蒸馏通常指用一个大模型(教师)的输出分布指导小模型(学生)训练。调度蒸馏把"教师"换成了"一条预先算好的解码轨迹":先离线构造出一条高质量的解除掩码顺序(即每一步揭示哪些位置),再让模型在训练中模仿这条轨迹所对应的并行采样行为。这样做的动机是,离线调度虽然理论上更优,但它依赖的是固定模型在特定时刻的置信度,而模型在真正并行采样时分布会随已揭示 token 变化,两者存在偏差。蒸馏相当于把离线调度的"意图"翻译成模型内部可执行的策略,使推理时无需再跑复杂的调度搜索,直接用模型自身的预测就能逼近那条好路径。
KL 散度正则项在生成质量控制中的作用
KL 散度衡量两个概率分布之间的差异。在 dSpark 的蒸馏目标中,除了让模型匹配调度轨迹的行为,还加入一项 KL 正则,约束模型在当前步的预测分布不要偏离某个参考分布(通常是原始模型或教师分布在对应位置上的输出)太远。这一项的作用是防止模型为了追求"少步数"而过度自信地乱猜:一旦某些位置的分布被压得过于尖锐,错误 token 会被过早固定且无法回退。KL 正则相当于给加速过程加了一个"别走太偏"的软约束,在提速与生成质量之间取得平衡,这也是论文能在 GSM8K 等对结构敏感的任务上保持表现的重要原因。
实测:数学推理与代码生成上的加速
论文在数学推理和代码生成两类任务上做了评估,这两个领域对生成质量和结构性要求都较高。
在 GSM8K 上,dSpark 相对多种基线方法,在 LLaDA-8B-Instruct 上实现了 10.12 倍的加速,在 Dream-7B-Instruct 上实现了 5.12 倍的加速,同时任务表现保持甚至更优。
需要说明的是,这两个加速数字对应的是不同的基础模型和基线组合,不能简单理解为"同一模型上翻十倍"。但即便保守看,这个量级的提速对扩散语言模型的实用化也很有意义。
代码已开放在 https://github.com/VILA-Lab/dSpark。
一个值得关注的方向
扩散语言模型要真正和自回归模型竞争,推理效率是绕不开的关卡。dSpark 的贡献不在于发明新的采样器,而是换了个提问方式:从"预测什么"转向"何时承诺"。
这种调度视角也可能启发其他并行生成场景,比如投机解码中的草稿调度、多 token 预测的排序策略。当然,调度蒸馏需要额外的离线构造和蒸馏成本,它在更大模型和更多任务上的泛化性,还有待社区进一步验证。
相关推荐
用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。
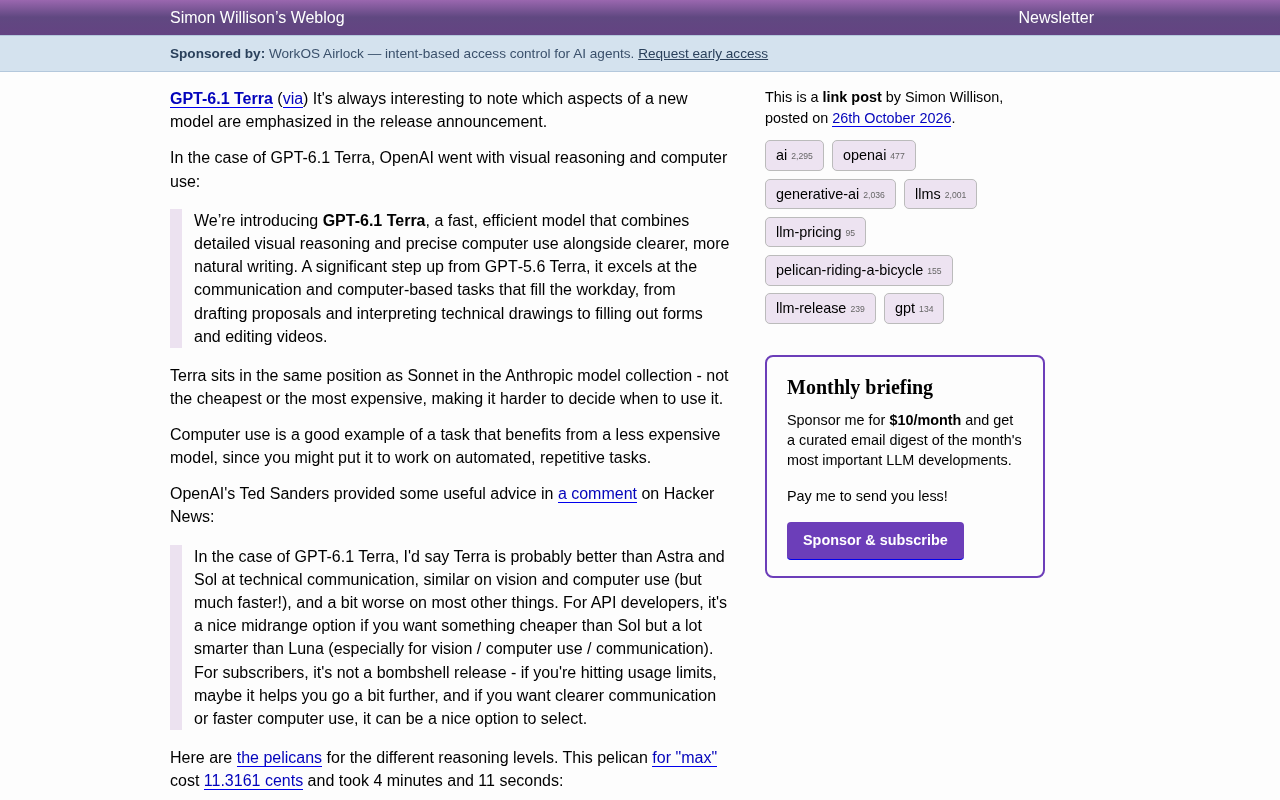
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。
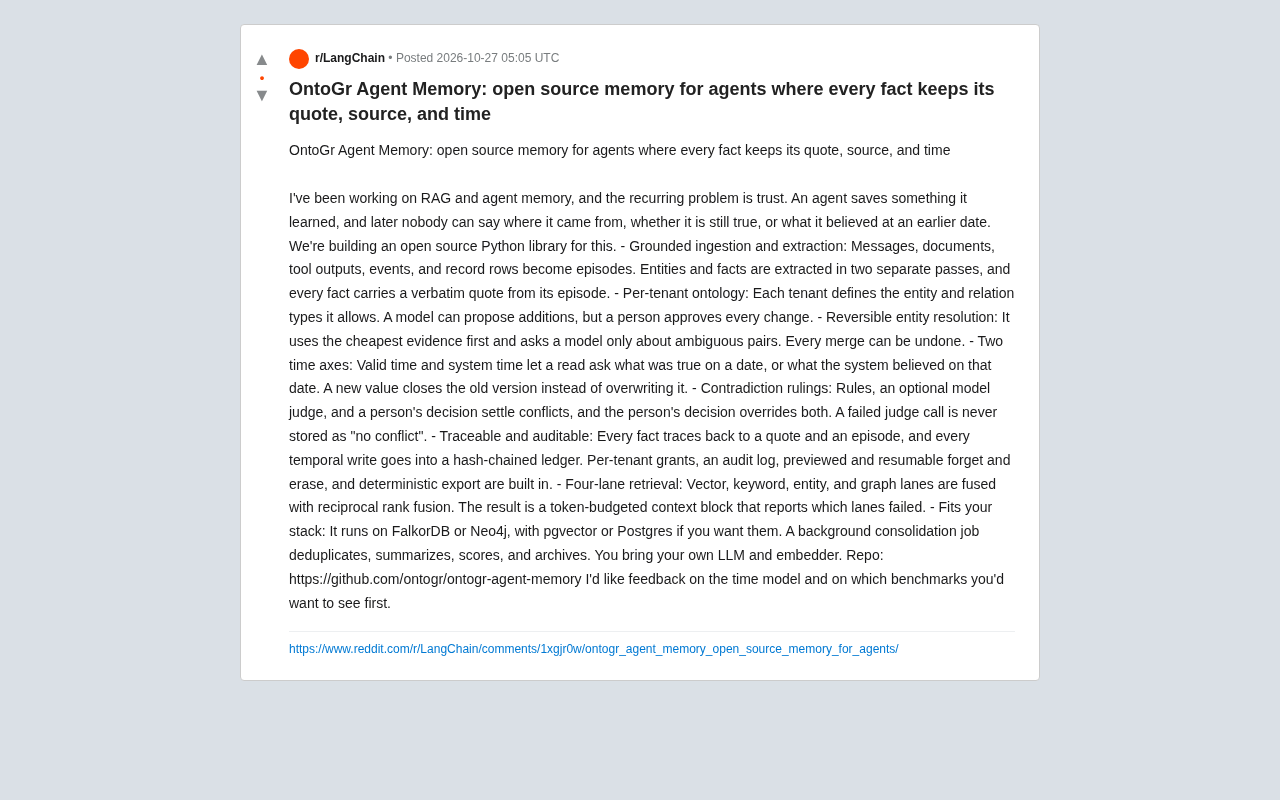
OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。