DuckDB与Arrow称霸AI数据准备,为何在推理服务碰壁?

列式引擎擅长批量扫描聚合,却不适配单行推理查找;Arrow 的真正价值是零拷贝交换而非查询速度。
文章反驳了“列式引擎应成为 AI 数据基础设施端到端默认骨干”的流行观点。列式存储为扫描海量行、计算少量聚合而优化,在构建训练集时优势明显;但推理请求本质是高并发下的单行点查找,需要触及 N 个独立列块并逐列重建,摊销优势消失,长尾延迟无法隐藏。向量数据库专门构建 HNSW/IVF 索引、智能体系统每轮执行数十次点读取,都印证了这一点。作者指出 Arrow 的核心贡献是共享的零拷贝内存布局,消除了离线流水线中工具间的序列化边界,而非查询速度。正确架构应分离离线列式处理与在线行式存储,以 Arrow 作为两者接缝处的交换格式。
TL;DR — 列式引擎(如Arrow、DuckDB、Polars及GPU DataFrame)擅长扫描大量行并计算聚合,是构建训练集的理想选择;但面对单行推理查找时表现糟糕。Arrow在AI系统中的核心价值不在于查询速度,而在于以零拷贝方式在离线列式世界与在线行式世界之间实现数据交换。试图让一个引擎同时承担两者,团队将付出p99延迟的代价。
每隔几个月,就会有新的基准测试显示DuckDB、Polars或GPU DataFrame引擎在TPC-H类工作负载上碾压对手。这些数字是真实的,但人们从中得出的结论——列式引擎已成为AI数据基础设施端到端的默认骨干——恰恰是错误的。
列式引擎在特定任务上表现卓越:扫描大量行以计算少量聚合值。然而,在大多数AI推理路径实际需要的场景——在高并发下快速获取单行数据——它们存在结构性缺陷。两者并非同一问题,但业界却不断构建系统,悄然假设它们可以互换。
列式存储到底优化了什么?
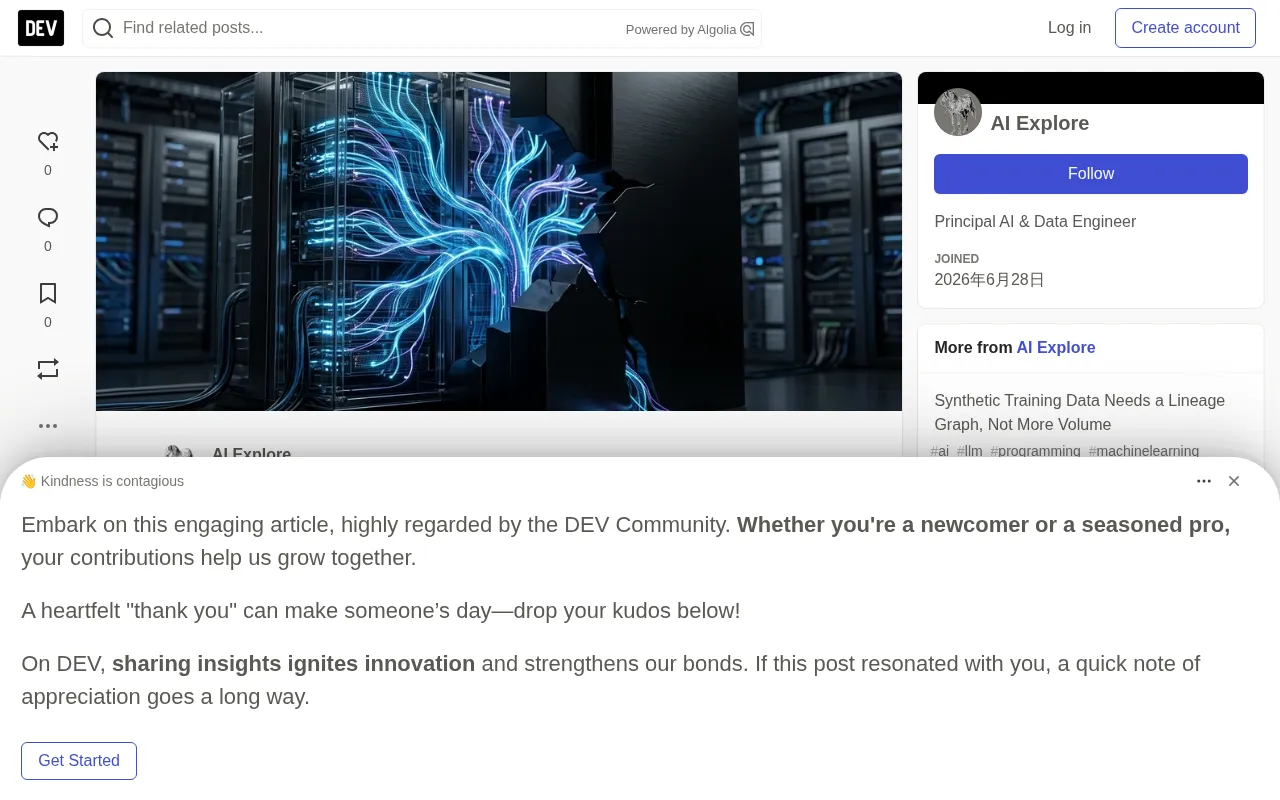
列式存储的存在,是因为分析型查询通常只触及少量列,却要扫描海量行。按列存储意味着只读取需要的字节,将相似值压缩在一起,并能跨越连续内存进行向量化操作,几乎无需分支预测。这正是Arrow的列式内存格式、DuckDB执行引擎与GPU DataFrame库共同的核心赌注:将固定开销摊销到数百万个值上。
对于构建训练集而言,这一赌注完全正确。你需要将事件事实表与用户属性维度表连接,计算滚动聚合,过滤、去重——所有这些都是在大型批次上进行的扫描-归约操作。列式引擎执行此类任务比行式数据库快一个数量级,而GPU加速的列式执行通过将相同的向量化操作并行化到数千个核心上,进一步提升了性能。
然而,这一切与推理时发生的情况毫无关系。
零拷贝(Zero-copy) 是理解 Arrow 价值的关键概念。传统数据交换中,一个引擎把结果写入文件或内存缓冲区,下一个引擎再读取并解析成自己的内部格式,这中间至少发生一次序列化和一次反序列化,涉及内存分配与数据复制。零拷贝则指多个进程或库共享同一块物理内存,各自用自己期望的布局视图直接读取,不发生数据搬移。Arrow 定义了一套与语言无关的内存布局规范(列式、定长偏移、缓冲区对齐),使得 Pandas、Polars、DuckDB、PyTorch 等只要遵循该规范,就能互相传递数据指针而非数据本身。其代价是双方必须接受同一套布局约束,一旦需要改变类型或重排,零拷贝优势就会消失。
向量化执行(Vectorized Execution) 指查询引擎不是逐行处理,而是按批(通常 1024 到 8192 行)对整列数据调用 SIMD 指令或紧凑循环,把循环开销、分支判断摊销到整批元素上。这正是列式引擎在扫描-归约场景中快一个数量级的原因,也解释了为何该优势在单行查找时完全失效:批量大小为一时,摊销对象消失,只剩下逐列重建的开销。
模型在何处失效?
一次推理请求——无论是聊天轮次、智能体步骤还是排序调用——需要的是少量特定行:该用户当前的特征向量、该文档的嵌入、该会话的运行状态。这是点查找,而非扫描。在列式存储中,重建单条逻辑行意味着要触及N个独立的列块,每个块可能被压缩,可能位于不同的页面或文件。无论你需要一行还是一百万行,你都要支付这种重建成本。对于一百万行,它可以被向量化吞吐量掩盖;但对于一行,在p99延迟、并发负载下,就是纯粹的延迟,没有摊销可以隐藏。
这就是为什么没有人会从每次请求都重新扫描的Parquet文件来服务生产推荐特征存储。这也是为什么向量数据库不将向量存储在通用列式表中并暴力扫描——它们专门构建HNSW或IVF索引,正是因为访问模式是“立即找到与查询向量最近的邻居”,这与列式布局擅长的场景完全相反。向量数据库领域已经吸取了这个教训,但更广泛的AI数据栈尚未内化。
智能体系统中也会出现同样的错误。一个需要读取对话状态、工具输出和长期记忆片段的智能体步骤,每轮会执行数十次小型、延迟敏感的点读取。如果底层搭载列式分析引擎,你构建的系统在回答“上周发生了多少次智能体运行”时极快,但在回答“这个特定智能体五轮前记住了什么”时却慢得令人痛苦。
HNSW(Hierarchical Navigable Small World) 与 IVF(Inverted File Index) 是向量数据库中两类主流的近似最近邻索引。HNSW 构建多层图结构,查询时从稀疏顶层逐层贪心下降,在每层只访问少量邻居节点,从而以对数级复杂度逼近最近邻;IVF 则先用 k-means 将向量聚成若干簇,查询时只扫描距离查询向量最近的若干簇,牺牲少量召回率换取速度。二者共同点是:它们都针对“给定一个查询向量,立刻找到最近的 K 个”这一点查找访问模式而设计,而非顺序扫描全部向量。如果强行把向量存进通用列式表再暴力计算距离,每次查询都要读取并解码全部向量列,这正是文章所说“完全相反的访问模式”。向量数据库的索引结构本身就是对列式布局不适用于在线检索这一事实的工程回应。
Arrow的真正贡献不在查询引擎
这正是Arrow真正发挥价值的地方,也是大多数基准测试所忽略的部分。Arrow对AI基础设施的贡献在于:提供一种共享的、零拷贝的内存列式布局,使多个引擎无需在彼此之间序列化即可读写。Pandas、Polars、DuckDB、Spark、PyTorch数据加载器、GPU DataFrame——它们都能传递同一块内存,而无需在每个边界支付转换税。
这对于AI流水线的离线侧意义重大,数据从原始日志到训练批次要经过五六个工具。每消除一个序列化边界,就节省了真实的墙钟时间和基础设施成本,这与任何单个引擎的查询规划器速度无关。Arrow生态系统中引人注目的部分是“看这个SQL查询跑得多快”,而默默承载关键作用的部分是“看这消除了多少工具间没人想到要合并的复制操作”。
将这两种贡献混为一谈是错误的。团队读到“Arrow快”和“DuckDB快”,便得出结论:列式栈应一直延伸到服务边界。事实并非如此,强行这样做会导致推理路径在批量大小为10,000的负载测试中很快,但在真实流量下(批量大小为一,持续重复,延迟预算以毫秒计)崩溃。
特征存储(Feature Store) 的经典双存储模式值得展开。离线存储通常是大数据量的列式仓库(Parquet/Delta/Iceberg 加 Spark 或 DuckDB 计算),用于批量计算特征、回填历史、保证训练与推理特征定义一致;在线存储则是低延迟键值库(如 Redis、DynamoDB 或自建内存 KV),按实体键保存最新特征值,供推理时毫秒级读取。两者之间需要一条物化管道:离线算好的特征批次经 Arrow 交换格式写入在线存储,避免 JSON 等文本格式的序列化开销。这一模式解决的核心问题是训练-服务偏差(training-serving skew):如果离线与在线使用不同的计算逻辑,模型在线表现会偏离评估结果。因此双存储不是过渡方案,而是兼顾吞吐与延迟的结构性选择。
为两种速度而设计,而非一种
真正有效的架构将这一问题视为两个不同的问题,并在明确定义的接缝处连接。离线侧,使用列式和GPU加速栈做它擅长的事:构建和刷新训练数据集、计算批量特征转换、回填、对记录的推理流量进行分析评估。这正是基于Arrow的引擎和GPU DataFrame能带来真实、可重复收益的地方,因为工作负载确实是大数据量上的扫描-归约。
在线侧,使用行式存储、键值层或专门构建的索引——任何能在目标并发下提供个位数毫秒级点查找的方案。特征存储模式——离线列式仓库与低延迟在线存储配对——并非等待被更快的列式引擎现代化掉的遗留产物;它正是问题的正确形态,而列式侧的GPU加速并不会改变某个工作负载属于接缝的哪一侧。
接缝本身才是Arrow应该存在的地方——作为交换格式,让离线列式流水线将刚计算出的特征批次传递给填充在线存储的进程,而无需经过JSON或定制二进制格式的序列化绕行。这是一个真实且有意义的胜利,只是与“看这个查询跑得多快”是不同的胜利。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。