多项式逼近加速LLM超越函数:GB200上提速最高8%
用短多项式替换GPU特殊函数单元上的超越激活函数,在Blackwell架构上实现最高8%端到端训练提速且精度损失可控。
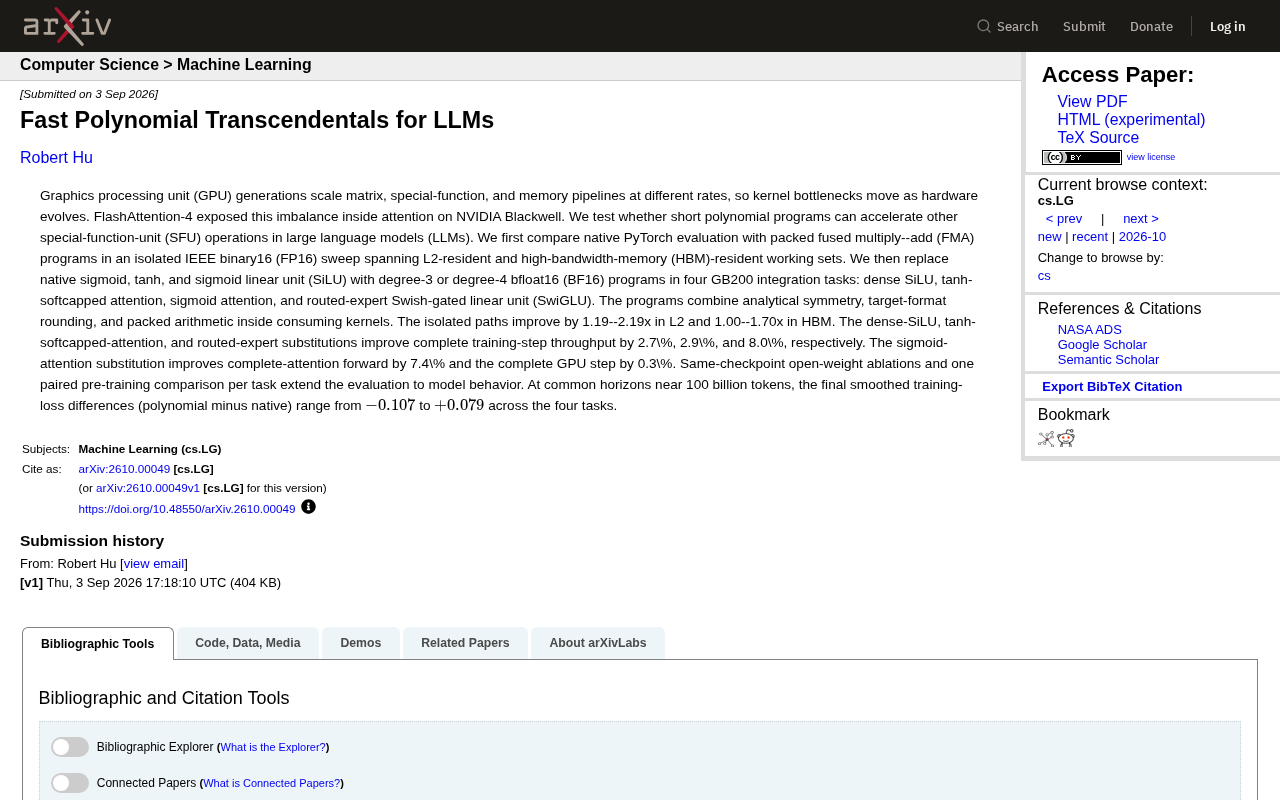
随着NVIDIA Blackwell等新代GPU上特殊函数单元(SFU)成为注意力与激活函数计算的新瓶颈,这篇论文提出用degree-3/4短多项式程序替换sigmoid、tanh、SiLU等超越函数,将计算负载从稀缺的SFU转移到供应充裕的FMA单元。隔离测试显示L2缓存场景下提速1.19–2.19倍,HBM场景1.00–1.70倍。在GB200平台四项集成任务中,路由专家SwiGLU端到端训练提升8.0%,tanh软封顶注意力提升2.9%,密集SiLU提升2.7%,而sigmoid注意力虽局部加速7.4%但全局仅提升0.3%——体现出收益与操作在整体流程中占比高度相关的规律。近1000亿token规模的预训练对比显示损失差异仅在-0.107至+0.079之间,精度扰动可控,传统"速度换精度"的顾虑在此方案上并不成立。
为什么超越函数成了GPU的新瓶颈
GPU的架构演进并不均衡。矩阵运算单元、特殊函数单元(SFU)和内存管线以不同速率扩展,这意味着随着硬件更新换代,内核的性能瓶颈会不断转移。换句话说,上一代GPU上不是问题的操作,到了新一代硬件上可能反而成了拖后腿的环节。
这篇arXiv新论文(arXiv:2610.00049v1)正是抓住了这一点。研究指出,FlashAttention-4在NVIDIA Blackwell架构上已经暴露了注意力机制内部的这种不平衡。既然注意力里存在这个问题,作者进一步追问:那些依赖特殊函数单元的其他操作——比如sigmoid、tanh、SiLU这些在大语言模型里无处不在的激活函数——是否也能通过更聪明的计算方式来加速?
用短多项式替换原生超越函数
核心思路相当直接:用短小的多项式程序去逼近这些超越函数,而不是调用GPU原生的特殊函数实现。多项式计算可以完全由融合乘加(FMA)指令完成,从而避开SFU这个瓶颈。
研究者设计的多项式程序融合了三个关键技巧:解析对称性(利用函数自身的数学对称性减少计算量)、目标格式舍入(直接面向BF16/FP16输出格式做舍入,避免精度浪费)以及打包算术(packed arithmetic,在消费内核内部批量处理)。这些程序被直接嵌入到使用它们的内核中,而非作为独立调用,这样能最大化吞吐收益。
在实现层面,作者分别测试了degree-3(三次)和degree-4(四次)的BF16多项式版本,用以权衡精度与速度。
超越函数(transcendental functions)是指无法用有限次代数运算表达的函数,指数函数、对数函数、三角函数均属此类。sigmoid、tanh、SiLU等激活函数本质上都依赖这类运算。GPU上的特殊函数单元(SFU,Special Function Unit)是专门处理这类运算的硬件电路,通常通过查表加插值的方式在少量时钟周期内给出近似结果。SFU的数量在GPU芯片上远少于普通CUDA核心或张量核心,因此当大量线程同时请求超越函数计算时,SFU极易成为吞吐瓶颈。
融合乘加(FMA,Fused Multiply-Add) 指令则是另一回事:它在单条指令内完成 a × b + c 运算,是GPU上数量最多、吞吐最高的基础算术操作,矩阵乘法的内积运算也依赖它。多项式求值(如霍纳法则:((a₃x + a₂)x + a₁)x + a₀)可以完全展开为FMA指令序列,从而将原本压在SFU上的负载转移到供应充裕的FMA单元,这正是本文方法的核心逻辑。
隔离测试:FMA程序的原始加速能力
在把方案塞进真实模型之前,研究团队先做了一组隔离的IEEE binary16(FP16)性能扫描,对比原生PyTorch求值与打包FMA程序的表现。测试覆盖了两种工作集场景:驻留在L2缓存的小数据集,以及驻留在高带宽内存(HBM)的大数据集。
结果呈现出明显的层级差异:
- L2驻留场景下,多项式路径带来 1.19–2.19倍 的提速;
- HBM驻留场景下,提速区间为 1.00–1.70倍。
这个差异符合直觉——当数据受限于内存带宽(HBM场景)时,计算优化的收益会被内存瓶颈部分抵消;而在计算密集、数据已经在缓存里的L2场景,减少SFU调用的收益就充分释放出来了。
GB200实战:四个集成任务的端到端收益
隔离测试证明了潜力,真正的考验在于完整训练流程。研究者在NVIDIA GB200平台上选取了四个有代表性的集成任务,用多项式程序替换原生实现:
训练吞吐提升
- 密集SiLU(dense SiLU):完整训练步吞吐提升 2.7%;
- tanh软封顶注意力(tanh-softcapped attention):提升 2.9%;
- 路由专家SwiGLU(routed-expert Swish-gated linear unit):提升 8.0%,这是四个任务中收益最高的;
- sigmoid注意力(sigmoid attention):注意力前向过程提升 7.4%,但由于该操作在整个GPU步骤中占比有限,完整GPU步仅提升 0.3%。
这组数据传递了一个重要信号:加速的实际价值取决于目标操作在整体计算中的占比。sigmoid注意力的局部加速相当可观(7.4%),但因为它在端到端流程里不是主导项,全局收益被稀释到几乎可以忽略。而路由专家SwiGLU之所以能带来8%的整体提升,正是因为专家混合(MoE)结构中这类门控激活的计算量足够大。
SwiGLU(Swish-Gated Linear Unit) 是目前主流大语言模型(如LLaMA、Gemma)前馈层的标准组件,其公式为 SwiGLU(x, W, V) = Swish(xW) ⊙ (xV),其中 Swish(x) = x · sigmoid(x),也常写作 SiLU。在混合专家(MoE) 架构中,每个token会被路由到少数几个"专家"子网络,每个专家内部均包含此类门控激活。由于MoE模型为追求参数效率而大量使用专家,门控激活的调用次数随专家数量线性增长,使得SwiGLU/SiLU的计算占比远高于稠密模型,这也解释了为何"路由专家SwiGLU"任务能获得8%这一最高端到端提升——SFU瓶颈在MoE场景下更为突出,优化收益因此被充分放大。
精度代价:模型行为是否受影响
加速的另一面永远是精度。用多项式逼近替换高精度原生函数,会不会损害模型质量?研究者通过两类实验来回答:相同检查点的开放权重消融实验,以及每个任务一组配对的预训练对比。
在接近 1000亿token 这一常见训练规模下,最终平滑后的训练损失差异(多项式减原生)落在 -0.107 到 +0.079 之间。注意这个区间同时包含正值和负值——也就是说,在某些任务上多项式版本的损失甚至略低于原生实现,整体差异处于一个相当窄的范围内。
这意味着对大多数实际场景而言,多项式逼近带来的精度扰动是可控的,并不会系统性地恶化模型表现。这让"用速度换精度"的传统担忧在这个具体方案上显得不那么成立。
多项式逼近的精度由逼近阶数和系数优化方法共同决定。论文中的degree-3和degree-4多项式系数并非随意选取,而是通过最小化目标格式(BF16/FP16)下的最大误差(minimax approximation)求得,并直接针对量化到低精度后的舍入行为进行校准。这与传统的泰勒展开或切比雪夫近似有所不同:后者以连续实数误差为目标,而本文方法将离散的低精度格点纳入优化,使得在BF16/FP16实际可表示的值上误差最小。训练损失差异落在极窄区间(-0.107至+0.079)的原因之一,正是这种面向目标格式的精细化设计——多项式在实际推理精度下的行为与原生SFU实现高度一致,而非在更高精度空间中才表现良好。
对LLM工程实践的启示
这项工作的意义不只在于几个百分点的数字。它提供了一种应对GPU架构不平衡的通用方法论:当硬件某一类单元(这里是SFU)成为瓶颈时,可以把负载转移到更充裕的单元(FMA/矩阵管线)上,通过多项式这种可在FMA上高效执行的数学形式实现。
随着MoE架构日益流行、注意力变体不断增多,激活函数和门控操作的计算占比只会越来越高。在这个趋势下,针对特殊函数单元的内核级优化会成为训练效率竞争中一个容易被忽视但回报可观的战场。8%的端到端训练提速,对动辄数千卡、数周训练周期的大模型而言,意味着实打实的成本节约。
不过也要客观看待:这些收益高度依赖具体操作在流程中的占比,以及硬件代际。论文本身就强调瓶颈会随硬件演进而移动,因此这类优化需要针对每一代GPU重新评估,而非一劳永逸。
相关推荐
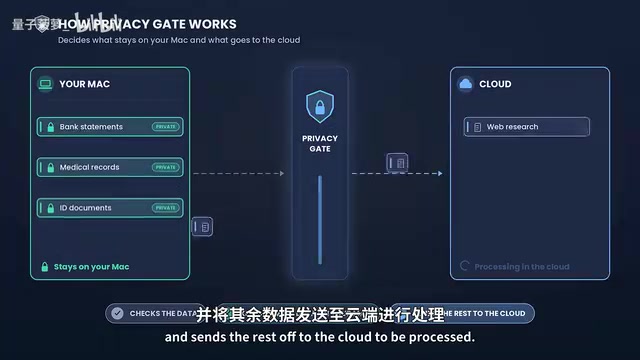
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
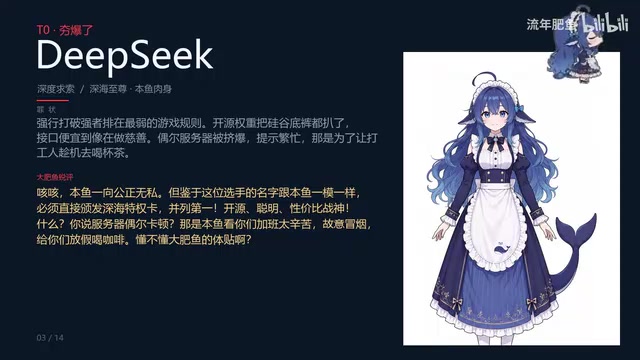
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。