多智能体代码评审何时可信?无标签检测让AI学会"拒绝猜测"
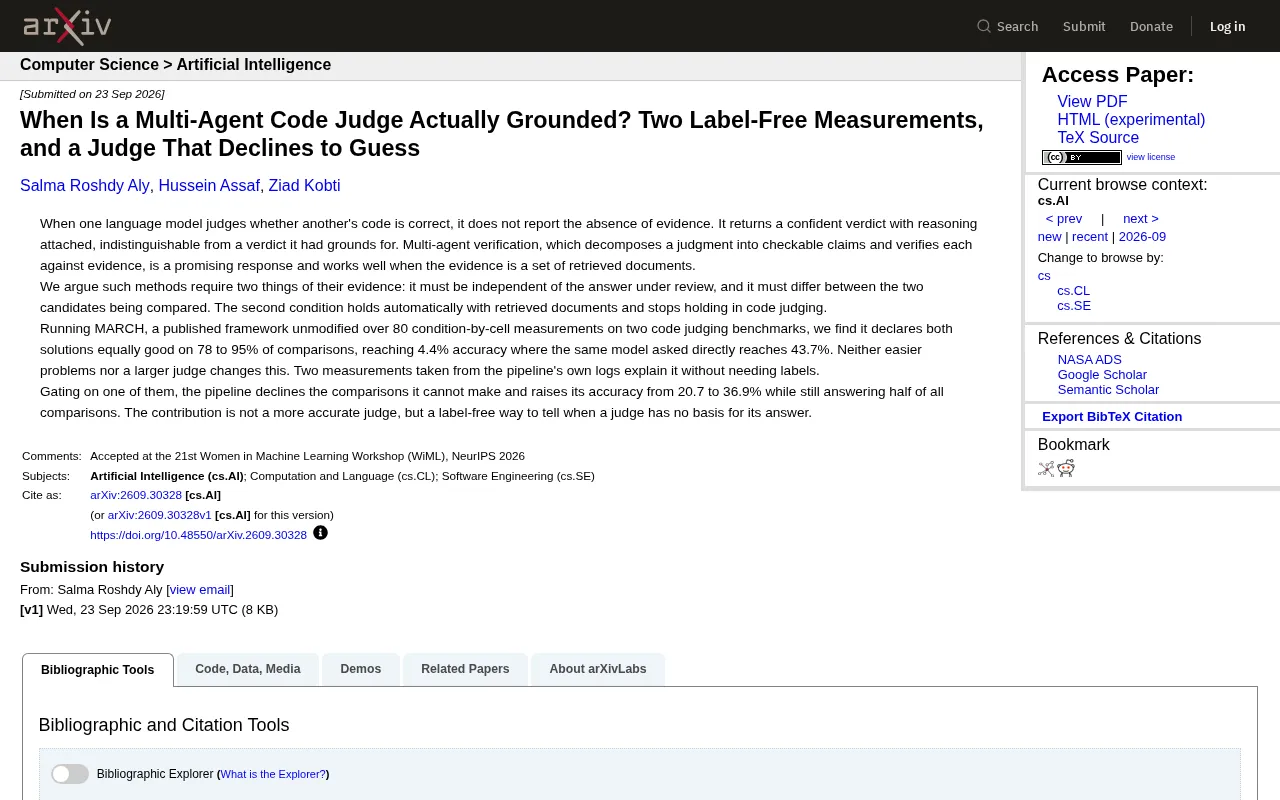
多智能体验证框架在代码评判中因"证据无法区分候选"而系统性失灵,引入无标签门控机制可让评审系统学会主动弃权。
这篇arXiv论文揭示了多智能体验证方法移植到代码评判场景时的结构性缺陷:该方法要求证据既独立于被评审答案、又能区分两份候选代码,而后者在代码评判中几乎无法满足。实测中,MARCH框架在78%至95%的对比中判定"平局",准确率仅4.4%,远低于直接提问的43.7%;换更大模型或降低题目难度均无法改善这一问题。研究者进一步提出两种仅凭系统日志就能运作的无标签测量指标,用以诊断评判是否有可靠依据,并在此基础上引入"门控"机制,让系统在证据不足时主动放弃作答,将准确率从20.7%提升至36.9%。论文的核心贡献不是打造更精准的评判器,而是提供了一套识别"评判器何时毫无依据"的方法论,为构建可信自动化代码评审系统提供了新视角。
当一个语言模型去评判另一个模型生成的代码是否正确时,它从不会告诉你"我其实没有依据"。它总是给出一个自信的结论,附带看似合理的推理过程——而这个"有根据的判断"与"凭空猜测的判断"在外观上毫无区别。这正是当前多智能体代码评审(multi-agent code judging)面临的核心信任危机。
一篇新发布的 arXiv 论文(arXiv:2609.30328)对这一问题提出了尖锐的分析:多智能体验证方法在检索类任务中表现出色,但当把它照搬到代码评判场景时,会出现系统性失灵。研究者不仅诊断了失灵的根源,还提出了两种无需标注(label-free)的测量方法,让评审系统学会在没有依据时主动"弃权"。
多智能体验证的两个隐含前提
多智能体验证的核心思路是:把一个笼统的判断拆解成若干可核查的具体主张(claims),再逐条对照证据进行验证。这种"分而治之"的方式,在证据来自检索文档时效果很好——比如判断某个事实性回答是否正确,可以逐句去检索库里找支撑。
论文指出,这类方法对证据其实有两个隐含要求:
第一,证据必须独立于被评审的答案本身。 也就是说,证据不能是从答案里推导出来的,否则就成了自证。
第二,证据必须能区分正在比较的两个候选答案。 只有当两份候选内容对应的证据存在差异时,验证才能给出有意义的裁决。
关键差异在于:在检索文档场景中,第二个条件天然成立——不同答案会命中不同的文档片段。但在代码评判中,这个条件失效了。两份代码可能功能等价、逻辑相近,从中抽取的"证据"高度重叠,验证系统因此无法拉开二者的差距。
多智能体验证(Multi-Agent Verification)的思路源自自然语言处理中的"声明分解+检索验证"范式,其代表性实现是将一段长文本拆解为若干原子性事实声明(atomic claims),再逐条用检索增强生成(RAG)系统去外部语料库中寻找支撑或反驳证据。这种方法在事实核查(fact-checking)领域表现突出,因为外部文档天然扮演了独立"仲裁者"的角色。然而,将同样的流程移植到代码评判时,"外部证据"从何而来便成了根本性问题:代码的正确性不依赖外部文档,而依赖执行语义和逻辑等价性,这类证据很难通过检索获得,往往只能从代码本身推断——而这恰恰违反了"证据独立于答案"这一前提。
MARCH 框架的实测失灵
为了验证这一论断,研究者在两个代码评判基准上,对已发表的 MARCH 框架进行了未做任何修改的原样运行,覆盖了 80 组"条件×单元"(condition-by-cell)的测量。
结果相当惊人:MARCH 在 78% 到 95% 的对比中判定两份解法"同样好",无法做出有效区分。在这种情况下,其准确率被压低到 4.4%——而同一个模型如果被直接问"哪个更好",准确率能达到 43.7%。
换句话说,把评判拆解成多智能体验证流程,非但没有提升判断质量,反而让准确率暴跌了近十倍。更值得警惕的是,这个问题无法通过"降低题目难度"或"换更大的评审模型"来缓解——研究者尝试了这两条常见的优化路径,结果都没有改变失灵的格局。
这说明问题不是模型能力不够,而是方法论层面的结构性缺陷:当证据无法区分候选时,再强的模型也无从下手。
MARCH(Multi-Agent Reasoning and Claim Hierarchy)是一个已发表的多智能体验证框架,设计初衷是将复杂判断分层拆解:顶层智能体将评审任务分解为子声明,底层智能体各自负责验证单条声明,最终汇总得出整体判断。这种层次化分工的理论优势在于降低单个智能体的认知负担,并通过并行验证提高可靠性。然而,层次化分工本身并不能创造出原本不存在的区分性证据——当两份代码的行为高度相似时,每个底层智能体都会面临"无从下手"的困境,最终大量声明被标记为"无法判断",导致顶层汇总只能输出"平局"。这说明框架的架构优化无法弥补输入证据的根本性缺失。
两个无标签测量:从日志本身诊断问题
论文最有价值的贡献,在于提出了两种从流水线自身日志中提取的测量指标,无需任何真值标注就能解释上述失灵现象。
这一点对工程实践意义重大。真实场景中,我们往往拿不到"标准答案"来评估评审系统是否可靠——如果有标准答案,就不需要评审了。而无标签测量意味着:仅凭系统运行过程中产生的日志,就能判断某次评判到底有没有可靠依据。
研究者用这两个测量指标,成功解释了为什么 MARCH 会在绝大多数对比中给出"平局"判定——不是因为两份代码真的一样好,而是因为验证流程根本没有拿到能区分它们的证据。
让评审系统学会"拒绝猜测"
基于其中一个测量指标,研究者引入了"门控"(gating)机制:当系统检测到自己缺乏做出区分的依据时,就主动放弃这次对比,而不是硬着头皮给一个自信但无根据的结论。
这种"知之为知之"的策略带来了实实在在的改善:准确率从 20.7% 提升到 36.9%,同时系统仍然回答了全部对比中的一半。也就是说,它放弃了那些它本就答不好的问题,把精力集中在有依据的判断上。
研究者特别强调了一点:本文的贡献不是造出一个更准确的评判器,而是提供了一种无标签的方法,来判断评判器何时对自己的答案毫无依据。 这是一个视角上的转变——从追求"答得更对",转向识别"什么时候不该答"。
门控(Gating)机制是一种在机器学习系统中广泛使用的"选择性激活"设计模式:系统在输出结论前先评估自身的置信度或证据充分性,只有满足阈值条件时才给出答案,否则拒绝作答或将样本标记为"需要人工介入"。这与混合专家模型(Mixture of Experts)中的路由门控、以及主动学习(Active Learning)中的"不确定性采样"思想一脉相承。在评审场景中引入门控的关键挑战是:不能依赖真值标注来校准阈值(否则问题就退化为有监督分类)。本文的创新在于用无标签测量指标(从运行日志中提取的信号)作为门控依据,使得该机制在完全无标注的生产环境中也可部署,而无需为每个新任务重新收集标注数据。
对 AI 评审系统的启示
这项研究击中了当前"LLM as judge"范式的一个软肋:语言模型的自信度与其判断的可靠性之间往往并不挂钩。一个模型可以对完全没有依据的裁决给出滔滔不绝的理由,这种"幻觉式自信"在自动化评审、代码审查、模型对齐等场景中都是潜在风险。
对于正在构建自动化代码评审或多智能体验证系统的团队,这里有几条可以借鉴的思路:
- 多智能体验证并非万能,在证据无法区分候选的任务上可能适得其反;
- 与其一味追求更强的模型,不如建立机制去识别"证据不足"的场景;
- 让系统具备主动弃权的能力,可能比强行输出结论更有价值。
这篇论文没有承诺一个完美的评判器,但它提出了一个更诚实的框架——让 AI 学会在没有底气时说"我不确定",或许才是可信自动化评审的第一步。
相关推荐
用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。
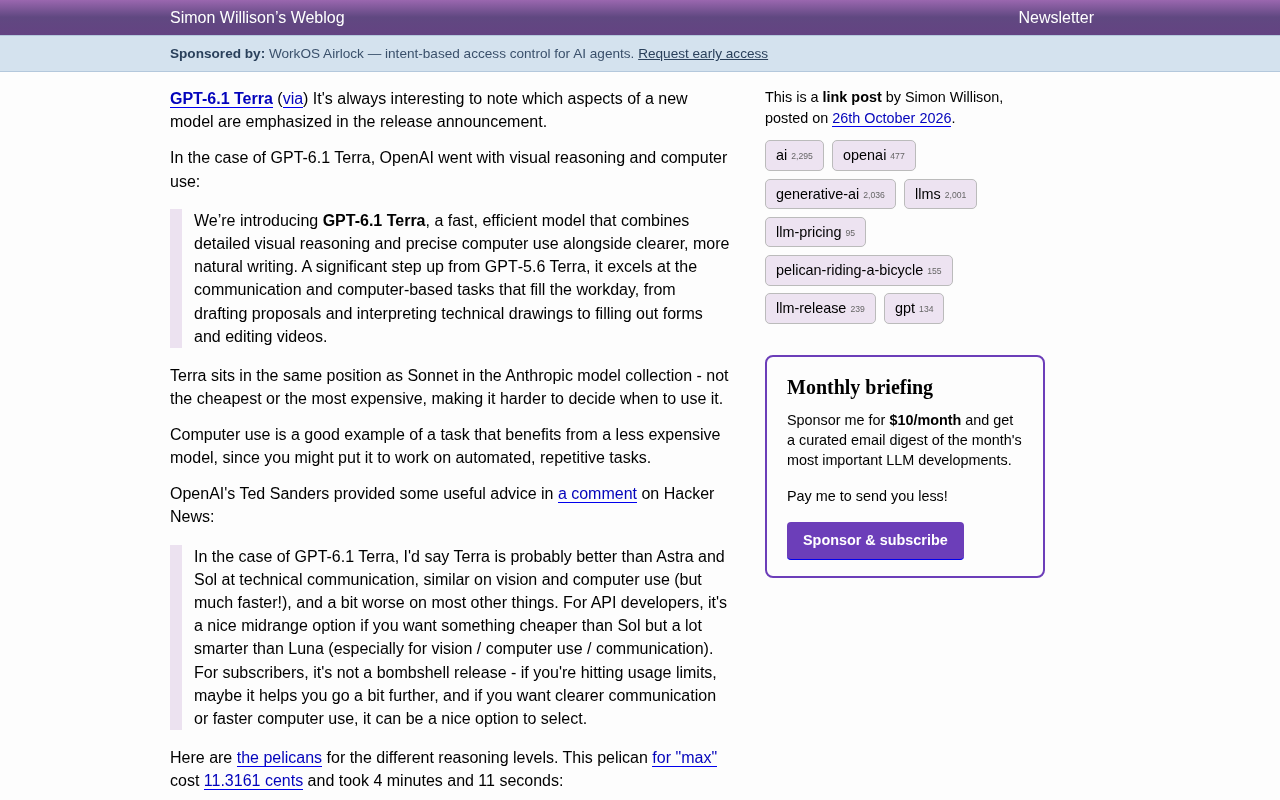
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。
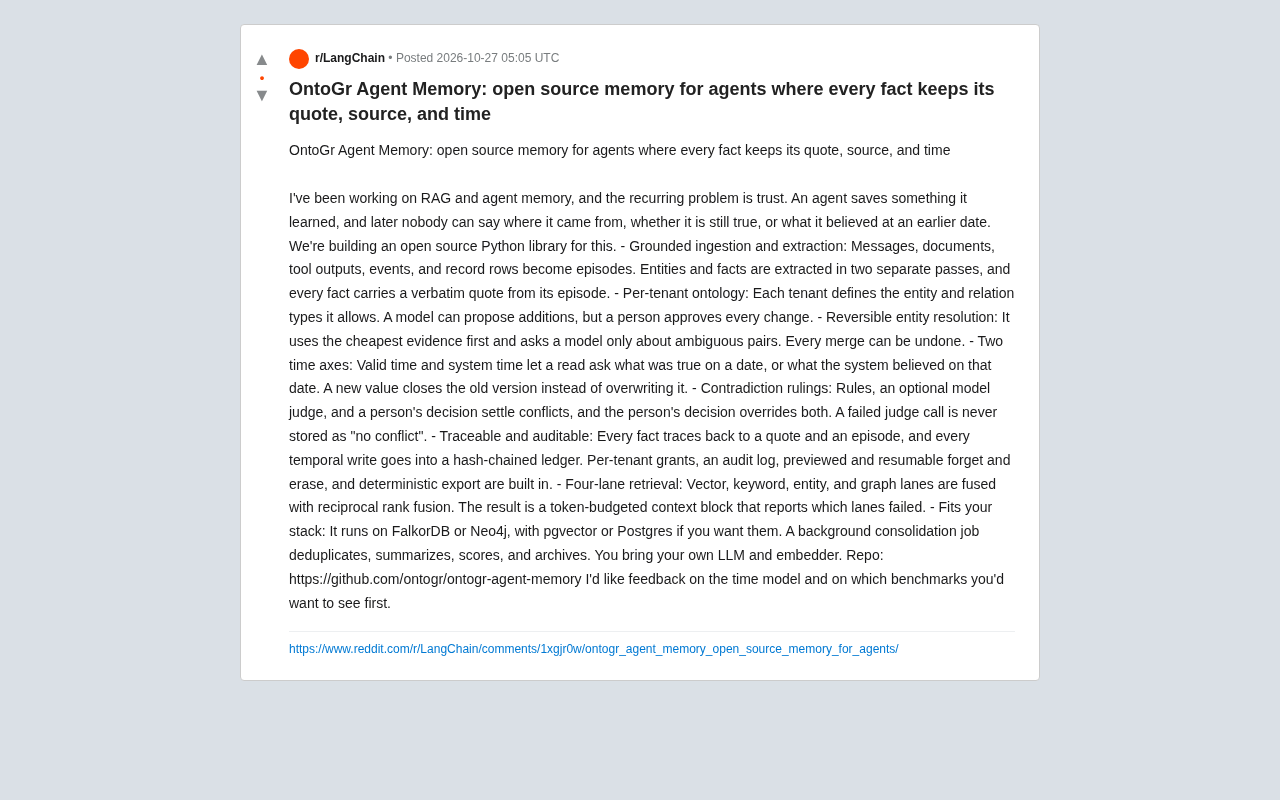
OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。