EmbeddingGemma 2实测:手机就能跑的多模态检索模型

EmbeddingGemma 2是首个将文本、图像、音频、视频统一进同一向量空间且可在手机运行的开源多模态embedding模型。
EmbeddingGemma 2是Google推出的开源多模态embedding模型,参数量不足十亿,能将文本、代码、图像、视频和音频映射到同一向量空间,支持跨模态检索、分类与聚类。模型采用共享骨干(2.7亿参数Gemma文本模型)加可选视觉/音频编码器的模块化设计,支持Matryoshka可变维度,完整版仅需约567MB内存,可在Pixel手机上运行。实测中图片检索正确率排第一约86%,支持百余种语言及以图搜图;视频和文档检索亦表现可用;语音可直接跨模态匹配文字查询,无需转写。主要短板是环境音效检索(准确率仅24%)。对于需要构建多模态RAG、私有相册搜索或Agent记忆系统的开发者,这是目前最值得优先尝试的开源选择。
Google推出的EmbeddingGemma 2,把文本、代码、图像、视频和音频映射进同一个向量空间,而且模型小到能在手机上运行。对关注多模态RAG(检索增强生成)的开发者来说,这是一个值得认真研究的开源模型。它不只是用于检索,还能用同一个模型完成跨模态的分类与聚类。
为什么需要多模态检索
传统的RAG几乎都建立在文本搜索之上:把文档切块、把每一块转成embedding,查询进来时找到向量空间里最接近的块。但真实世界的数据远不止文本——手机里的照片、屏幕录像、语音备忘录、会议记录、幻灯片、扫描文档,纯文本检索对这些内容完全"看不见"。
举个例子,你想在一段视频里找到"狗叼住飞盘"的画面,而视频本身没有任何文字描述,基于文本的检索根本无法返回这段内容。对AI Agent而言这尤其关键,因为Agent的记忆能力取决于它能检索到什么,多模态检索是搜索类应用的核心基础。
过去是怎么解决的
一种做法是"把一切转成文本":对每张图跑图像描述模型,对每段音频跑语音转文字,再对文本做embedding。问题是你串联了三个模型,更致命的是你只能检索到描述或转录中写下来的内容。如果描述模型写的是"公园里的一只狗"却没提到飞盘,你的搜索就会漏掉它。
Google在Gemini Embedding的论文中量化了这个现象:直接对音频做embedding在声音检索基准上得分73.99,而先转录成文本再embedding只有70.40。
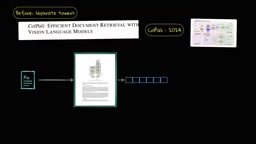
2021年的CLIP用两个独立模型分别处理图像和文本,让照片和它的描述在空间里靠近,这让文搜图效果很好,但只覆盖一对模态且训练用的是短描述。2023年Meta的ImageBind把思路扩展到六种模态,ColPali则开始对页面截图做embedding来跳过OCR,但它每页存很多向量,索引很快就会变得巨大。最新的思路是用单一骨干网络读取所有模态——Gemini Embedding就是这样设计的,但它是API模型。EmbeddingGemma 2把同样的设计下放到十亿参数以内,并且开放权重。
CLIP(Contrastive Language-Image Pre-training)由OpenAI于2021年提出,核心思想是对比学习:将图像编码器与文本编码器联合训练,使"一只猫的照片"和"一只猫"这段文字在向量空间里距离很近,而无关图文对距离很远。这种方式开创了零样本图文匹配的先河,但架构上天然局限于两种模态,且训练语料以英文短描述为主,对长文本和复杂语义的覆盖有限。ImageBind的进步在于引入了音频、深度图、热成像、IMU传感器信号,通过把所有模态都对齐到图像这一"枢纽"来实现六模态统一空间,但它依然依赖于把图像作为中间媒介,而非真正的端到端多模态骨干。ColPali则另辟蹊径,将文档页面直接截图输入视觉语言模型,为每个图像区块生成多个局部向量(类似token级表示),从而跳过OCR和版面解析,但代价是每页需要存储数百个向量,对大规模文档库的索引体积极为不友好。
模型内部是怎么工作的
Embedding本质上是一串能捕捉输入含义的数字,意思相近的输入会得到相近的数字。由于文本模型无法直接读取像素或声波,EmbeddingGemma 2在前端配了两个小编码器:视觉编码器1.7亿参数,把图像或视频帧转成token;音频编码器3亿参数,对音频做同样的事。这些token和文本token进入同一个序列。
从模型视角看,一张照片不过是输入里多出来的几百个token。默认情况下,一张图占280个token,一个视频帧占140个,一秒音频约25个token。上下文窗口是8192个token,所以一次输入大约能容纳29张图、58个视频帧,或约5分半钟的音频。你甚至可以把一个产品的描述、照片和短视频一起embedding成一个向量。
所有这些都通过共享的骨干网络——基于Gemma的2.7亿参数文本模型。最后模型对每个token的输出做平均池化(mean pooling)得到一个向量。Google尚未发布该模型的技术报告,但表示它采用了与Gemini Embedding相同的技术,即对比训练:把成对的内容(照片和它的描述、片段和它的转录)拉近,把其他内容推远,在海量混合数据集上重复,所有模态最终落到同一张图上。
对比训练(Contrastive Training)是当前多模态embedding模型的主流训练范式。其基本设置是构造"正对"(如一张照片与对应的文字描述)和"负对"(同批次中无关联的照片-文字组合),优化目标是让正对的向量余弦相似度趋向1、负对趋向0,常用的损失函数是InfoNCE。关键挑战在于"难负样本"(Hard Negatives)的选取:如果负样本太容易区分,模型学不到精细语义;而真正相似但未配对的样本如果被当作负样本,会产生噪声梯度。大规模训练时还需要极大的批次或专门的负样本挖掘策略。Google未公开EmbeddingGemma 2的技术报告,但其参考的Gemini Embedding论文表明该系列模型使用了经过精心筛选的多语言、多模态配对数据,并采用了课程学习(先易后难)的训练调度。平均池化(mean pooling)在序列末尾对所有token的隐状态取均值作为最终向量,相比只取[CLS]位置的表示,对较长输入更稳定。
两个关键的部署设计
第一个是Matryoshka表示学习。模型训练时让256、128甚至更少维度仍能作为独立embedding使用,意味着你可以把向量切成更短的版本。更小的向量意味着更小的索引。但有代价:在Google自己的数据里,文本在128维时几乎不变,多模态分数却从59掉到约46。
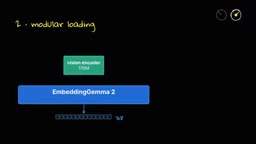
第二个是模块化加载。视觉和音频编码器是可选的。只有文本和代码时加载2.7亿参数;加视觉是4.7亿;加音频是5.7亿;完整模型7.4亿。它们共享同一个向量空间,所以你可以用完整模型索引照片,再用小模型在手机上搜索。配合量化,Google称纯文本版在Pixel手机上约需191MB内存,完整模型约567MB。
Matryoshka表示学习(Matryoshka Representation Learning,MRL)得名于俄罗斯套娃,由Kusupati等人于2022年提出。其核心做法是在训练时对嵌入向量的不同前缀长度(如2048、1024、512、256、128维)同时施加监督损失,迫使模型把最重要的语义信息集中在向量的头部维度。这样一来,同一个模型输出的完整向量可以被直接截断使用,无需重新训练专门的小维度模型。在实际部署中,这意味着可以用短向量构建粗粒度的第一阶段检索(速度快、存储省),再用完整向量对候选结果做精排,实现"召回-精排"两级架构,兼顾延迟与精度。EmbeddingGemma 2中多模态任务在小维度下掉分更明显,是因为跨模态对齐所需的信息量本身比纯文本语义更大,压缩空间相对有限。
实测:Colab里跑一遍
作者在免费T4 GPU的Colab上运行了约15分钟。有两个坑值得记住:不要用float16跑这个模型,模型卡明确说会激活溢出,T4也不原生支持float16,结果会得到NaN或错误embedding,应该用float32,新GPU用bfloat16。
测试数据包括1000张带人工描述的Flickr照片、50段ESC-50日常声音、开源电影Big Buck Bunny的前五分钟,以及Attention is All You Need论文PDF。
图片检索表现最亮眼。每张照片embedding一次(约8分钟),之后每次搜索只需一次文本embedding加一次比较。在5000个带标准答案的查询中,正确照片排第一的比例约86%,进入前五的比例约97%——对这个体量的模型相当惊艳。得益于Gemma的多语言能力,文本侧支持100多种语言,德语和西班牙语查询也能返回正确结果。甚至查询本身也可以是图片:用一张冲浪照查询,返回的是其他冲浪和滑水的照片,匹配的是"人在水上踩板"而非单纯的蓝色。
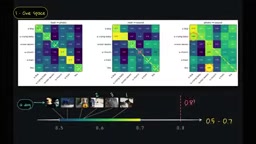
语音搜索展示了跨模态能力:生成一段"一只狗跳进湖里"的语音直接输入模型,返回的四张照片与输入同样文字时完全一致,无需语音转文字。
短板:环境音与小维度
短板集中在环境音效上。在50段日常声音的测试中,正确片段排第一的比例只有24%(随机猜测为2%)。笑声能找到笑声、冲马桶能找到马桶,但"狗叫"被返回成乌鸦、"下雨"被返回成风声。音频编码器在语音上最强,这与语音demo的表现一致。如果你需要检索音效或环境声,务必先在自己的片段上测试。
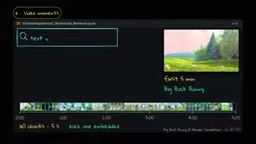
视频检索则相当可用:把前五分钟切成5秒片段逐段embedding,默认每秒看一帧,文本查询能返回时间戳,"树枝上展翅的鸟"落在15秒,"紫色蝴蝶"落在3分20秒,全程无需任何字幕。文档检索同样有效,把论文每一页转成图片直接embedding,查询"Transformer架构图"返回第三页那张著名插图,"多头注意力"返回第四页。
关于Matryoshka的实际影响:原始维度下正确照片排第一86%,256维降到84%但存储少三倍,128维则跌到75%——到某个点精度下降会很明显,需要在自己的场景权衡。
结论
EmbeddingGemma 2用同一个十亿参数以内的开源模型,在照片、视频和文档检索上都做得很好,还能用完整模型建索引、用轻量文本模型在手机上检索。对于正在构建搜索或RAG应用的开发者,这是目前第一个值得优先尝试的开源多模态embedding模型。音效检索尚未成熟,但模型可以针对自己的应用做微调。它能在手机上运行、覆盖多模态的特性,为本地化的私有相册搜索、Agent记忆等场景打开了相当大的想象空间。
相关推荐

丽笙酒店接入ChatGPT:AI重塑旅行预订体验
丽笙酒店集团联手埃森哲,基于OpenAI技术打造ChatGPT插件,让旅行者在对话中查找、比较并预订酒店。本文解析这一举措背后的对话式商务趋势与行业影响。

用乐高轮子+开源Robium技能,教Stack-chan学会自主驾驶
开发者将M5Stack Stack-chan改装成轮式机器人,用乐高电机和开源Robium技能仓库训练ACT策略,通过模仿学习实现自主循迹驾驶。本文解析其硬件搭建、数据采集与AI辅助开发全流程。

Pinrail:让编码智能体排队等你审核的桌面收件箱
Pinrail 是一款面向编码智能体的桌面收件箱工具,让 AI Coding Agent 在需要审核时排队等待开发者确认,实现人在回路的可控协作。本文解析其产品理念、收件箱隐喻设计及早期局限。