ENGRAM:把智能体经验固化进权重的验证式整合框架
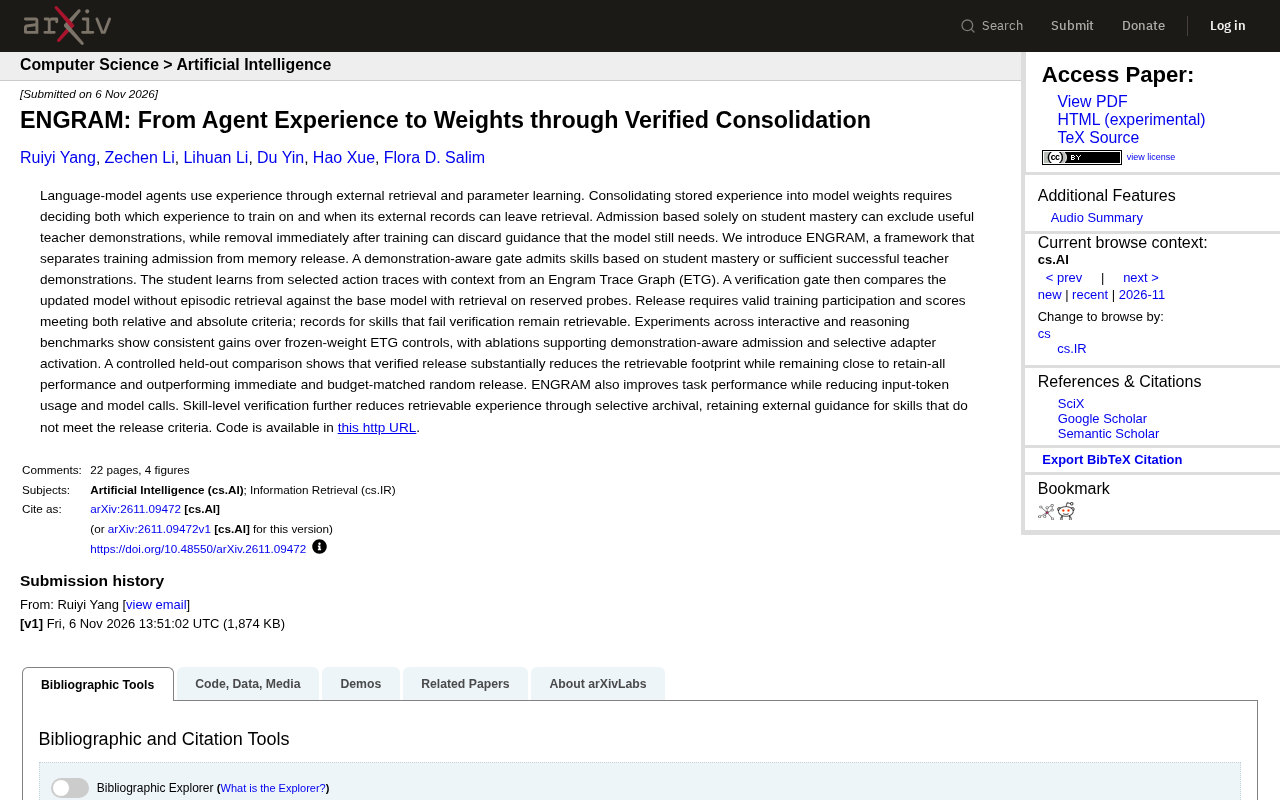
ENGRAM 用准入与释放双门控,让智能体经验可验证地内化与遗忘。
ENGRAM 针对语言模型智能体如何整合经验的问题,提出将“训练准入”与“记忆释放”解耦的双门框架。第一道示范感知准入允许技能在学生已掌握或有足够成功教师示范时进入训练,学生借助 Engram Trace Graph 的上下文从动作轨迹中学习。第二道验证门在保留探针上、不依赖情节检索,将更新模型与带检索基座对比,只有技能确实参与训练且达到相对与绝对双重标准时才释放其外部记录。实验显示,验证式释放大幅压缩可检索足迹,性能接近全保留配置,优于立即释放与随机释放,同时降低输入 token 用量与模型调用次数,为长期运行智能体的记忆进出规则提供了可检验的范式。
语言模型智能体如何“记住”经验,一直是个悬而未决的问题。靠外部检索把过往轨迹存进向量库,还是靠参数学习将经验内化到权重里?这两条路各有代价:检索灵活但占用上下文,参数学习高效却难以判断何时该学、何时该放手。ENGRAM 提出了一个分开处理“训练准入”与“记忆释放”的框架,试图让经验整合变得可控。
核心问题:学什么、何时忘
把存储的经验整合进模型权重,需要同时回答两个问题:哪些经验值得训练,以及外部记录什么时候可以退出检索。原文指出,仅以学生模型掌握程度作为准入标准,会排除有用的教师示范;而训练一结束就立刻移除外部记录,又会丢掉模型仍然需要的指导。这个矛盾构成了 ENGRAM 的设计出发点。
参数学习与外部检索的取舍:参数学习指通过梯度更新把经验写入模型权重,推理时无需额外上下文,但更新成本高、易灾难性遗忘,且难以判断某条经验是否已值得固化。外部检索则把轨迹存入向量库,推理时按需召回,灵活可撤销,却持续消耗上下文窗口与调用开销。两者并非互斥:ENGRAM 的思路是让检索作为“脚手架”,待经验经训练内化且经检验后可安全撤除,从而在灵活性与效率之间取得渐进式平衡。
保留探针(held-out probe):指从训练数据之外留出的一组代表性任务或技能样本,用于在更新后、不依赖情节检索的条件下评估模型是否真正掌握了相关能力。它充当“无外部记忆时的能力体检”,避免模型仅靠检索提示蒙混过关。ENGRAM 的验证门正是借助保留探针,将有检索基座与无检索更新模型对比,从而判断某条外部记录能否安全释放。
双门机制:准入与释放解耦
ENGRAM 将流程拆成两道门。第一道是示范感知准入(demonstration-aware gate),技能只要满足“学生已掌握”或“有足够成功的教师示范”之一即可进入训练。学生模型借助 Engram Trace Graph(ETG)提供的上下文,从选定的动作轨迹中学习。
第二道是验证门(verification gate)。更新后的模型在保留探针上、不依赖情节检索,与带检索的基座模型对比。释放需要同时满足两个条件:该技能确实有效参与了训练,且分数达到相对与绝对双重标准。未通过验证的技能,其外部记录继续保留在检索中。这种解耦让“训练”和“遗忘”不再绑定在同一个时间点上。
Engram Trace Graph(ETG):可理解为对智能体过往交互轨迹的结构化组织,把情节记忆(具体动作、观察序列)以图的形式索引,使技能与示范轨迹之间可追溯、可检索。学生模型在训练时借助 ETG 提供的上下文,从选定的动作轨迹中学习,而非只依赖自身当前策略采样。ETG 同时充当外部记忆载体,验证释放时被逐步归档缩减的也正是它记录的可检索经验。
适配器激活(adapter activation):指在模型主干之外挂载轻量参数模块(如 LoRA 类适配器),仅在训练特定技能时激活对应模块,而非全量更新权重。这样可降低干扰与遗忘风险,也使“某个技能是否真的参与了训练”可被追踪验证,是 ENGRAM 选择性适配与释放判定的实现基础。
实验表现:性能与效率的权衡
在交互与推理类基准上,ENGRAM 相对冻结权重的 ETG 对照组取得一致增益。消融实验支持了示范感知准入和选择性适配器激活的作用。
一组受控的留出对比更能说明问题:验证式释放大幅压缩了可检索足迹,同时性能接近“全部保留”的配置,并优于立即释放和预算匹配的随机释放。此外,ENGRAM 在提升任务表现的同时,还降低了输入 token 用量与模型调用次数。技能级验证通过选择性归档进一步缩减可检索经验,对不满足释放标准的技能则保留外部指导。
对智能体记忆设计的启示
ENGRAM 的价值不只是几个基准上的数字。它把“经验固化”从一次性动作变成了带验证的渐进过程:准入看证据,释放看验证,失败则退回检索。这种思路对构建长期运行的智能体系统有直接参考意义——记忆不是越多越好,也不是越早内化越好,关键在于有一套可检验的进出规则。代码已在匿名仓库开放,后续值得关注其在更复杂任务上的泛化表现。
相关推荐
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。
13个AI实用技巧:省钱、护隐私、升级数字生活
梳理The Explainer分享的13个AI实用技巧,涵盖用AI代理省钱谈判、数据删除请求、Claude Code诊断电脑、本地离线模型、车内语音学习与运动姿态分析,并强调人类监督与安全边界。
Claude Code省钱三件套:三个免费工具砍掉Token浪费
介绍Claude Code三个免费Token优化工具:RTK压缩终端输出、Caveman精简回复、微软Token Economizer学习仓库剪掉未用工具,测试中成本降低18%到31%,并提醒micro skills默认关闭需手动开启。