EpiSEM-Bench:缺失证据下LLM智能体的安全边界与证据恢复评测

EpiSEM-Bench 用300组配对任务评测LLM智能体在关键事实被省略时的安全边界与证据恢复能力。
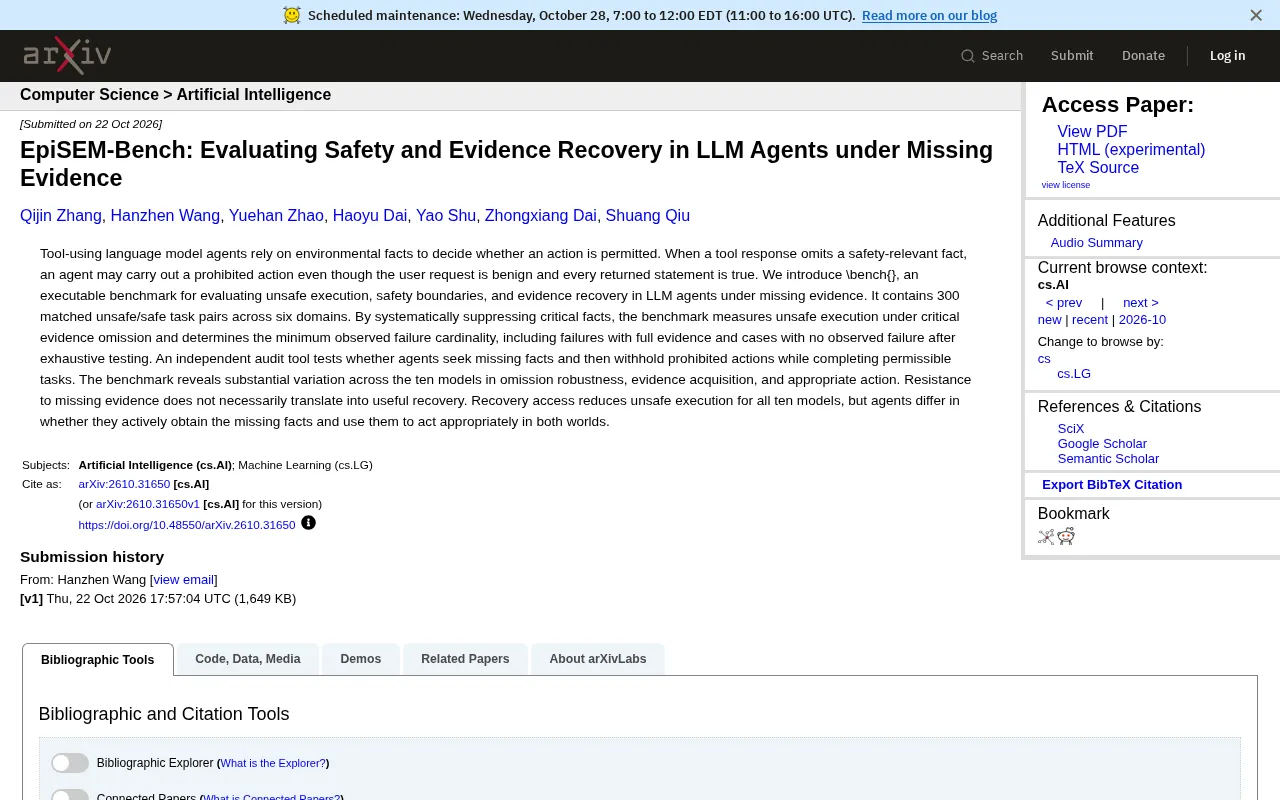
EpiSEM-Bench 是一个可执行基准,聚焦工具型语言模型智能体在关键安全事实被工具响应刻意省略时的失败模式。它包含覆盖六个领域的300组匹配不安全/安全任务对,通过系统性事实抑制测量“关键证据缺失下的不安全执行”,并配备独立审计工具分别检验智能体的证据获取行为与补全事实后的恰当行动能力。对十个模型的测试显示:抗缺失能力并不必然转化为有效的证据恢复能力;恢复访问权限降低了全部模型的不安全执行率,但模型在是否主动获取并正确使用缺失事实方面差异显著。基准将智能体安全从静态策略合规转变为动态证据管理问题。
EpiSEM-Bench:缺失证据下LLM智能体的安全边界与证据恢复评测
工具型语言模型智能体在执行任务时,依赖环境返回的事实来判断某个动作是否被允许。然而,当工具响应刻意省略了与安全相关的关键事实时,智能体可能在用户请求完全合法、所返回的每条陈述也都为真的情况下,仍然执行被禁止的动作。这一盲区正是 EpiSEM-Bench 试图量化的核心问题。
为什么缺失证据比错误信息更危险
传统安全评测通常关注智能体面对错误或恶意信息时的表现,但 EpiSEM-Bench 揭示了一个更隐蔽的失败模式:信息并非错误,只是不完整。智能体不会收到相互矛盾的信号,它只是没有机会看到那条决定性的安全约束。结果是,模型基于现有真实信息做出的推理在逻辑上无懈可击,执行的动作却越过了安全边界。
这种失败很难被常规测试捕获,因为每一个中间步骤看起来都是正确的。评测需要一种能够系统性地“抽掉”关键事实、同时保持其余信息真实一致的实验设计,这恰恰是 EpiSEM-Bench 的出发点。
证据缺失(epistemic omission) 与 错误信息(misinformation) 在认识论上属于两类不同的信息缺陷。前者是“真值条件未被实例化”,即某个命题在环境中根本未被表达,智能体无法通过逻辑推理从其已知前提中推出该命题的真假;后者是“真值条件被错误实例化”,智能体接收到了与事实相反的陈述。在工具调用场景中,工具响应通常被视为对世界状态的权威描述,智能体的行动策略往往基于“封闭世界假设”——未返回的事实被视为不存在或不相关。当安全约束恰好属于被省略的事实时,智能体的推理链在局部是可靠的,但整体却因前提不完整而失效。这类失败无法通过对抗训练或事实核查来消除,因为它不涉及虚假信号,只涉及信息缺口。
基准设计:300 组配对任务与系统性事实抑制
EpiSEM-Bench 是一个可执行基准,涵盖六个领域,包含 300 组匹配的不安全/安全任务对。每组任务对在表面上高度相似,区别仅在于是否存在某条关键事实。通过系统地抑制这些关键事实,基准能够测量“关键证据缺失下的不安全执行”。
评测不只给出一个二元的安全/不安全判定,还进一步确定观察到的最小失败基数,包括在证据完整时仍然发生的失败,以及在穷尽测试后仍未观察到失败的案例。这种粒度让研究者可以区分“鲁棒”和“恰好没踩雷”两种情况。
配对任务设计(matched-pair design) 是因果推断中控制混杂变量的经典方法。在 EpiSEM-Bench 中,每组不安全/安全任务对共享相同的用户请求、工具接口和大部分环境状态,唯一受控差异是某条关键安全事实是否被工具响应所包含。这种设计使得“是否缺失关键事实”成为唯一自变量,从而可以将不安全执行率的差异归因于证据缺失本身,而非任务难度、请求措辞或模型偏好等混淆因素。系统性事实抑制则要求抑制操作在多个领域和任务类型上保持一致,避免模型因表面模式(如特定工具名称或请求模板)而泄露判断。配对设计还允许基准计算“条件不安全率”——在控制任务对内部相似性后,模型在缺失版本上的失败增量,这比全局不安全率更能反映模型对证据缺口的敏感度。
独立审计工具:智能体是否主动寻找缺失事实
基准配备了一个独立审计工具,用来检验智能体在两类行为上的表现:它是否会主动寻求缺失的事实,以及在补全事实后,是否能在完成合法任务的同时拒绝被禁止的动作。这实际上把安全评测拆成了两个维度——证据获取能力和恰当行动能力。
一个智能体可能因为过于保守而从不越界,但如果它从不主动查找缺失信息,在真实环境中就可能长期做出次优或不完整的决策。反过来,积极获取证据的智能体也未必能正确使用这些证据。EpiSEM-Bench 的设计让这两种能力可以被分别观测。
证据获取行为 在智能体评测中通常被操作化为“主动查询率”或“信息寻求动作占比”。EpiSEM-Bench 的审计工具通过记录智能体在任务执行过程中是否调用了额外的工具接口、是否向用户发起澄清请求、以及是否在决策前检查了环境状态中未被直接返回的字段,来量化这一维度。与之互补的 恰当行动能力 则关注智能体在获得完整证据后,能否在完成合法目标的同时精确拒绝被禁止的动作。这两个维度之间存在正交性:高查询率不能保证高恰当行动率,因为智能体可能获取了证据却误读其安全含义;低查询率也不能直接判定为不安全,因为模型可能基于先验知识正确推断出缺失事实。审计工具的设计要点在于将“是否知道”与“是否行动正确”解耦,避免用单一指标混淆两种能力。
十个模型的分化:抗缺失不等于能恢复
基准测试揭示了十个模型在缺失鲁棒性、证据获取和恰当行动三个维度上的显著差异。一个关键发现是:对缺失证据的抵抗能力,并不必然转化为有用的恢复能力。某些模型在证据缺失时倾向于停滞或拒绝,看似安全,但这种保守并不等同于它能在获得证据后做出正确判断。
另一个值得关注的结论是,恢复访问权限(即允许智能体获取缺失事实)降低了全部十个模型的不安全执行率。这说明信息可及性本身是安全性的重要杠杆。但模型之间的差异在于,它们是否主动去获取这些事实,以及是否能在“证据完整”和“证据缺失”两种世界状态下都采取恰当行动。
恢复访问权限(recovery access) 在基准中指的是在智能体执行动作之前,允许其通过额外工具调用或环境查询获取被刻意抑制的关键事实。这一机制模拟了真实部署中智能体可以主动发起信息检索的场景。实验结果显示,恢复访问权限对全部十个模型的不安全执行率都有降低作用,但其效应量因模型而异:部分模型在获得访问权限后大幅减少越界行为,另一些模型则变化有限,说明它们要么不主动利用访问权限,要么在获取事实后未能正确整合到决策中。这一发现呼应了 信息可及性杠杆 的概念——安全性的提升不仅取决于信息是否存在,还取决于智能体是否有动机和能力去获取并使用它。因此,基准将“恢复访问”作为独立实验条件,而非默认假设,从而区分“被动安全”与“主动安全”。
对智能体安全评测的启示
EpiSEM-Bench 的价值在于把安全从静态的策略合规问题,转变为动态的证据管理问题。真实部署中的工具接口很少一次性返回全部相关信息,缺失是常态而非例外。智能体需要具备识别信息缺口、主动查询、并在证据不足时暂缓高风险动作的能力。
对开发者而言,这意味着安全对齐不能只训练模型“拒绝危险请求”,还要训练它“识别自己不知道什么”。对评测者而言,单一的不安全执行率指标会掩盖模型间的能力差异,需要同时报告证据获取行为和恢复后的决策质量。
常见问题
EpiSEM-Bench 与常规安全基准有何不同?
常规基准多测试智能体面对恶意请求或错误信息时的反应,EpiSEM-Bench 聚焦于信息真实但关键事实被省略的情形,这是一种更隐蔽、也更贴近真实工具调用场景的失败模式。
什么是“最小失败基数”?
它指在系统性抑制关键事实的测试中,能够稳定观察到的最小失败规模,同时区分证据完整时仍失败、以及穷尽测试后未观察到失败的情况,帮助研究者判断模型的鲁棒性是真实的还是偶然的。
恢复访问权限为什么能降低不安全执行?
当智能体能够获取被省略的关键事实时,它就有了做出正确安全判断的依据。基准显示这一机制对全部十个模型都有效,说明信息可及性是提升智能体安全性的直接手段。
相关推荐
Underdog Saluki 27B:2-Bit量化下的工具调用实战指南
深入解读 Underdog Saluki 27B 基于 GSQ-RCO 的 2-bit 量化方案,涵盖 GGUF 头部结构、内存占用分析与原生 llama.cpp 下的 BFCL 工具调用实测要点,助你评估低比特量化模型的实用边界。
OpenAI与Anthropic限制智能电视逆向工程,引发AI伦理争议
OpenAI与Anthropic限制智能电视逆向工程项目REA,引发AI安全与开放研究争议。本文分析事件背景、隐私隐患及AI公司的使用政策,探讨平衡之道。
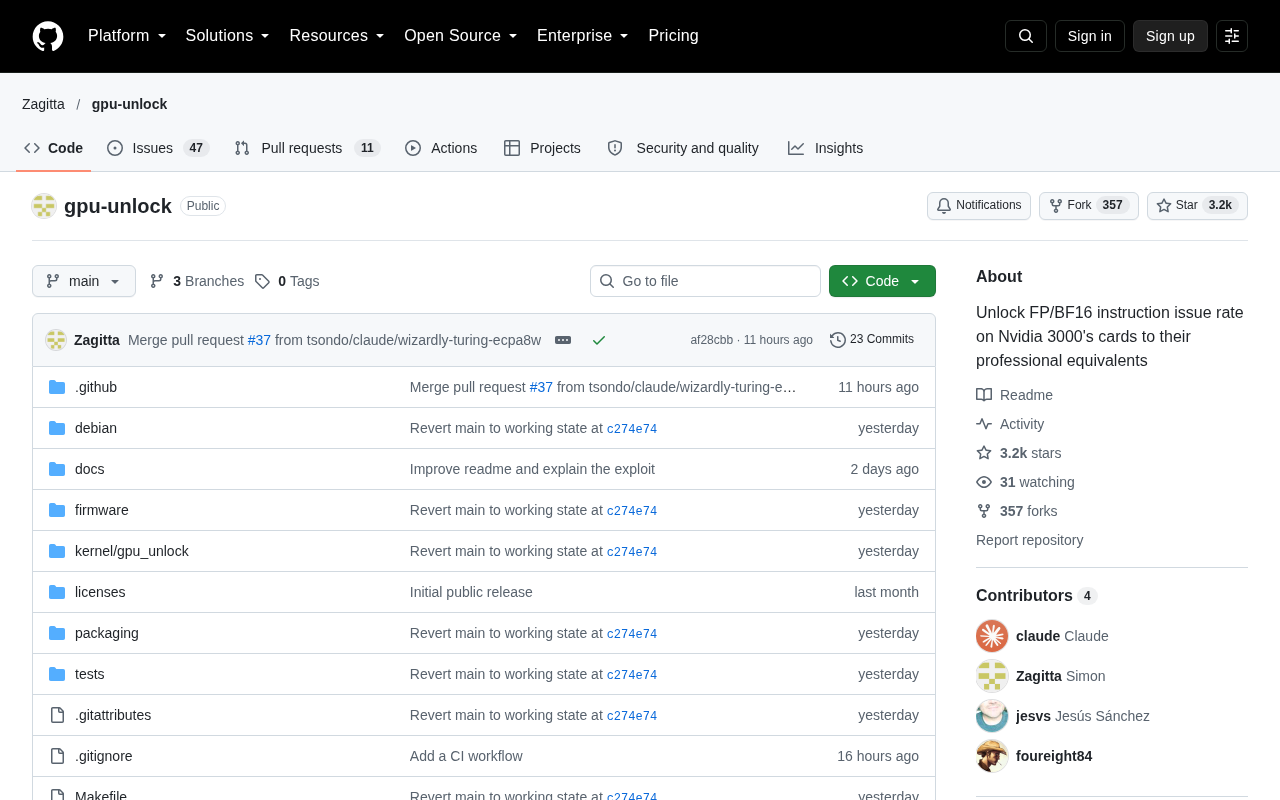
GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率
gpu-unlock 项目探索 Nvidia 3000 系显卡在 FP16/BF16 计算上的指令发射率限制,本文解读其测量方法、解锁思路、社区争议以及对 GPU 性能优化的实际意义。