Fable 5.2登陆Perplexity:深度研究能力超越Gemini Argon
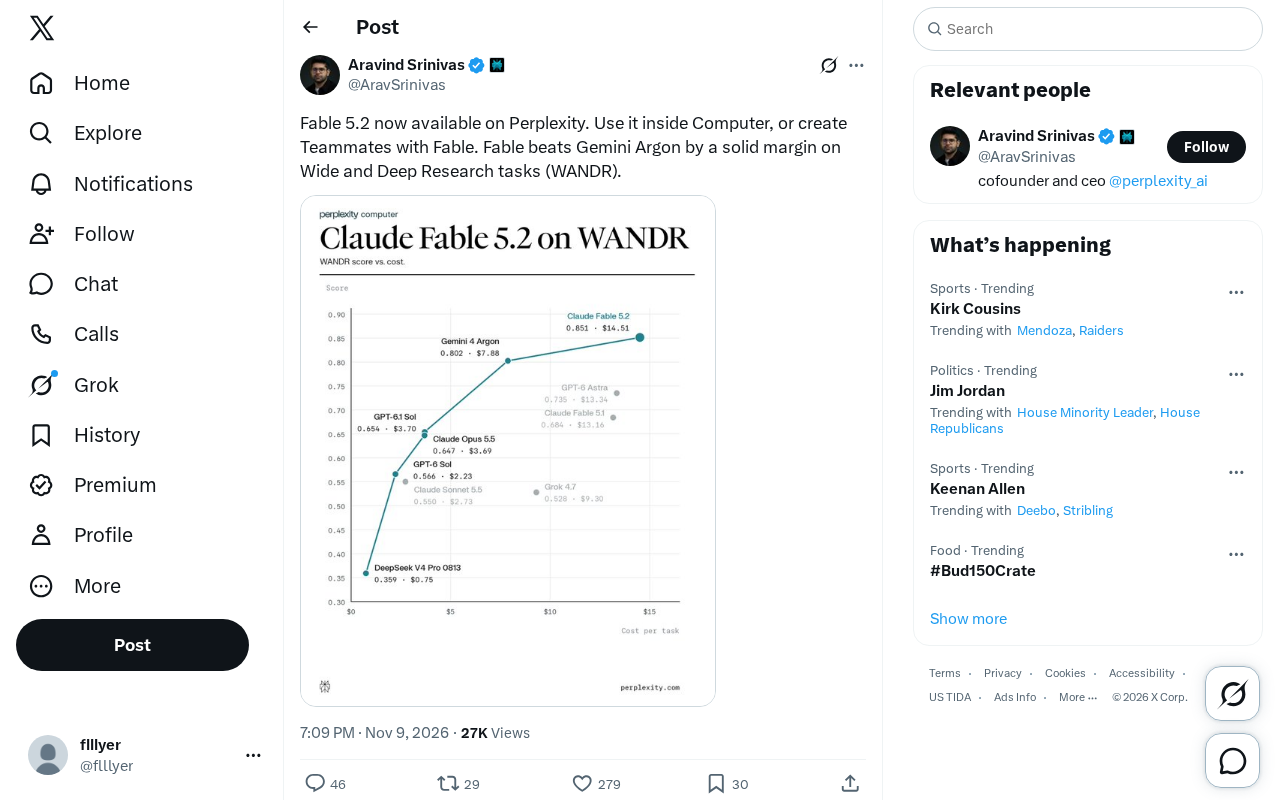
Perplexity上线Fable 5.2,宣称在深度研究任务上领先Gemini Argon,凸显AI搜索竞争转向研究能力。
Perplexity 近期上线 Fable 5.2 模型,用户可通过 Computer 功能直接调用,或基于其创建 Teammates 智能体。官方宣称该模型在 Wide and Deep Research(WANDR)任务上以明显优势击败谷歌的 Gemini Argon。文章认为,这一消息的意义不在于版本更迭,而在于揭示 AI 搜索产品的竞争重心正从聊天交互转向深度研究能力。Fable 5.2 的双路径接入体现了模型向工作流嵌入的趋势:Computer 负责任务执行,Teammates 负责角色化协作。同时文章提醒,单一来源的 benchmark 宣称需第三方验证,评测领先不等于真实体验优势。
Perplexity近期上线了Fable 5.2模型,用户可以在Computer功能中直接调用,也可以基于Fable创建Teammates智能体。官方推文宣称,在Wide and Deep Research(WANDR)任务上,Fable 5.2以明显优势击败了Gemini Argon。这条消息之所以值得关注,不在于又一个模型版本号的更迭,而在于它揭示了AI搜索产品竞争的一个关键转向:深度研究能力正在成为模型落地的核心战场。
深度研究成为新的能力标尺
WANDR这个评测名称本身就带有指向性——Wide对应广度,Deep对应深度,两者结合考察的是模型在开放式研究任务中的综合表现。这类任务要求模型不仅检索信息,还要跨来源整合、判断相关性、组织成有逻辑的结论。Perplexity选择在这个维度上对标Gemini Argon,说明它把"研究助手"而非"聊天助手"当作产品定位。
从推文措辞看,Fable 5.2的领先被描述为"solid margin"(明显优势),而非微弱领先。这种表述在官方宣传中通常意味着评测差距具备一定统计意义,但具体分数未在原始信息中披露,实际表现仍需第三方验证。
WANDR 基准的定位:Wide and Deep Research(WANDR)是专门为评估大语言模型在开放式深度研究任务中的表现而设计的评测集。与 MMLU、GSM8K 等侧重知识回忆或数学推理的基准不同,WANDR 模拟真实研究流程:给定一个宽泛问题,模型需要自主拆解子问题、多轮检索、跨来源交叉验证、剔除矛盾信息,最终输出结构化的研究报告。其评分维度通常包括信息覆盖度、来源可靠性、逻辑连贯性和结论可溯源性。这类基准的难点在于没有唯一标准答案,评判往往依赖 LLM-as-judge 或人工评分,因此分数差异的解读需要比传统基准更谨慎。
Computer与Teammates:两种使用路径
Fable 5.2在Perplexity中的接入方式有两种。一是Computer功能内的直接调用,面向需要完成复杂任务的普通用户;二是通过Fable创建Teammates,即让模型作为可配置的智能体角色参与协作。后者更接近"AI同事"的形态,用户可以为不同任务设定不同的Teammates,各自承担特定职责。
这种双路径设计反映了一个趋势:模型能力不再只通过单一对话框交付,而是嵌入到具体的工作流中。Computer负责任务执行,Teammates负责分工协作,两者共同构成Perplexity对"AI工作台"的理解。
检索增强生成(RAG)与深度研究的区别:检索增强生成(RAG)指模型在生成回答前先从外部知识库检索相关片段,再基于这些片段组织答案,主要解决知识时效性和事实 grounding 问题。但传统 RAG 通常是单轮检索、片段拼接,面对需要多跳推理的复杂问题容易断裂。深度研究型任务则要求模型进行多轮迭代检索:根据初步结果判断信息缺口,再发起新一轮查询,并对冲突来源做取舍。Perplexity 早期产品以单轮 RAG 检索聚合为主,Fable 5.2 的引入意在补足多轮深度推理这一层,使产品从「答案引擎」向「研究引擎」延伸。
与Gemini Argon的竞争格局
Gemini Argon是谷歌在深度研究方向上的代表性模型,Perplexity主动将其作为对标对象,等于在谷歌的主场发起挑战。对于Perplexity而言,模型选型一直是其产品策略的敏感点——它既依赖外部模型,又需要建立差异化。引入Fable 5.2并强调其在研究任务上的优势,是在向用户传递"我们不只做检索聚合,也做深度推理"的信号。
补充一点,单一来源的评测宣称不足以构成定论。模型在特定benchmark上的领先,与真实使用场景中的体验差距之间往往存在落差。WANDR成绩好,不代表所有研究类任务都占优,用户的实际感受还取决于检索质量、响应速度、引用准确性等外围因素。
Teammates 与多智能体协作:Teammates 本质上是可配置的智能体角色(agent persona),每个角色绑定特定的系统提示、工具权限和知识范围。多智能体协作的核心思路是任务分解与角色分工:由一个协调者将复杂任务拆给不同专长的智能体,各自完成后汇总。这种架构能降低单一对话上下文过载的问题,但也带来新的挑战——角色间的信息传递损耗、任务边界划分、结果一致性校验。Perplexity 将 Teammates 与 Computer 并列,说明其产品逻辑是把模型能力封装为可编排的工作单元,而非仅提供对话接口。
对用户意味着什么
对Perplexity用户来说,最直接的变化是多了一个可选的推理后端。做深度调研、竞品分析、文献梳理这类任务时,Fable 5.2可能带来更完整的输出;而日常问答未必需要切换到它。Teammates的引入则让"多智能体协作"从概念走向可用,用户可以根据任务类型配置不同的角色,减少在单一对话里反复切换上下文的负担。
从行业角度看,深度研究能力的军备竞赛正在加速。当检索增强生成逐渐成为标配,差异化的关键就落在"研究做得多深、整合做得多好"上。Fable 5.2在Perplexity的落地,是这场竞赛中的一步,但远不是终点。
相关推荐

Helix 嵌入你已有的 AI:同一份线索,Claude、ChatGPT、Cursor 都能用
Helix 宣布嵌入 Claude、ChatGPT、Cursor 等你已在用的 AI 工具:三个使用者、三种 AI,得到同一组数字,你只需审批,其余由 Helix 自动执行。

免费领取Cursor + Grok:MLH全球黑客周限时福利
MLH全球黑客周提供免费一个月X Premium订阅,包含Cursor和Grok模型。了解如何注册、完成挑战并兑换代码,注意账户需满30天。

AI不替代开发者:Copilot、Cursor与v0的50秒工作流
从Jonathan的分享看AI编程工具的真实价值:v0如何用自然语言生成React+Tailwind组件,好提示词需明确组件、状态、主题、交互四个维度,以及为什么AI只放大优秀开发者的能力。