Fable 5.2灰度测试曝光:Anthropic或将超越GPT-6 Astra
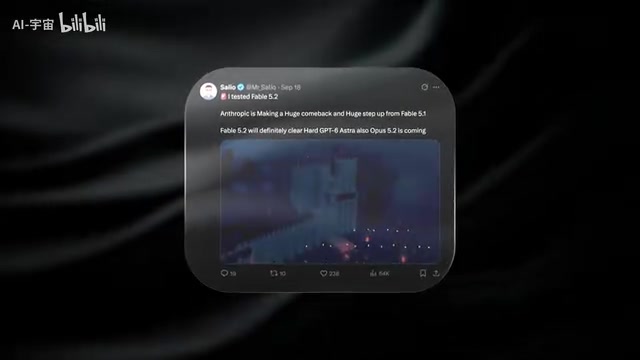
Anthropic疑似秘密灰测Fable 5.2,社区测试称其推理能力大幅超越GPT-6 Astra,但官方至今未确认。
一批使用Claude Code的用户意外发现,Anthropic在未公告的情况下将部分请求静默重定向至新模型Fable 5.2。来自社区测试者的对比结果显示,该模型在深度推理、3D建模和代码生成上明显优于OpenAI的GPT-6 Astra,但代价是更慢的生成速度与更高的推理成本。同期曝光的Opus 5.2也被测试者称赞在复杂3D任务上表现惊人。这一系列动作的背后,是Anthropic面临IPO前企业市场被OpenAI蚕食的竞争压力。与此同时,围绕AI安全评估机构METR资金来源与利益独立性的争议也在社区发酵。文章反复强调,上述绝大多数信息均来自社区爆料,官方尚未正式确认,应保持审慎。
一次意外泄露的灰度测试
据B站相关UP主的爆料,过去一天里,不少使用Claude Code进行对话或协同开发的用户,可能在毫不知情的情况下接触到了一个「官方尚未承认」的AI模型——Fable 5.2。事情的起点相当偶然:Anthropic开启了灰度测试,原本应发送给Fable 5.1的请求,在后台被静默重定向到了新模型。
最先察觉异样的是来自Nocast的测试员,他注意到回复风格发生了明显变化,随即展开对比测试。相同的输入、相同的深度推理模式下,Fable 5.2的表现被认为「相比现款堪称巨大飞跃」,回答质量明显优于OpenAI的GPT-6 Astra。这一结论在多模式测试中依然成立。
需要强调的是,以上信息目前仍属于社区测试者的观察与爆料,Anthropic官方并未正式确认Fable 5.2的存在。因此这些「碾压Astra」的结论应当保持审慎态度。
更强推理的代价:慢思考与成本
多位测试者提到,Fable 5.2的性能提升并非没有代价。据开发相关人士的说法,为了突破逻辑序列和长程推理的上限,5.2采用了更深度的「慢思考」机制。直接后果是生成速度变慢,推理成本显著上升。
这一权衡在实际测试中被反复验证。测试员Bavani尝试用高难度的「火箭测试」——将复杂物理计算、空间逻辑与系统工程设计汇集到单个提问中,这类任务极易暴露AI的幻觉与逻辑漏洞。他用Fable 5.2和同样处于灰度测试的Opus 5.2实测,结果被形容为「逼真得可怕」。另一位测试者让5.2在一小时内克隆了Brawl Stars并发布成果,直接引爆了评论区的游戏开发者群体。
Ketan Suwa做了三方对比:Fable 5.2、Opus 5.2对阵GPT-6 Astra,各项参数全部拉满——最大资源、最深推理步骤、无任何限制。结论是两款Anthropic模型的回答都明显比Astra更详尽。有测试者甚至声称,即便在「裸机模式」下,Fable 5.2也强于完全体的Astra,并将其归因于参数规模和架构的改变。
「慢思考」(Slow Thinking)是近年大型语言模型推理范式的重要演进方向,与之对应的是「快思考」(Fast Thinking)。快思考模式下,模型直接根据输入生成输出,延迟低但容易在多步逻辑链条上出错;慢思考模式则让模型在输出最终答案前,先进行显式的中间推理步骤(即「思维链」Chain-of-Thought),甚至反复自我验证和修正。OpenAI的o系列模型、Google的Gemini Thinking以及Anthropic的扩展思考模式(Extended Thinking)均属于此类架构。慢思考的代价是推理Token数量成倍增长,直接推高了每次调用的计算成本和响应延迟。因此,高性能与低成本/低延迟之间的权衡,是当前各实验室共同面对的核心工程挑战,也是区分「旗舰推理模型」和「日常使用模型」的主要分界线。
一个有趣的「测试组检测法」
社区还流传出一个判断自己是否被切换到新模型的小技巧:选择Fable 5.2或Opus 5.2,询问它是否知道某个特定人物,并要求不联网搜索。
旧版的Fable 5.1或Opus 5会因为训练数据未覆盖相关时期而犯糊涂、胡编乱造,或者直接坦白不知道;而若你已被悄悄切换到新模型,它会立刻给出准确回答,无需任何工具。这个方法侧面反映出新模型的训练数据时间线更新。
话说回来,内部代号「Opus Next」的Opus 5.2也经历了小插曲。网红Leo在Roblox Studio中体验后称,其在复杂3D任务上的表现「惊人地出色」,超越了Fable 5.1和Astra,且更便宜、更快速,甚至主动为游戏加入了导览系统。然而Anthropic在半夜毫无预警地拔线,测试组活跃账户瞬间归零,Leo被迫叫停项目。
各大实验室的「集体暗战」
最诡异的地方在于,尽管各大主流实验室都没有正式发布,硅谷表面一片沉寂,但众多模型却同时开启了秘密测试与数据泄露。
除了Fable 5.1向5.2的过渡、Opus 5.2的曝光,还有传闻涉及GPT系列的更名、马斯克的Grok版本、以及Google Gemini系列伪装成不同代号进行测试。有消息称,Anthropic可能直接跳过5.1,因为新模型在前端开发、3D建模及游戏设计上的能力跨度远不止一个小版本。人们还发现Anthropic悄然调整了排名顺序,将Opus升至榜首并超过Fable——对两款旗舰模型而言,这绝非小事。
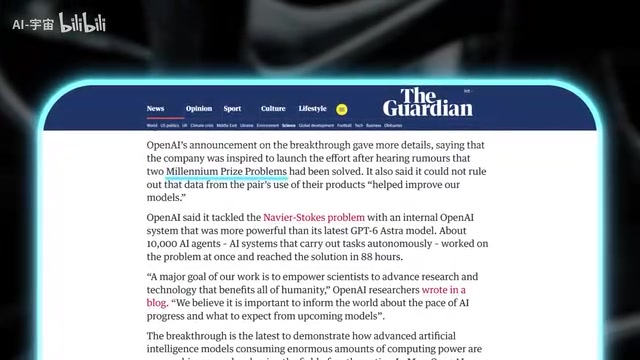
还有一则需要高度存疑的传言:据称部分顶尖模型的逻辑推理能力已触及现代数学难题,研发团队在解答中引用数学家成果。这类说法目前缺乏可靠佐证,仅作参考。
IPO压力下的商业博弈
为什么Anthropic急于在此时推新模型?路透社的报道给出了一个更现实的答案:这与IPO前的商业竞争直接相关。
GPT-6 Astra在计算机操作等能力上表现亮眼,企业响应迅速。据报道,在企业平台Ramp上,Astra占据约13%的企业AI支出,而Claude/Fable仅占8%;在路由开发者流量的OpenRouter上,OpenAI的支出时隔两年半首度反超Anthropic。这让筹备IPO的投资者开始反思:Anthropic是否真如预期般领跑企业市场。
从纯财务指标看,Anthropic仍处于领先地位——其年化收入在7月底超过65亿美元(原文数据存疑,此处按报道转述),并预计到2028年大幅增长。但开源模型、尤其是中国开源模型拉低了成本,让企业自建架构的压力剧增,这被认为比OpenAI构成的威胁更严重。此外,大客户Meta正推进自研以减少依赖。至于上市时间,Sam Altman已确认OpenAI在2026年不会上市,而Anthropic的IPO或延至美国中期选举之后。
OpenRouter是一个模型路由聚合平台,允许开发者通过统一API访问来自Anthropic、OpenAI、Google等多家提供商的模型,并按实际使用量计费。由于其聚合了大量开发者的真实调用流量,其各模型的支出占比数据被视为衡量开发者社区「实际偏好」的重要参考指标,比官方公布的订阅用户数更能反映模型在实际开发场景中的竞争力。文中提到OpenAI支出份额在OpenRouter上时隔两年半首度反超Anthropic,若属实,意味着开发者群体对两家模型的使用偏好正在发生结构性转移,这对以企业和开发者客户为核心的Anthropic而言,具有相当的市场信号价值。
安全叙事与利益结构之争
在技术竞赛之外,一场关于AI安全叙事的争论正在发酵。这部分内容争议极大,涉及多方指控与反驳,读者需自行判断。
争论的转折点是一封研究员的辞职信,声称主流实验室「不懂AI有多强」,正将人类置于险境,该帖浏览量据称超过1.7亿。随后有博主发布长文,核心观点直指Anthropic在推动AI监管的同时,也牢牢掌握了监管叙事的话语权——例如从其研究体系中分拆出的模型评估机构METR,被指定为「独立第三方」,但其资金来源与Anthropic的投资人存在重合。
批评者描述了一个「恶性循环」:估值上涨→安全生态获利→灾难叙事加剧公众恐惧→独立评估需求激增→资助与权力再次流向同一批人。但也有理性的反驳指出,资金源重合并不等于欺诈,这更可能说明该领域「自始至终小而紧密」。这引出了一个没人能给出明确答案的核心问题:评估独立性的真实标准究竟在哪里?披露多少资金信息才算足够?
METR(Model Evaluation & Threat Research)是一家专注于前沿AI模型能力评估的非营利机构,由前Anthropic研究员创立,主要承担对齐能力测试和危险能力评估等工作。在美国政府与各大实验室签署的自愿安全承诺框架下,METR被多次指定为「第三方独立评估机构」,参与GPT-4o、Claude 3等旗舰模型上线前的安全审查。文中争议的核心在于:若资助METR运营的投资人与Anthropic存在重叠,其「独立性」的实质意义便值得追问。这一问题并非AI领域独有——学术界的同行评审、金融业的信用评级机构均面临类似的利益结构困境。如何在资金来源透明度与机构运营可持续性之间取得平衡,是AI治理领域尚未解决的制度设计难题。
写在最后
综合来看,Fable 5.2与Opus 5.2的灰度测试爆料,展现了Anthropic在推理能力上的一次潜在飞跃,也折射出IPO压力、企业市场竞争、开源冲击与安全叙事博弈交织的复杂局面。
必须再次提醒:本文所述模型性能、财务数据与安全争议,绝大部分来源于社区测试者观察与媒体报道,官方尚未正式确认。在真正的发布公告出现之前,这些结论都应被视为「传闻」而非定论。今晚,一切都可能改变。
相关推荐
AI玩《我的世界》141小时被苦力怕炸出"抑郁",只肯种土豆
海外机构Wars AI让GPT-6 Atra独立游玩《我的世界》141小时,AI进度超越所有前辈却被苦力怕炸得资源归零,随后陷入只肯种土豆的"抑郁"状态。本文解析这场实验背后AI智能体的能力与局限。
豆包AI漫剧量产教程:从素材到分镜的全流程实操
AI漫剧全流程实操教程:如何用豆包完成正版素材筛选、专家模式爆款剧本改写与Seedance模型分镜设计,帮助新手规避版权与改编两大门槛,稳定量产红果漫剧作品。
LangChain九月更新解析:委托访问与Agent可观测性升级
LangChain九月版本更新详解:为沙箱引入委托式LangSmith访问、支持stop_reason捕获的SDK运行追踪、修复ReDoS安全漏洞,并覆盖LangChain OpenAI、Anthropic及LangGraph CLI等生态包,全面提升agent工作流的可观测性与可靠性。