反向IRT模型:破解癌症药物响应数据稀疏难题

将教育测评中的IRT模型反向迁移至癌症药物筛选,在高缺失率稀疏数据下显著提升耐药排序稳健性。
这项发表于arXiv的研究将心理测量学经典模型——项目反应理论(IRT)——创造性地"反向"应用于癌症药物敏感性分析:以癌症类型为"考生"(耐药能力),以药物为"考题"(逃逸难度),将两者映射到同一潜在量表上进行可比排序。基于GDSC2数据库逾24万条测量,研究证明在60%缺失率下,反向IRT的排序恢复能力比简单平均法提升Delta-rho约0.09,留出预测的Brier分数在五种方法中最优,28种癌症类型中19种分类结果稳定。跨平台PRISM复现显示方向一致性82%但秩序相关性仅0.25,作者据此将贡献定位为"碎片化评估场景下的方法论稳健性"而非通用临床耐药排行,体现了难得的学术克制。
当抗癌药物筛选遇上数据缺失
癌症药物敏感性数据库是精准医疗的重要基础,但这类数据长期面临一个棘手问题:矩阵高度稀疏、碎片化。不同癌症类型与药物组合的测量覆盖率参差不齐,大量数据缺失,导致传统的排序方法(如简单平均)在缺失严重时失真明显。
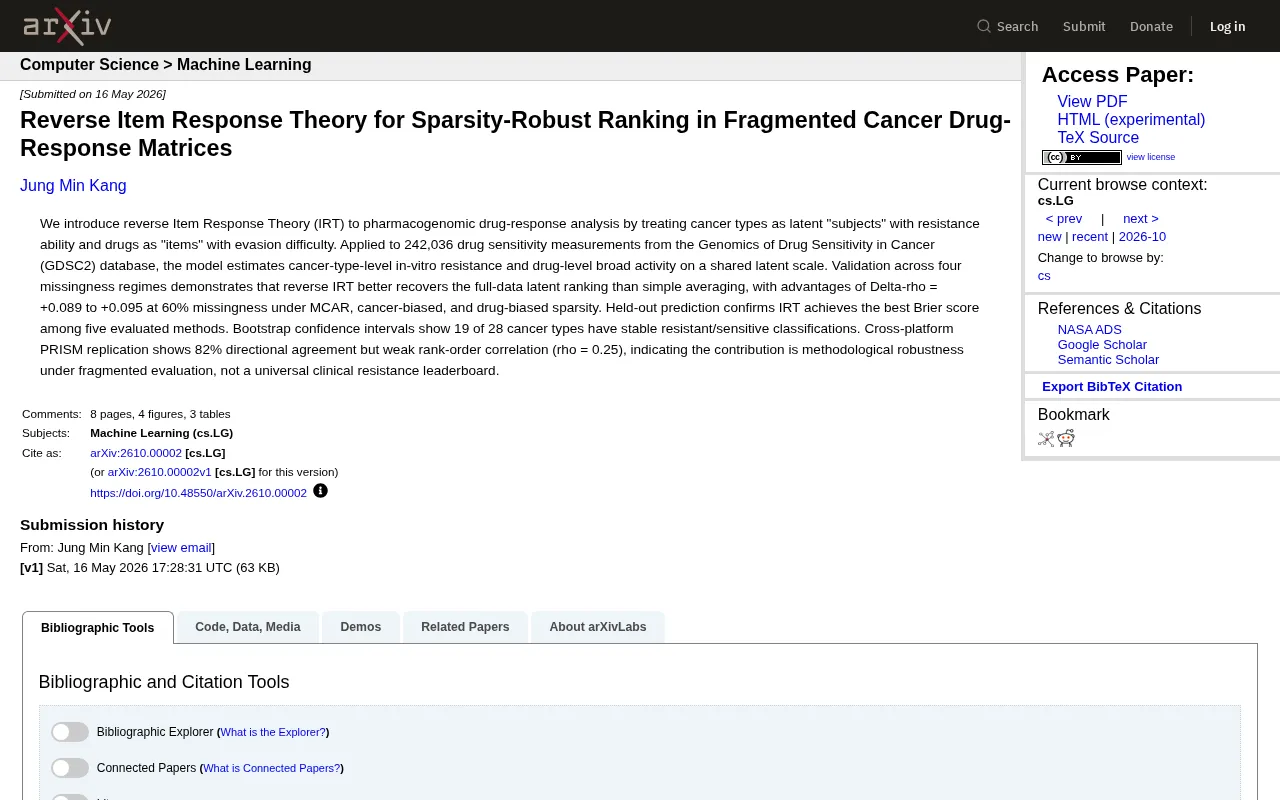
一篇新发布于arXiv的研究(arXiv:2610.00002)提出了一个颇具巧思的解决思路——将源自心理测量学的**项目反应理论(Item Response Theory, IRT)**反向应用于药物基因组学分析,以提升碎片化数据下的排序稳健性。
把癌症类型当作"考生",把药物当作"考题"
IRT原本是教育测评领域的经典模型,用于根据考生答题情况估计其潜在能力(如学习水平)和题目的难度。这项研究做了一个有趣的角色转换:
- 癌症类型被视为潜在的"被试主体(subjects)",对应参数是其"耐药能力(resistance ability)";
- 药物被视为"题目(items)",对应参数是其"逃逸难度(evasion difficulty)",也即药物的广谱活性。
通过这种设定,模型将癌症类型层面的体外耐药性与药物层面的活性映射到**同一个潜在量表(shared latent scale)**上,从而实现可比的排序。这种"反向"思路的价值在于,它天然适合处理观测不完整的稀疏矩阵——正如考试中不是每个考生都答了所有题目,IRT依然能估计能力与难度。
项目反应理论(IRT)起源于20世纪50年代的教育心理学,由Frederic Lord等人系统化发展。其核心思想是:观测到的作答结果(对/错)背后存在一个无法直接测量的潜在能力维度,每道题目的"难度"和"区分度"决定了不同能力水平的考生答对该题的概率。最常用的Rasch模型(1参数IRT)假设答对概率仅由考生能力与题目难度之差决定,形式为logistic函数:P(正确) = 1 / (1 + exp(-(θ - b))),其中θ为考生能力,b为题目难度。IRT的关键优势在于参数不变性:只要模型拟合良好,对考生能力的估计不依赖于具体做了哪些题,对题目难度的估计也不依赖于具体哪批考生作答——这正是它天然适配稀疏矩阵的数学原因。在本研究的类比中,"答对"对应癌症对药物表现出敏感性,潜在量表则同时承载了癌症的耐药倾向与药物的广谱活性。
大规模数据验证:稀疏环境下的明显优势
研究基于GDSC2(Genomics of Drug Sensitivity in Cancer)数据库中的242,036条药物敏感性测量进行建模与验证,覆盖了多种缺失机制下的稳健性测试。
研究设计了四种缺失情形进行对照,包括完全随机缺失(MCAR)、癌症类型偏向性缺失以及药物偏向性缺失。结果显示:
- 在60%缺失率的条件下,反向IRT相比简单平均法在恢复完整数据潜在排序方面有明显优势,Delta-rho提升达到 +0.089 到 +0.095;
- 在留出预测(held-out prediction)任务中,IRT在所评估的五种方法中取得了最佳的Brier分数,说明其概率预测校准表现最优;
- 通过自助法(Bootstrap)置信区间分析,28种癌症类型中有19种具备稳定的耐药/敏感分类结果。
这些结果共同指向一个核心结论:当评估数据碎片化、缺失严重时,反向IRT比传统平均方法更能还原数据的真实结构。
**GDSC2(Genomics of Drug Sensitivity in Cancer 第二版)**是由英国Sanger研究所与麻省总医院联合维护的大规模公开数据库,记录了数百种人类癌症细胞系对数百种候选抗癌化合物的半抑制浓度(IC50)或曲线下面积(AUC)等体外药物敏感性指标。该数据库是药物基因组学研究的标准基准之一,但其矩阵天然稀疏——并非所有药物都在所有细胞系上进行了测试,不同癌症类型的覆盖深度也相差悬殊。Brier分数是评估概率预测质量的经典指标,定义为预测概率与实际二元结果之差的均方值,值域0到1,越低越好;它同时惩罚信心过高的错误预测和校准不足的模糊预测,因而比简单的准确率更能反映概率模型的实际可用性。
跨平台复现揭示方法论的边界
值得深究的是这项研究的自我审视。作者用另一个独立数据平台PRISM进行了跨平台复现,结果呈现出两面性:
- 方向一致性达82%,即耐药/敏感的大体判断在两个平台间保持一致;
- 但秩序相关性较弱(rho = 0.25),意味着具体的排名顺序在不同平台间并不稳定。
作者据此给出了诚实的定位:这项工作的贡献在于碎片化评估下的方法论稳健性,而非提供一份放之四海皆准的"临床耐药排行榜"。这种克制的结论反而增强了研究的可信度——它没有过度宣称临床价值,而是精确界定了方法的适用场景。
**PRISM(Profiling Relative Inhibition Simultaneously in Mixtures)**是由Broad研究所开发的高通量药物筛选平台,通过条形码标记细胞系、混合培养后同时测量多种细胞系对同一药物的响应,极大地降低了大规模筛选的成本。与GDSC2基于单一细胞系培养的IC50测量不同,PRISM的读数体系、实验条件和数据处理流程均存在差异,因此两个平台的绝对数值本就不具备直接可比性。这种平台间差异在药物基因组学领域早有记录——多项研究发现CCLE、GDSC等主流数据库在相同细胞系和药物组合上的测量值相关性常常低于预期。本研究中82%的方向一致性与0.25的秩序相关性并存的现象,与该领域已知的跨平台再现性局限相吻合,提示方法稳健性的评估本身也需要在多平台共识的框架下解读。
对AI方法迁移的启示
这项研究的意义不止于药物基因组学本身。它展示了一个典型案例:成熟领域的统计模型可以通过角色重构,迁移到数据结构相似的新问题上。
IRT的核心优势——在部分观测条件下估计潜在参数——恰好契合了生物医学数据普遍存在的稀疏性挑战。对于从事AI与生命科学交叉研究的团队而言,这提供了一个可借鉴的思路:面对缺失严重的实验矩阵,与其依赖简单的统计汇总,不如引入具备潜变量建模能力的概率框架。
当然,跨平台排名相关性偏弱也提醒研究者,方法的稳健性与结论的普适性是两回事。在将此类模型推向实际临床决策之前,仍需更多跨数据源的一致性验证。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。