反职责机制:让AI智能体主动"唱反调"的协作新思路
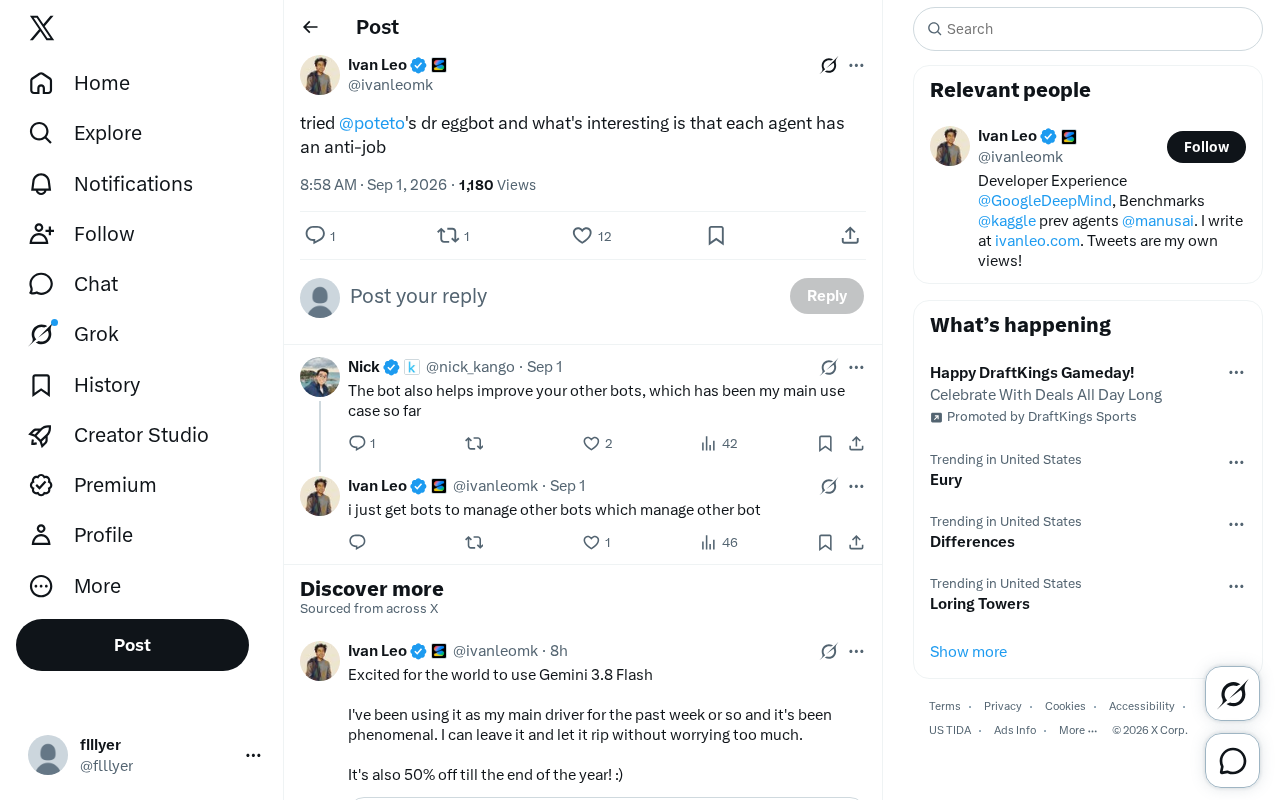
dr eggbot为每个AI智能体内置「反职责」角色,以结构性对抗对抗多智能体系统的回声室效应。
开发者 @poteto 的实验项目 dr eggbot 引入了一个颇具启发性的设计理念:为每个AI智能体赋予一个「反职责」(anti-job),使其在完成正向任务的同时,充当内建的「魔鬼代言人」,主动质疑和挑战当前结论。这一机制直接针对多智能体系统中普遍存在的「回声室效应」——多个基于相同底层模型的智能体因训练特性倾向于相互认同,导致判断偏差被放大而非纠正。反职责设计将对抗性思考内化为智能体的天然属性,与学术界「多智能体辩论」研究方向高度呼应,在代码审查、内容创作和决策支持等场景中具有实际价值。其工程挑战在于如何防止过度对抗导致系统无法收敛,以及如何确保底层模型具备真正的批判性思维能力。
引言:一个有趣的智能体设计实验
最近,开发者 @poteto 推出的实验性项目 dr eggbot 引发了社区讨论。有用户在体验后发现了一个颇为新颖的设计理念——每个智能体(agent)都被赋予了一个「反职责」(anti-job)。
这个看似简单的概念,实际上触及了当前多智能体系统设计中的一个核心痛点:当多个AI智能体协同工作时,如何避免它们陷入过度一致、盲目附和的困境?
什么是「反职责」机制
传统智能体的职责定义方式
在常规的多智能体架构中,每个智能体通常被分配一个明确的「职责」(job)——比如一个负责搜索信息,一个负责总结,一个负责校验。这种分工方式清晰高效,但也存在明显的局限:智能体倾向于朝着完成自身任务的方向一路推进,缺乏对结果的批判性审视。
引入对立视角:内建的「魔鬼代言人」
dr eggbot 的做法是,除了给每个智能体分配正向职责外,还额外赋予其一个「反职责」。这个反职责的作用类似于一个内建的「魔鬼代言人」(Devil's Advocate)——它要求智能体在完成任务的同时,主动去质疑、挑战或推翻当前的结论方向。
换句话说,智能体不再只是一味地推进任务,而是被结构化地要求「唱反调」。这种设计从机制层面强制引入了多样性和对抗性思考。
反职责机制为什么值得关注
有效对抗多智能体系统的「回声室效应」
多智能体系统一个常被诟病的问题是「回声室效应」(Echo Chamber)——当多个基于同一底层模型的智能体互相交流时,它们往往会强化彼此的观点,而不是产生真正的分歧和纠错。结果就是系统整体的判断偏差被放大,而非被修正。
反职责机制正是针对这一问题的直接应对。通过在每个智能体内部植入对立诉求,系统在结构上就保证了不同意见的存在,从而提升整体决策的鲁棒性。
回声室效应在多智能体系统中的成因有其技术根源:当前主流的大语言模型(如GPT系列、Claude等)在训练阶段经过了大量的人类反馈强化学习(RLHF),这一过程使模型天然倾向于输出令人满意、易于接受的回答,而非主动提出批评。当多个此类模型互相传递信息时,每个模型都会对前一个模型的输出给予正向回应,形成类似「集体确认偏误」的系统性偏差。斯坦福大学的研究将这一现象称为「奉承螺旋」(Sycophancy Spiral),是当前多智能体应用中可靠性不足的重要原因之一。
与多智能体辩论研究方向的呼应
这一思路与学术界近期热议的「多智能体辩论」(Multi-Agent Debate)范式高度契合。相关研究表明,让多个AI通过辩论和相互批判来达成结论,往往能显著提升推理任务的准确性,减少幻觉(hallucination)。
dr eggbot 的创新之处在于,它没有让辩论成为一个独立的外部流程,而是把「对抗性」内化到了单个智能体的角色定义中,使其成为智能体的天然属性。
多智能体辩论(Multi-Agent Debate)作为一个正式研究方向,在2023年前后获得学术界的广泛关注。麻省理工学院与谷歌等机构的研究者发现,当多个大语言模型实例就同一问题展开多轮辩论时,最终答案的准确率相比单模型输出可提升10%至30%,在数学推理和事实性问题上效果尤为显著。其核心机制是利用「社会压力」促使模型在受到质疑时重新审视自身推理链,而非简单地维持原有立场。这与人类学术同行评审的逻辑相通:外部质疑能激活模型对自身错误的检测能力,而这种能力在单独运行时往往被抑制。
反职责机制的应用场景与落地挑战
适用场景
这种设计在需要高可靠性判断的场景中尤其有价值:
- 代码审查:一个智能体编写代码,其反职责则专注于找出潜在bug和边界情况。
- 内容创作:正向智能体生成内容,反职责智能体挑战其逻辑漏洞和事实错误。
- 决策支持:在商业或研究决策中,强制引入反方论证,避免群体思维。
需要权衡的工程问题
当然,反职责机制并非没有代价。过度的对抗可能导致系统陷入无休止的争论,难以收敛到最终结论。因此,如何平衡「推进任务」与「质疑任务」之间的张力,如何设计合理的终止条件,将是这类系统落地时必须解决的工程难题。
此外,反职责的效果高度依赖底层模型的能力。如果模型本身缺乏足够的批判性思维能力,那么所谓的「反职责」可能只是流于形式的表面反对。
系统收敛性问题在工程实践中通常通过几种方式加以缓解:一是设置固定的辩论轮次上限,强制在有限轮次后由「仲裁者」智能体或投票机制输出最终结论;二是引入置信度阈值,当正方智能体的论点强度超过预设水平时,反职责智能体的否决权自动降级;三是动态调整对抗强度,在任务初期允许更激烈的质疑,随着信息积累逐步收紧反职责的边界。这些设计本质上是在「探索」(exploration)与「利用」(exploitation)之间寻找平衡,与强化学习领域的经典权衡问题在逻辑上一脉相承。
结语:从「协同一致」走向「结构性对抗」
dr eggbot 的这次实验,虽然只是一个小众开发者项目,但它折射出多智能体系统设计的一个重要趋势:从追求「协同一致」转向拥抱「结构性对抗」。
真正强大的集体智能,往往不是来自完美的和谐,而是来自受控的冲突与纠错。正如人类社会中健康的辩论能催生更好的决策一样,为AI智能体内建反职责,或许正是通往更可靠、更可信AI系统的一条值得探索的路径。
随着多智能体应用的普及,我们有理由期待看到更多类似的机制创新。
相关推荐
GPT-6 Astra实测:一句提示词把伦敦变成3D游戏
GPT-6 Astra早期实测:测试者仅用几个提示词就把历史伦敦变成可玩的3D体素游戏,横跨中世纪到现代,模型还主动生成小地图。本文解析Astra的主动创造力及其产品意义。
GitHub Copilot 桌面应用上线:原生客户端带来的智能编码新体验
GitHub Copilot 正式推出原生桌面应用,支持 Windows 和 Mac 客户端。集成智能代理式编码、issue 与 PR 管理、工作树隔离及本地云端双模式运行,让开发者乃至非技术用户都能高效使用。
GitHub MCP实战:新协议、Elicitation与无状态服务器如何落地
GitHub MCP维护者分享服务器、客户端与协议三端实战:新MCP规范落地、无状态服务器如何借助MRTR支持elicitation,以及Skills over MCP、Server Cards等新特性对生态的影响。