分层RAG架构研究求助:独立开发者如何叩开学术研究之门
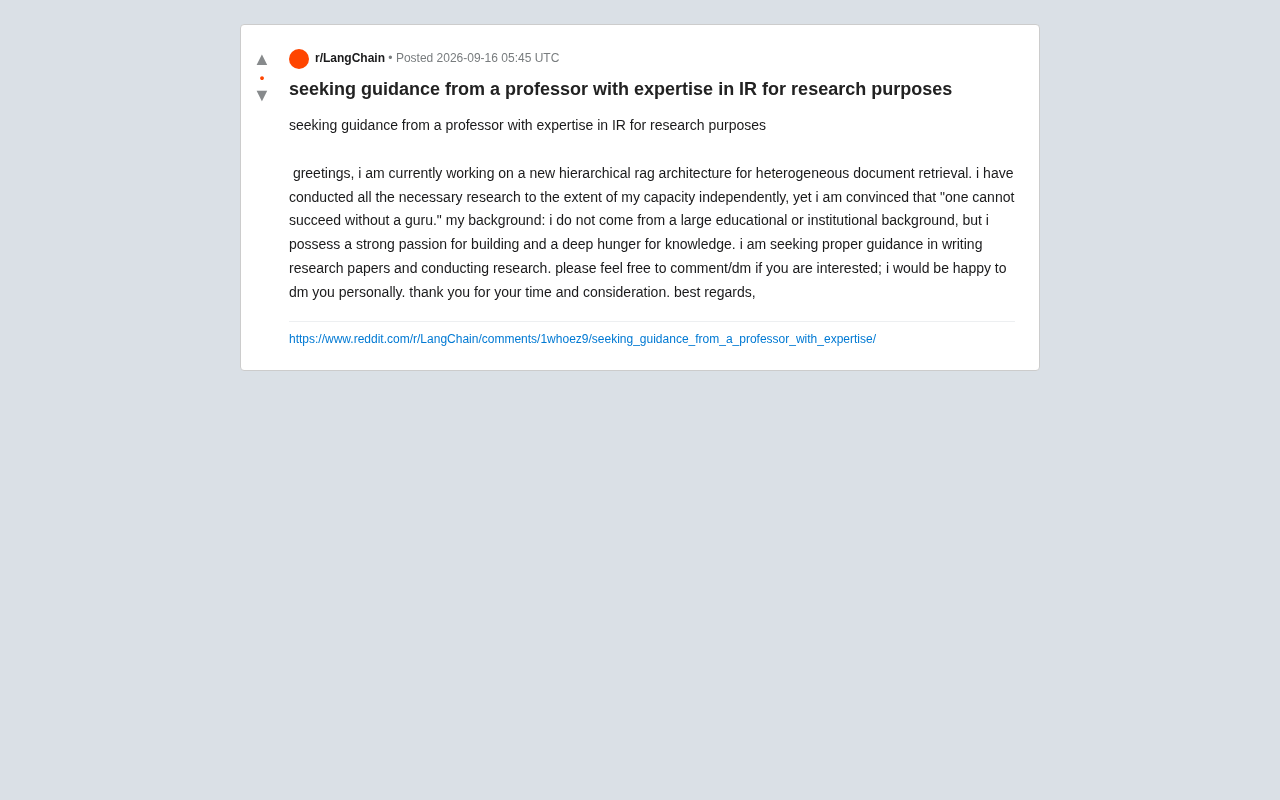
无学术背景的独立开发者寻求分层RAG研究指导,折射出AI时代工程能力与学术门槛之间的普遍鸿沟。
一位独立开发者在Reddit发帖,寻求信息检索领域教授指导其分层RAG(Hierarchical RAG)研究,引出了AI时代独立研究者的典型困境。分层RAG通过由粗到细的检索策略解决异构文档精度问题,是当前学术与工业界共同关注的前沿方向。该开发者的核心障碍并非技术能力,而是学术写作规范、机构背书缺失以及如何将工程原型转化为规范学术产出。文章指出,导师并非唯一出路——将成果公开化、主动联系细分领域研究者、参与开源社区协作,以及自学学术写作范式,都是可行的替代路径。AI技术民主化降低了触碰前沿的门槛,但从"能构建"到"被学术界认可"之间仍存在范式鸿沟,公开可见的成果是独立研究者撬动机会的最有效杠杆。
一条来自Reddit的求助帖
在Reddit的技术社区里,一位独立开发者发出了一条颇具代表性的求助帖。这位作者正在研究一种全新的分层检索增强生成(Hierarchical RAG)架构,目标是解决异构文档检索(heterogeneous document retrieval)的难题。他坦言自己已经凭一己之力完成了力所能及的所有前期研究,但深信"一个人很难在没有导师的情况下成功",因此公开寻求一位具备信息检索(IR,Information Retrieval)专业背景的教授指导。
这条帖子本身信息量不大,却折射出当下AI技术浪潮中一个越来越普遍的群体困境:技术能力与学术门槛之间的鸿沟。作者明确表示,自己没有显赫的教育或机构背景,但拥有强烈的构建热情和对知识的渴求。
分层RAG与异构文档检索的技术背景
要理解这位开发者面对的挑战,需要先厘清几个关键概念。
什么是异构文档检索
异构文档指的是格式、结构、来源各不相同的文档集合——可能同时包含PDF、网页、表格、图文混排、代码片段等多种形态。传统RAG系统在处理单一格式文档时表现尚可,但面对异构数据时,检索精度往往大幅下降。不同文档的语义粒度、结构层级差异极大,单一的向量检索策略难以兼顾。
异构文档检索的核心挑战在于"语义对齐"问题。不同模态和格式的文档在向量化时会产生分布差异——例如,一张包含财务数据的表格与一段叙述性段落,即便语义相近,其嵌入向量在空间中的分布也可能相距甚远。传统的单一稠密检索(Dense Retrieval)依赖统一的向量空间度量相似度,对此类分布偏移(distribution shift)的鲁棒性较弱。近年来,混合检索策略(Hybrid Retrieval)——结合稀疏检索(如BM25)与稠密检索——成为应对异构文档的常见折中方案,但如何在不同文档类型间动态调整权重,仍是开放性研究问题。
分层RAG的思路
分层RAG架构试图通过"分层"来解决这一问题:先在粗粒度层面定位相关文档或章节,再逐层下钻到细粒度的段落或句子。这种由粗到细的检索方式,理论上能在保持召回率的同时提升精度,也更适合处理结构复杂的异构语料。这正是当前RAG研究的一个前沿方向,学术界与工业界都在持续探索。
作者选择这个课题,说明他确实站在了一个有价值的技术切口上。问题不在于选题,而在于如何把工程实践转化为规范的学术产出。
分层RAG的实现通常借鉴信息检索中的"粗排-精排"(Coarse-to-Fine Ranking)范式。第一阶段使用计算成本较低的检索器(如BM25或轻量级双编码器)从大规模语料中快速筛选出候选文档集;第二阶段则用更精细的交叉编码器(Cross-Encoder)或重排模型(Reranker)对候选集进行精排。在文档层级上,这一过程可以进一步细化为"文档级→段落级→句子级"的逐层下钻。与此密切相关的概念还有"索引粒度"(Indexing Granularity)——即在构建向量索引时选择以整篇文档、固定大小的chunk还是语义完整的段落作为基本单元,不同粒度的选择直接影响检索的召回与精度之间的权衡。
独立研究者的真实困境
这条帖子最值得讨论的,其实不是RAG技术本身,而是它揭示的一种普遍现象。
会做,不等于会写
许多独立开发者具备扎实的动手能力,能够搭建出可运行的原型系统,却在"写论文"这一关卡住。学术写作有其独特的范式:如何做文献综述、如何设计对照实验、如何量化评估指标、如何在已有工作的基础上定位自己的贡献。这些能力无法仅靠编码习得,往往需要有经验的研究者言传身教。
缺乏机构背书的挑战
作者反复强调自己"不来自大的教育或机构背景"。在学术圈,机构隶属关系(affiliation)不仅影响资源获取,也在一定程度上影响论文的可信度与发表机会。对于体制外的研究者,找到一位愿意指导的导师,某种程度上是打开学术大门的钥匙。
"没有导师难以成功"的执念与现实
作者引用的"一个人无法在没有导师的情况下成功"这句话,既是谦逊,也可能是一种自我设限。现实中,确实有独立研究者通过arXiv预印本、开源社区协作、公开的同行评议渠道逐步进入学术视野。导师能加速这个过程,但并非唯一路径。
给同类独立研究者的实用建议
虽然原帖只是一次简单的求助,但围绕它可以延伸出一些对独立AI研究者有价值的行动路径。
先把工作公开化
与其等待导师降临,不如先把已完成的研究整理成技术报告或博客,发布到GitHub、arXiv或个人网站。清晰、可复现的成果本身就是最好的"简历",能显著提高吸引潜在合作者的概率。
主动寻找细分领域的研究者
信息检索(IR)领域有活跃的会议与社区,如SIGIR、ECIR等。关注这些领域研究者的公开工作,通过邮件礼貌地就具体技术问题请教,往往比在社交平台泛泛发帖更有效。具体的、有准备的提问,更容易得到实质回应。
信息检索领域最重要的学术会议是SIGIR(ACM Special Interest Group on Information Retrieval),每年举办一届,是该领域的顶级会议;ECIR(European Conference on Information Retrieval)则侧重欧洲学术圈,整体规模稍小但同样具有影响力。此外,TREC(Text REtrieval Conference)是一个长期运营的评测基准项目,参与者需在统一数据集上提交检索系统结果并与他人比较,对独立研究者而言既是验证系统性能的机会,也是建立学术声誉的低门槛渠道。近年来与RAG高度相关的NLP顶会如ACL、EMNLP、NAACL也大量收录检索增强生成方向的论文,是了解该领域最新进展的重要来源。
借助开源社区协作
分层RAG是当前的热门方向,Hugging Face、LangChain等社区中有大量同好。参与开源项目、贡献代码、在讨论区展示自己的架构思路,都是低门槛的切入方式。
补齐学术写作能力
可以系统学习优秀论文的结构,尤其是RAG相关的顶会论文,模仿其实验设计与论证逻辑。学术写作是一项可以自学的技能,网络上有大量公开资源。
结语
这位Reddit用户的求助,是AI技术民主化时代一个微小却典型的注脚。工具与知识的可获得性前所未有地降低,越来越多没有传统学术背景的人能够触碰前沿技术。但从"能构建"到"能被学术界认可",中间仍有一道需要跨越的门槛。
对这位开发者而言,找到导师固然是加分项,但更关键的是把手头的分层RAG工作公开、规范化,用可见的成果去撬动机会。热情与好学是稀缺的品质,而在AI这个开放度极高的领域,这两样东西本身就有可能开辟出一条属于独立研究者的道路。
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。