Firebase AI Logic 集成 Gemini TTS:多说话人语音合成实战

Firebase AI Logic 集成 Gemini TTS,支持单次调用生成多角色无缝对话音频。
Firebase AI Logic 宣布支持 Gemini 文本转语音模型,最核心的新能力是多说话人语音配置:开发者可将不同角色名称与特定音色(如 Orus、Zephyr)绑定,在提示词中为每行文本加上说话人前缀,模型便会在一次调用中自动切换音色,输出无缝衔接的多角色对话音频。这一机制省去了传统方案中多次独立请求、客户端音频拼接与时序对齐等工程负担,将复杂的音频管线收敛进单次模型调用。对于有声书、语言学习应用、播客内容生成等场景,该能力显著降低了实现门槛,也让语音交互从"专项功能"走向 Firebase 生态下的"默认可选项"。
Firebase AI Logic 迎来语音合成能力
Firebase AI Logic 最新宣布支持 Gemini 的文本转语音(Text-to-Speech,TTS)模型,这意味着开发者可以在 Firebase 的应用框架内,直接调用 Gemini 的语音生成能力。对于长期希望在移动端或 Web 端集成语音功能的开发者来说,这是一个显著降低接入门槛的更新。
过去,要在应用中实现高质量语音合成,往往需要对接第三方 TTS 服务、管理独立的音频管线,甚至在客户端手动拼接多段音频。而这次的集成把这些能力收敛进了 Firebase AI Logic 的统一配置里,让语音生成成为模型调用链路中的自然一环。
Firebase AI Logic(前身为 Firebase Genkit 的 AI 推理层)是 Google 为移动端和 Web 端应用提供的 AI 模型接入框架,内置对 Gemini 系列模型的原生支持,并与 Firebase Authentication、Cloud Firestore 等服务深度集成。开发者通过 SDK 即可在客户端或服务端直接调用 Gemini 的多模态能力,而无需自行搭建后端推理服务或管理 API 密钥轮换。此次将 TTS 能力纳入该框架,意味着语音合成与文本生成、图像理解等能力共享同一套鉴权、配额和错误处理机制,进一步降低了多模态应用的集成复杂度。
核心亮点:多说话人语音配置
这次更新最值得关注的能力,是多说话人(multi-speaker)语音配置。以往的 TTS 调用通常只能指定单一音色,而 Gemini TTS 允许开发者在一个文本提示中,为不同的说话角色映射不同的声音。
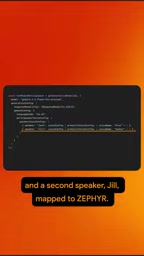
具体做法是:不再使用单一的 voice config,而是定义一个多说话人的语音配置,将每个角色名称与特定音色一一对应。例如官方演示中,把第一个说话人 Jack 映射到 Orus 音色,把第二个说话人 Jill 映射到 Zephyr 音色。
这种配置方式的优势在于,开发者不需要分别发起多次请求再拼接结果,而是在同一次模型调用中完成多角色语音的生成。
Gemini TTS 提供的音色(voice)均为预训练的声学模型,每个音色对应独特的音调、语速和情感风格。Orus 音色偏向低沉稳重,适合叙述类或权威性场景;Zephyr 音色则相对轻快自然,适合对话或青年角色。这些音色并非简单的音频拼贴,而是由模型在推理阶段动态生成,因此能够根据上下文语义自然调整语调起伏,而不会像传统 TTS 那样在句尾产生机械感。多说话人配置本质上是在同一推理请求中,让模型在不同声学参数集之间按角色标记动态切换,所有音色的时序与韵律由模型统一协调,确保最终音频在切换处听起来流畅而非突兀。
工作原理:用前缀切换声音
实现多角色对话的方式相当简洁。开发者只需在提示词中,为每一行文本加上对应的说话人名称作为前缀,Gemini 就会自动切换音色,并在一段音频响应中生成流畅的多角色对话。
换句话说,模型会识别文本中的角色标记,按照预设的音色映射动态切换声音,最终输出一段无缝衔接的音频。开发者无需在客户端做任何音频剪辑或轨道合并工作。
这种“文本驱动、模型自动处理”的模式,把复杂的音频工程问题交给了模型本身,大幅简化了开发者的实现路径。
应用场景想象
多说话人 TTS 解锁的应用场景相当广泛:
- 动态多角色叙事:如有声书、互动小说、游戏对话,可以让不同角色拥有独立声线,增强沉浸感。
- 沉浸式多语言学习应用:模拟真实对话场景,让学习者听到多个角色的自然交流。
- 播客与音频内容生成:快速生成双人或多人对谈风格的音频内容。
这些场景过去都需要开发者自行管理复杂的音频管线,或在客户端拼接多段独立的音频轨道。现在借助 Gemini TTS 的多说话人能力,这些工作都被收敛进单次模型调用中。
对开发者意味着什么
从工程角度看,这次集成的价值不只是“多了一个功能”,而是降低了语音应用的实现复杂度。开发者不再需要维护独立的音频处理逻辑,也不必担心多段音频的时序对齐问题。
对于已经在使用 Firebase 生态的团队,这意味着可以用熟悉的开发方式快速为应用加入语音交互层。对于探索 AI 原生应用的开发者,多说话人对话能力则为产品形态提供了新的想象空间。
随着 TTS 能力进一步融入主流应用开发框架,语音正在从“专项功能”变成“默认可选项”。这一趋势值得持续关注。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。