FireRouter发布:智能路由实现Opus 98%精度、成本降57%

FireRouter通过任务感知+缓存双重路由,以98.1%精度实现编程会话成本降低57%。
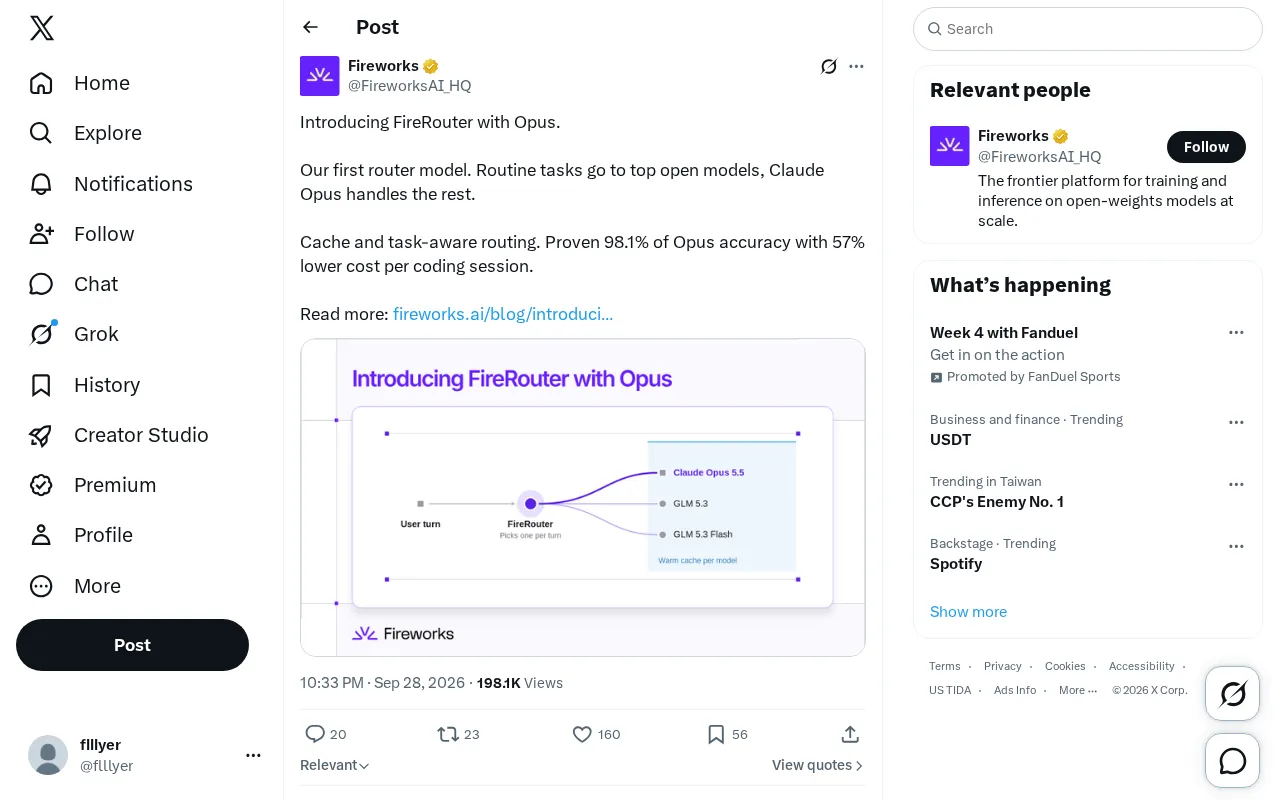
FireRouter是首款专为编程任务设计的模型路由器,核心策略是将常规任务分发给顶尖开源模型,仅将高复杂度任务交由Claude Opus处理,从而在保留旗舰模型能力上限的同时大幅降低调用成本。其技术机制结合了「任务感知路由」(通过分类判断请求难度动态分配模型)和「缓存机制」(对重复或相似请求复用历史结果),两者协同作用。官方公布的数据显示,FireRouter可达到Opus精度的98.1%,同时将每次编程会话成本降低57%。这一产品反映了AI应用层的重要趋势:模型编排正成为独立的工程品类,让系统在请求级别动态完成模型选择,而非依赖用户的一次性静态配置。不过,上述指标来自发布方自身,具体评测基准尚未公开,实际收益仍需在自身工作流中验证。
FireRouter:首款面向编程任务的模型路由器
大模型应用正进入“按需调度”的新阶段。一款名为 FireRouter 的路由模型近期发布,核心思路非常直接:把日常的、相对简单的任务交给顶尖开源模型处理,而将真正需要高推理能力的复杂任务交给 Claude Opus 来完成。这种分工让团队既能保留旗舰模型的能力上限,又不必为每一次请求都支付最高档的费用。
对于长期使用高端模型做编程辅助的开发者来说,成本一直是绕不开的痛点。Opus 这类模型在复杂代码生成、重构、调试上表现出色,但如果所有请求——包括格式化、补全、简单问答——都走 Opus,账单会迅速膨胀。FireRouter 想解决的正是这个“杀鸡用牛刀”的问题。
核心机制:缓存与任务感知的双重路由
FireRouter 的技术亮点在于它的路由策略,官方描述为 cache and task-aware routing(缓存与任务感知路由)。
任务感知路由
所谓任务感知,是指路由器会先判断请求的性质与难度,再决定把它分配给哪一类模型。常规(routine)任务被导向性能优秀的开源模型,而需要更强推理深度的任务则交由 Claude Opus 承接。这种基于任务类型的动态分配,是整套系统成本控制的关键。
任务感知路由在技术实现上通常依赖一个轻量级的「分类器」模型,它在真正的任务模型之前运行,对输入请求进行快速打分或分类。常见方案包括:基于规则的关键词匹配、经过微调的小型分类模型(参数量通常在百万到数十亿之间),以及利用嵌入向量相似度来判断任务复杂度。FireRouter 官方描述的"task-aware"机制,推测同样包含类似的前置分类步骤。值得注意的是,分类器本身的推理质量直接决定路由决策的好坏——若分类器把一道需要深度推理的架构设计问题误判为"简单任务",整个节省成本的初衷就会适得其反。这也是此类系统在落地时需要持续监控和迭代分类边界的原因。
缓存机制
缓存层则进一步减少重复计算。对于相似或重复出现的请求,系统可以复用此前的结果或上下文,避免反复调用高成本模型。在实际的编程会话中,开发者经常会围绕同一段代码反复提问,缓存的价值在这类场景下尤为明显。
两者结合,使 FireRouter 在不显著牺牲质量的前提下压低了整体调用成本。
大模型服务中的缓存通常分为两个层次:语义缓存(Semantic Cache)和提示词前缀缓存(Prompt Prefix Cache / KV Cache)。语义缓存通过计算请求的嵌入向量,查找历史库中语义相似的请求并直接返回缓存结果,完全跳过模型推理;提示词前缀缓存则由模型服务商(如 Anthropic、OpenAI)在底层实现,对请求中重复出现的系统提示或长上下文片段复用已计算的 KV 状态,从而减少 Token 计算量。Anthropic 官方的 Claude API 已支持后者,可对缓存的 Token 按折扣价计费。FireRouter 的缓存机制很可能是两者的结合,在编程会话这类「同一代码反复讨论」的场景下,长上下文的重复比例极高,缓存收益自然也更显著。
关键数据:98.1% 精度,57% 成本下降
官方给出的核心指标是:FireRouter 在编程任务上达到了 Opus 精度的 98.1%,同时让 每次编程会话的成本降低 57%。
这组数字的意义在于它量化了“质量—成本”之间的权衡。单独看,1.9% 的精度损失几乎可以忽略;而对应换来的是接近六成的成本节省。对需要大规模、高频率使用模型的工程团队而言,这样的比例足以在月度账单上产生可观差异。
需要提醒的是,98.1% 这一数据来自发布方自身的宣传,评测的具体基准、任务分布与对照设置尚未在公开信息中充分展开。真实表现仍需在各自的实际工作流中验证,尤其是在那些高度依赖 Opus 顶层能力的边缘复杂任务上。
这类路由模型为何重要
FireRouter 的出现,反映了 AI 应用层一个日益清晰的趋势:模型编排(orchestration)正在成为独立的产品品类。
过去,用户往往在“用哪个模型”上做静态选择;而现在,路由器把这个决策交给系统在请求级别动态完成。它的本质是把“模型选择”从一次性配置变成一个持续优化的运行时决策。
对开发者而言,这带来几个直接好处:
- 成本可控:高价模型只在真正需要时启用;
- 能力不打折:复杂任务依然享受旗舰模型的质量;
- 开源与闭源协同:顶尖开源模型承担主力负载,闭源旗舰作为能力兜底。
这种“开源打底、闭源补强”的组合,也体现了当前开源模型能力快速逼近闭源旗舰的现实——若非如此,把大量常规任务交给开源模型并仍维持 98% 的整体精度将难以实现。
模型编排(Model Orchestration)是指在多个 AI 模型或 Agent 之间协调任务分发、上下文传递与结果整合的系统设计范式。它是更广泛的 LLMOps(大语言模型运维)领域的核心组成部分。除了路由(Router)这一形态,编排还包括:多步骤链式调用(Chain)、并行推理后投票合并(Ensemble)、以及 Agent 自主决定是否调用外部工具或子模型等模式。FireRouter 属于其中最直接、延迟影响最小的一种——单层路由判断后即分发,不涉及多轮模型交互。随着 Anthropic、OpenAI 等厂商的模型 API 定价差异持续扩大(同一家公司的旗舰模型与轻量模型价格可相差 10 倍以上),路由层作为成本控制的「第一道闸门」,其工程价值也在迅速凸显。
适用场景与注意事项
FireRouter 明确瞄准编程会话(coding session)这一场景,这也是其公布数据的测量基础。对于以下用户,它的价值最为突出:
- 高频使用 AI 编码助手、调用量大的团队;
- 对成本敏感但不愿牺牲复杂任务质量的工程组织;
- 希望在工作流中混合使用开源与闭源模型的开发者。
不过,在采用之前仍有几点值得权衡。路由本身会引入额外的判断延迟与系统复杂度;任务分类一旦误判,可能把本该走 Opus 的难题交给了能力不足的模型,从而影响结果。因此,真实收益很大程度上取决于路由策略对特定工作负载的拟合程度。
小结
FireRouter 以“路由模型”的形态切入 AI 应用层,用任务感知与缓存两套机制实现了接近 Opus 的精度和显著的成本节省。它代表的方向——让系统在请求级别智能调度不同模型——很可能成为未来 AI 工程栈中的标准组件。至于其宣称的 98.1% 精度与 57% 降本能否在你的真实场景中复现,仍建议结合自身工作流做小范围验证后再规模化部署。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。