FLUX 3 Klein 在 NVIDIA Blackwell 上的加速部署实践

FLUX 3 Klein 搭配 Blackwell 加速扩散模型推理,压缩交互式图像生成延迟。
文章围绕 FLUX 3 Image Klein 在 NVIDIA Blackwell GPU 上的部署展开,指出扩散模型多步去噪的计算范式使推理延迟成为交互式图像产品的核心瓶颈。Blackwell 的高显存带宽与低精度算力(FP8/FP4)与 Klein 的轻量定位形成互补,共同压缩端到端延迟。文中归纳了三条通用加速路径:减少采样步数(少步采样器与蒸馏)、降低数值精度、以及编译与图优化。同时强调加速并非免费,需在延迟、画质与显存之间做三角权衡,并按业务场景设置不同质量档位,高质量成片环节仍应保留兜底模式。
FLUX 3 Klein 在 NVIDIA Blackwell 上的加速部署实践
把扩散模型塞进设计工具、图像编辑器和视觉生产流水线时,开发者最先撞上的不是模型好不好看,而是推理延迟能不能忍。生成一张图要等十几秒的体验,在交互式产品里基本等于不可用。NVIDIA 开发者博客最新一篇技术文章,专门讨论了 FLUX 3 Image Klein 在 NVIDIA Blackwell GPU 上的加速方案,本文结合该文与社区实践做一次梳理。
为什么扩散模型的推理延迟是关键瓶颈
扩散模型之所以慢,根源在于它的计算范式:一次生成需要多步去噪迭代,每一步都要跑一遍完整的神经网络前向。步数越多、分辨率越高,延迟就越线性膨胀。对于离线批量生成任务,这或许还能接受;但一旦进入设计工具的交互环节——用户拖动滑块调整 prompt、实时预览效果——延迟就直接决定了产品可用性。
NVIDIA 文章开头即点明这一矛盾:开发者在部署扩散模型时必须把推理延迟纳入架构设计,而不是事后优化。这也解释了为什么围绕 FLUX 系列模型的工程讨论,近来越来越多地集中在推理加速而非模型本身。
扩散模型的去噪过程本质上是在学习一个反向马尔可夫链:从纯高斯噪声出发,逐步预测并去除每一步的噪声,直至得到清晰图像。每一轮去噪都是一次完整的 U-Net 或 Transformer 前向传播,其中自注意力机制的计算量随图像分辨率呈平方级增长。因此,当分辨率翻倍时,单步推理耗时可能增长数倍,叠加多步迭代后,端到端延迟会迅速超出交互式场景的容忍阈值。这也是业界将推理优化重心放在注意力算子与低精度计算上的原因。
Blackwell 架构为图像生成带来了什么
Blackwell 是 NVIDIA 面向生成式 AI 负载设计的新一代 GPU 架构,其核心改进方向与扩散模型的推理特征高度契合:更高的显存带宽、更强的低精度算力,以及对注意力机制的硬件级优化。对图像生成来说,这意味着同样一次去噪步骤可以在更短时间内完成。
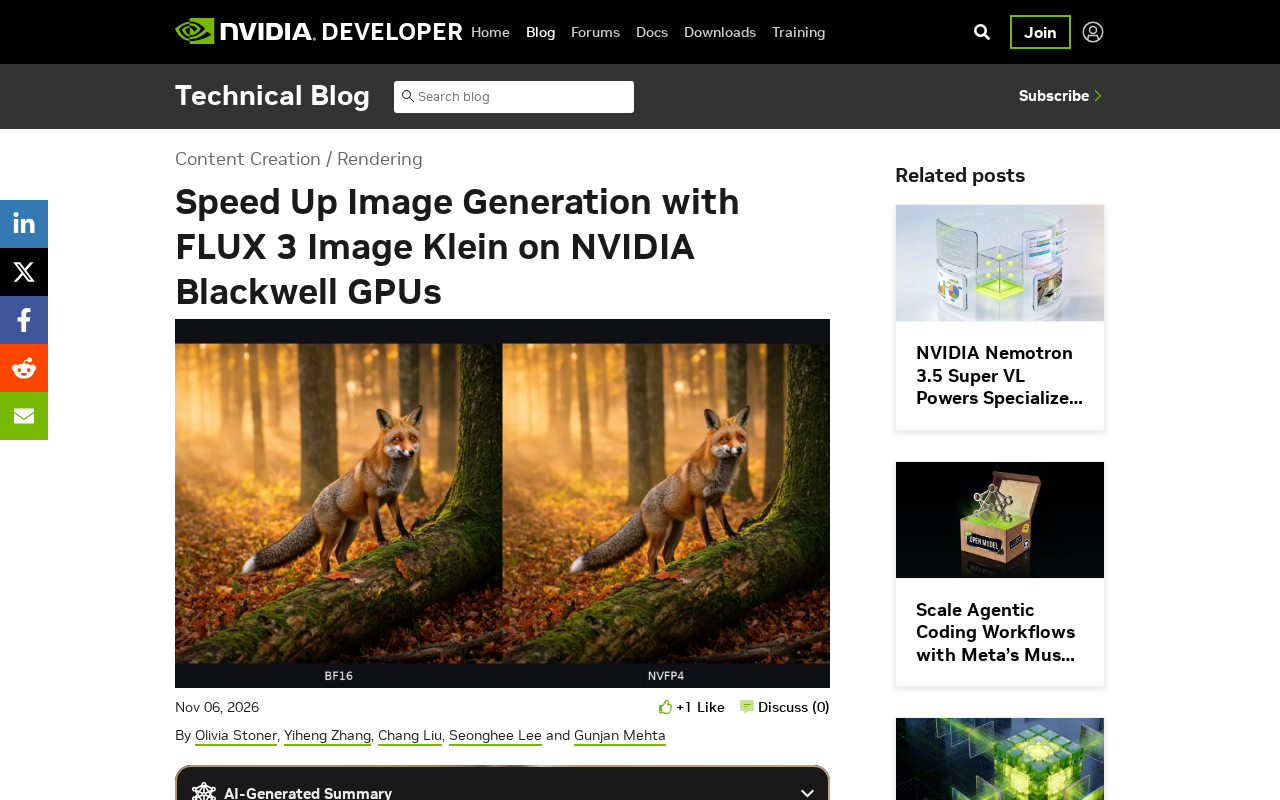
FLUX 3 Image Klein 作为 FLUX 系列中偏向轻量部署的版本,与 Blackwell 的组合逻辑很清晰:模型侧控制参数量与计算量,硬件侧提供高吞吐的低精度推理能力,两边叠加压缩端到端延迟。NVIDIA 在文中给出的示例图像——秋日森林中苔藓覆盖的倒木旁一只红狐——正是这一组合的输出效果展示。
说明:原始素材仅覆盖文章开头与一张示例图,具体的加速技术细节、性能数据与配置步骤未能获取完整。以下部分基于公开的扩散模型加速通用实践展开,供读者建立背景认知。
Blackwell 引入的第五代 Tensor Core 原生支持 FP4 与 FP6 等更细粒度的低精度格式,并配合第二代 Transformer 引擎,针对注意力计算中的矩阵乘与 Softmax 做了专门优化。此外,其 HBM3e 显存提供了更高的带宽,使得大尺寸 latent 与权重在显存与计算单元之间的搬运开销显著降低。对于扩散模型这类显存带宽敏感、计算模式规整的负载,这些改进直接转化为单步去噪延迟的下降。
扩散模型推理加速的三条通用路径
减少采样步数
最直接的思路是换用更高效的采样器,在保证画质的前提下把去噪步数压下来。少步采样器配合蒸馏类方法,能把原本几十步的生成过程压缩到个位数步。
少步采样器的代表包括 DDIM、DPM-Solver 及其变体,它们通过更高阶的数值积分方法,在较少步数下逼近原采样轨迹。而蒸馏类方法(如一致性模型、对抗蒸馏)则通过训练一个学生模型直接学习从噪声到图像的多步映射压缩,使生成步数降至 1-4 步。二者可以叠加使用,但蒸馏往往需要额外的训练资源,且对模型结构的改动较大,部署时需评估其与现有权重的兼容性。
降低数值精度
FP8、FP4 等低精度格式在 Blackwell 上得到更充分的支持。权重和激活值用低精度表示,显存占用和计算时间同步下降,对显存敏感的部署场景尤其有效。
FP8 是当前推理加速中较成熟的低精度方案,其动态范围足以覆盖扩散模型权重与激活值的分布,同时将显存占用和矩阵乘吞吐提升约一倍。FP4 则进一步压缩位宽,但需要配合分块量化与缩放因子来抑制精度损失,对量化校准流程要求更高。实际部署中,通常对权重采用较低精度、对激活值保留稍高精度,以在画质与速度之间取得平衡。
编译与图优化
把模型计算图交给推理编译器做算子融合和内存复用,能进一步挤掉框架层的开销。这部分优化与硬件强相关,也正是 GPU 厂商官方博客通常会重点展开的内容。
落地时需要注意的几个问题
加速不是免费的。步数压得太狠,细节纹理和复杂构图容易崩;精度降得太低,色彩偏移和伪影会显现。实际部署中通常需要在延迟、画质和显存之间做三角权衡,按业务场景设定阈值,而不是一味追求最快。
另外,FLUX 3 Image Klein 的定位决定了它更适合对成本敏感、对极致画质要求相对宽松的场景——比如设计工具的实时预览、电商素材的批量初稿。追求最终成片质量的环节,仍然建议保留高质量模式作为兜底。
小结
NVIDIA 这篇技术文章传递的信号很明确:图像生成模型的竞争,正在从模型能力转向部署效率。FLUX 3 Image Klein 与 Blackwell 的组合,是这条路线上的一个具体样本。对开发者而言,理解延迟从哪来、加速手段各自付出什么代价,比记住某个具体配置更有长期价值。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today