FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
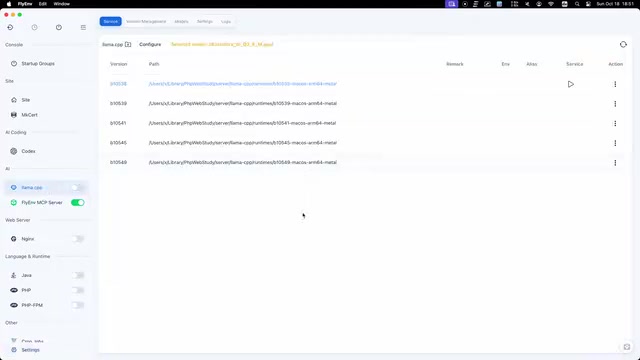
FlyEnv 推出 llama.cpp 图形插件,整合运行时、GGUF 模型与推理参数管理。
FlyEnv 发布的 llama.cpp 官方插件作为插件市场模块存在,安装即启用,无需独立维护服务进程。它支持多个 Metal 运行时版本并排共存,便于升级后回退与兼容性验证;模型库索引公共 GGUF 仓库,支持按名称搜索,并将文件标注为主模型、分片、草稿模型、MTP 与多模态投影器等类型,降低选错文件的概率。参数区覆盖上下文大小、线程数与 GPU 层数,模板、思考模式、投机解码和采样配置随模型保存,切换模型时预设自动跟随。插件还提供未保存编辑保护与一键启动服务,适合在 Apple Silicon 上频繁切换模型做对比测试的开发者,但依赖 FlyEnv 本身带来一定学习成本。
本地大模型推理的门槛正在被工具层不断拉低。FlyEnv 推出的 llama.cpp 官方插件,试图把 Metal 运行时版本管理、GGUF 模型下载与推理参数配置整合进一个图形界面。对于不想在终端里反复拼接命令行参数的开发者来说,这套方案值得关注。
插件定位:官方插件市场里的推理运行时管理器
FlyEnv 的 llama.cpp 插件并非独立应用,而是作为官方插件市场的模块存在,安装后在原位启用即可。这意味着它复用了 FlyEnv 已有的环境管理能力,用户不需要额外维护一套服务进程或配置文件。
从插件分工看,它承担的是「本地推理控制台」角色:向下管理 llama.cpp 运行时与模型文件,向上提供可视化配置入口。这种定位与 LM Studio、Ollama 等工具方向相近,但更偏向轻量集成而非全家桶。
GGUF 是 llama.cpp 项目主导的模型文件格式,全称 GPT-Generated Unified Format(沿用早期 GGML 的命名演进),设计目标是把模型权重、分词器配置、超参数和元数据打包进单个文件,便于分发和在不同硬件后端上加载。相比 PyTorch 的 .bin/.safetensors 加独立配置文件的组合,GGUF 的「一文件自包含」特性使其成为本地推理工具的事实标准,Hugging Face 上大量社区量化模型都以该格式发布。GGUF 支持多种量化方案(如 Q4_K_M、Q8_0),同一模型可据此在体积与精度间取舍,这也是模型库中同名模型存在多个文件的原因之一。
运行时管理:多个 Metal 版本并存
插件支持同时安装和保留多个 Metal 运行时版本并排共存。这对需要验证不同 llama.cpp 构建行为的用户比较实用——升级新版本后不必立刻删除旧版本,出现兼容性问题可以快速回退。
Metal 后端说明当前实现主要面向 Apple Silicon 平台,利用统一内存架构做 GPU 加速推理。插件没有把运行时抽象成单一「最新版」,而是保留版本维度,这个设计选择对稳定性优先的场景更友好。
模型库:索引公共 GGUF 仓库并在本地分类
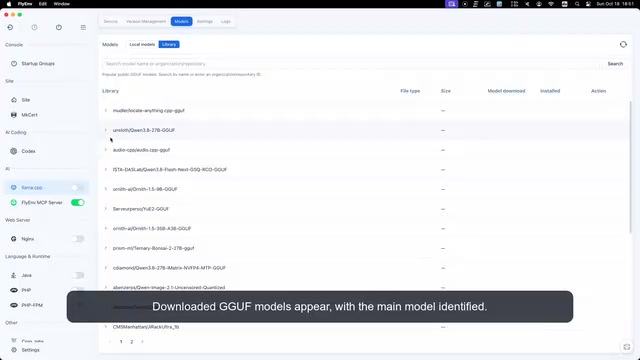
模型管理是插件的核心功能之一。据视频演示,其模型库索引了公开的 GGUF 仓库,支持按名称搜索。下载完成的模型会出现在本地列表中,并自动识别其中的主模型(main model)。
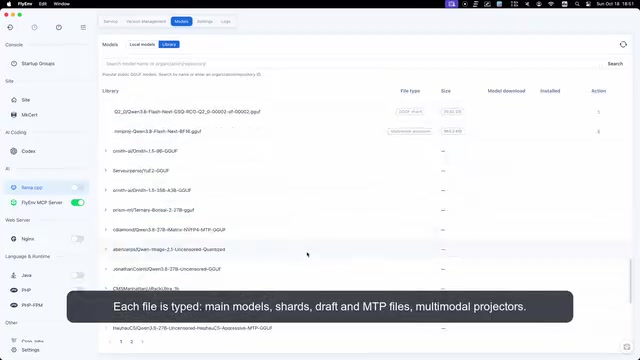
更细的一层是文件类型标注。插件会把每个文件标记为对应角色:主模型、分片(shard)、草稿模型(draft)、MTP 文件、多模态投影器(multimodal projector)。GGUF 生态里一个模型目录往往混放多种用途的文件,手动区分容易出错,类型化标注降低了选错文件的概率。
投机解码(speculative decoding)是一种在不改变输出分布的前提下加速自回归生成的推理技术:用一个更小更快的「草稿模型」先连续猜出若干候选 token,再由目标大模型一次性并行验证这些候选,接受匹配部分、拒绝不匹配部分并从分歧处重新采样。当草稿模型与目标模型分布接近时,多数候选会被接受,从而把多次串行前向压缩为少量并行验证,显著降低延迟。这也是插件把草稿模型(draft)单独标注、并与投机解码参数并列管理的原因——启用该加速需要为目标模型配套一个兼容的小模型。
参数配置:上下文、线程与 GPU 层数
模型设置区覆盖了 llama.cpp 的常用调优项:上下文大小、线程数、GPU 层数。这三项直接决定显存占用与推理速度的平衡,是本地部署中最常调整的参数。
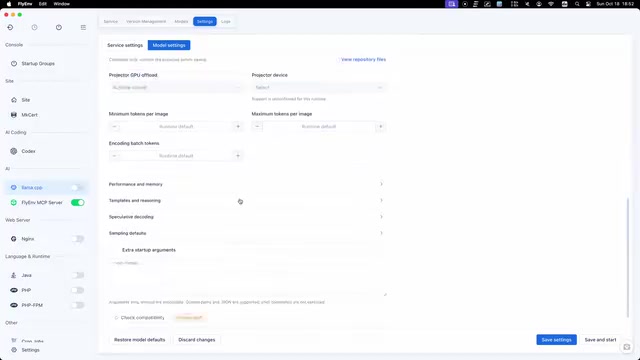
视频还提到模板、思考(thinking)模式、投机解码(speculative decoding)与采样参数会随模型一起保存。把配置绑定到模型而非全局,意味着切换模型时预设自动跟随,减少了重复配置的工作量。草稿模型与投机解码的并列出现,说明插件对加速推理链路有针对性支持。
GPU 层数(通常对应 llama.cpp 的 -ngl / --n-gpu-layers 参数)控制有多少层模型权重被卸载到 GPU 执行,其余层留在 CPU 上。由于显存容量有限,层数设得过高会导致加载失败或触发内存交换,设得过低则大量计算回落到 CPU、推理明显变慢。对 Metal 后端而言,Apple Silicon 的统一内存架构让 CPU 与 GPU 共享同一块内存,卸载策略的约束相对宽松,但仍需为系统和其他应用预留空间。实践上常从「能放下的最大层数」开始,再根据实测吞吐与显存压力回调,这与上下文大小共同决定了单次推理的内存占用上限。
使用体验:未保存编辑保护与一键启动
细节上,插件对未保存的配置修改做了保护,避免误操作丢失调整。启动推理只需一个动作,llama.cpp 随即以所选模型对外提供服务,并报告文本输入状态。
这套流程把「选模型—调参数—起服务」压缩成图形化操作,适合需要频繁切换模型做对比测试的开发者。不过插件依赖 FlyEnv 本身,对不熟悉该工具的团队存在一定的学习成本。
适合谁用
如果你的工作流集中在 Apple Silicon 上做本地 LLM 推理,且希望保留多版本运行时、需要对 GGUF 文件做类型化管理和参数持久化,这个插件提供了一套完整但不过度封装的方案。习惯命令行完全掌控的用户,可能仍会觉得图形层是额外一层抽象。
相关推荐
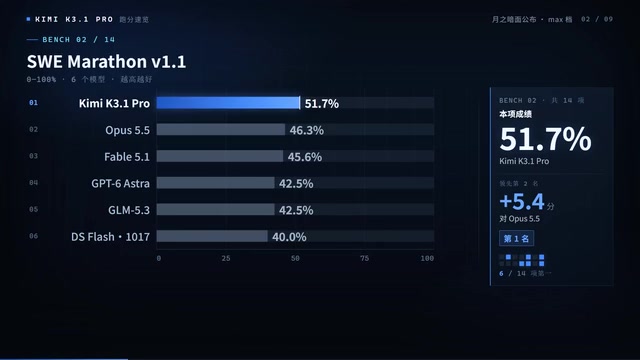
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。