StrictCite:不用AI的确定性引文核验工具,告别LLM幻觉引文

StrictCite用确定性API交叉引用对抗LLM捏造引文,完全不依赖生成式AI完成核验。
生成式AI在学术写作中大量普及,却带来一个隐蔽风险:LLM会捏造格式完整、看似真实的参考文献,包括虚假的DOI和不存在的期刊会议记录。StrictCite是一位本科研究者针对这一问题开发的确定性引文核验工具,刻意排除任何生成式AI组件,转而在浏览器本地解析BibTeX文件,并向Crossref、DBLP等13个学术注册库发起API交叉引用。同样的输入永远得到同样的输出,结果可复现可追溯。工具对完全捏造的文献识别率出色,但在预印本与正式发表版本之间存在一定假阳性;对古旧书籍、跨语言文献等边界案例的处理能力仍有限,需人工补充核查。StrictCite折射出一个更大的行业信号:AI辅助写作时代需要一层独立的确定性核验基础设施,以"可审计的软件工程方法"对抗概率模型的不确定性。
当LLM也开始编造引文
随着生成式AI在学术写作中的普及,一个棘手的问题浮出水面:大语言模型不仅会一本正经地编造事实,还会捏造根本不存在的参考文献,甚至给出失效或伪造的DOI(数字对象标识符)。对于研究人员而言,一份看似规范的参考文献列表背后,可能潜藏着大量幻觉产物。
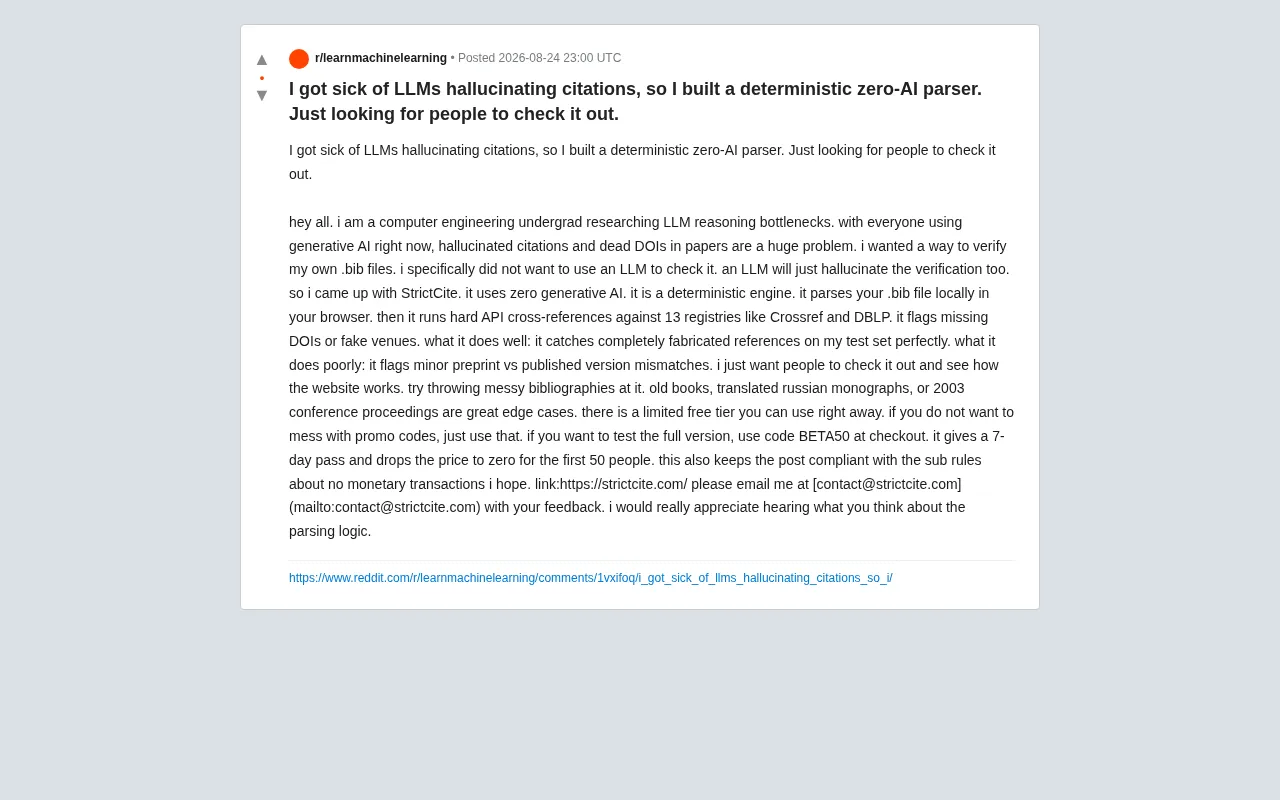
一位计算机工程本科生(同时也是LLM推理瓶颈方向的研究者)在Reddit上分享了他的解决方案。他的初衷很直接:"我受够了LLM编造引文,所以做了一个完全不用AI的确定性解析器。"这个工具就是 StrictCite。
为什么不用AI去检查AI
这里有一个值得玩味的设计哲学。开发者特别强调,他刻意避免使用LLM来做核验工作。原因很简单:如果用一个会产生幻觉的模型去验证另一个模型的输出,那么核验环节本身也可能被幻觉污染——"LLM连验证结果都会一起编造出来。"
这一判断切中了当前AI辅助研究工具的一个核心痛点。许多所谓的"AI事实核查"工具,本质上仍是概率模型的再一次采样,无法提供可靠的确定性保证。
StrictCite的技术路径与工作原理
确定性引擎,零生成式AI组件
StrictCite的核心是一个确定性(deterministic)引擎,完全不含任何生成式AI组件。它的工作流程如下:
- 在浏览器本地解析用户的
.bib文件(BibTeX格式); - 针对 Crossref、DBLP 等 13 个学术注册库发起硬性API交叉引用;
- 对缺失的DOI、伪造的会议或期刊venue进行标记。
所谓"确定性",意味着同样的输入永远得到同样的输出,核验结果可复现、可追溯。这与LLM基于概率的、每次可能不同的回答形成鲜明对比。对于学术严谨性要求极高的场景,这种可预测性至关重要。
优势与局限的坦诚披露
开发者对工具的能力边界给出了相当诚实的说明。
识别能力突出的场景:在其测试集上,StrictCite能够完美捕捉完全捏造的参考文献。对于那些凭空杜撰、根本不存在的文献条目,工具的识别率表现出色。
存在误报的场景:它会对预印本(preprint)与正式发表版本之间的细微差异产生误报。当一篇文献同时存在arXiv预印版和期刊正式版时,工具可能因版本不匹配而错误地标记为可疑。这是一类典型的"假阳性"问题——工具偏向保守,宁可多报也不漏报。
值得关注的边界测试案例
开发者主动邀请社区用"混乱的参考文献"来压力测试这个工具,并特别点名了几类具有挑战性的边界情况:
- 古旧书籍——年代久远、缺乏标准化元数据;
- 翻译的俄文专著——跨语言、跨字母系统的文献;
- 2003年的会议论文集——早期数字化不完整的记录。
这些案例恰恰是自动核验系统最容易失效的场景。老文献往往没有DOI,跨语言文献在各大注册库中的收录情况参差不齐。用这些"硬骨头"来检验,能真实反映工具在实际研究工作流中的可用性。
学术诚信工具化的行业信号
确定性核验基础设施的兴起
StrictCite本身还是一个早期项目(提供有限免费额度和限时的测试通道),但它折射出一个正在成型的需求:在AI辅助写作时代,我们需要一层独立的、可信的核验基础设施。
生成式AI极大提升了写作效率,但也把"可信度核验"这一负担转嫁给了读者和评审者。像StrictCite这样的确定性工具,本质上是在用传统的、可审计的软件工程方法来对抗概率模型的不确定性——这是一种"以确定治不确定"的思路。
对研究者使用AI辅助写作的建议
对于正在使用ChatGPT、Claude等工具辅助文献综述的研究者来说,这里有几点务实的建议:
- 永远不要信任AI直接生成的引文,尤其是DOI和具体页码;
- 核验环节应使用确定性工具(如StrictCite),而非再套一层LLM;
- 对于老旧、跨语言或非主流来源的文献,仍需人工复核,因为自动工具在这些边界处最不可靠。
归根结底,AI可以帮我们写,但"这篇文献到底存不存在"这个问题,最好交给一个不会撒谎的确定性引擎去回答。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。