技能包驱动AI智能体:告别繁琐工作流的高效方案

从工作流到智能体:一场效率革命
大模型能力持续增强,越来越多企业希望让AI直接产出可交付的成果。传统做法是搭建复杂的工作流平台,但这种方式有一个致命缺陷:节点繁琐,一旦某个环节需要修改,整个逻辑往往要推倒重写。
本文将基于B站UP主分享的实战经验,拆解一种更灵活高效的工作流构建思路——通过"技能包(Agent Skill)"的形态加载功能,让复杂逻辑收敛为少数核心节点,实现稳定又智能的自动化。
技能包的实际效果
在演示案例中,作者的工作流仅有五个核心节点,却能完成传统复杂流程才能实现的任务。所有功能以"技能包"的形式动态加载,用户只需描述需求,AI(如Kimi)便能生成对应的技能包,工作流自动接收并集成新技能。
技能包本质上是一种封装了特定领域知识、执行逻辑和输出规范的模块化配置单元。从技术角度看,它通常包含系统提示词(System Prompt)、工具调用规则(Tool Calling Schema)和输出格式约束三个层次。这种设计思路借鉴了软件工程中的「关注点分离」原则——该原则由计算机科学家Edsger Dijkstra于1974年正式提出,核心思想是将程序分解为功能独立的模块,每个模块只负责一个明确的职责领域。在AI工作流场景中,这意味着业务逻辑(如芯片分析的评测标准与输出格式)与执行骨架(节点间的数据流转)彻底解耦,修改某一领域的处理规则时,完全不必触动整个编排结构,极大降低了维护成本。
以"科技芯片分析"技能为例,AI对苹果M4芯片进行分析后,生成了一份高度标准化的测评报告,涵盖产品概述、规格参数表、架构特点、关键技术亮点、游戏性能及功耗散热测试等模块。

这种方式最大的价值在于风格一致性:严格按照技能包执行,无论分析多少次、分析什么芯片,都能得到风格统一、符合预期的报告——这正是传统"一次性提示词"难以保证的。
理解大模型:能力与三大缺陷
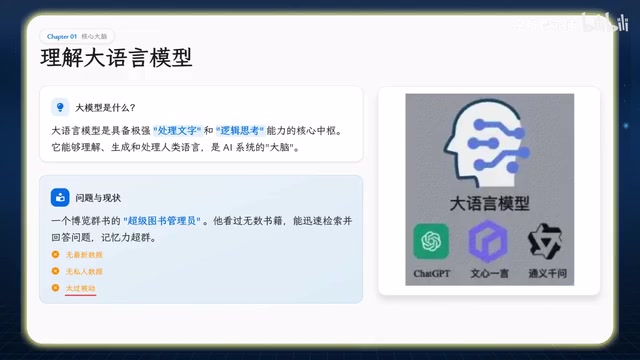
要用好工作流,首先得理解与之交互的核心——大语言模型(LLM)。其底层机制是基于Transformer架构的自回归预测:Transformer架构由Google Brain团队于2017年在论文《Attention Is All You Need》中提出,其核心创新「自注意力机制」(Self-Attention)使模型在处理每个词时能动态权衡序列中所有其他词的相关程度,从而捕捉长距离语义依赖。自回归预测则指模型每次只预测下一个Token(词元),并将已生成内容重新作为输入继续预测——这一机制也解释了为何提示词措辞的微小变化会导致输出显著差异。模型通过在海量文本上进行预训练,学习到词语与概念之间的统计关联,从而具备文本理解、逻辑推理和内容生成能力。它本质上是一个处理文字与逻辑推理的中枢,能与我们自然对话,但仍存在三个明显缺陷:
- 知识陈旧:模型参数在训练完成后固化,无法感知训练语料截止日期之后发生的事件,也无法获取最新的市场行情等实时数据。
- 缺乏私有数据:它不了解你的工作流程、消费习惯或企业内部文档,难以提供定制化服务。
- 过于被动:每次都需要用户主动提出需求,无法自主连续完成任务。
理解这三点,有助于开发者在设计工作流时合理划分哪些任务交由模型推理,哪些任务必须借助外部工具实时获取数据。
提示词工程的演变
提示词工程(Prompt Engineering)兴起于GPT-3时代(2020年前后),彼时模型规模较小、指令遵循能力薄弱,研究者发现通过精心设计的「咒语式」提示词能够显著提升模型表现。其中最具代表性的两项技术:**思维链(Chain-of-Thought, CoT)**由Google Brain的Wei等人于2022年正式发表,核心发现是在提示词中加入「逐步推理」的示例,能激活模型的中间推理过程,使数学推理、逻辑判断等任务准确率大幅提升;少样本(Few-shot)学习则源于GPT-3技术报告(2020年),仅需在提示词中提供3至5个输入-输出示例,模型便能无需梯度更新地完成新任务。这两项技术的本质是「情境学习」(In-context Learning)——通过上下文而非参数更新来临时调整模型行为,是彼时绕过高昂微调成本的关键工程手段,也正是提示词工程曾经大火的根本原因:弥补模型能力的不足。
随着GPT-4、Claude 3、Kimi等新一代模型的指令遵循能力大幅跃升,繁琐的提示词技巧逐渐让位于更自然的描述式交互。如今只需像与人交流一样,把产品、核心卖点、目标用户等描述清楚,补全细节、减少模型猜测,就能获得高质量输出,不再需要刻意"驯化"模型。这一转变本身也反映了大模型能力曲线的快速攀升。
补齐短板:多模态、联网与RAG
针对大模型的三大缺陷,业界已形成成熟的解决方案。
多模态:让AI拥有视觉与听觉
多模态大模型(Multimodal LLM)的核心技术突破在于跨模态对齐——其基础是CLIP(Contrastive Language-Image Pretraining)等对比学习方法。CLIP由OpenAI于2021年发布,训练时将4亿个图文对分别通过图像编码器与文本编码器映射为向量,再通过对比学习损失函数拉近匹配图文对的向量距离,最终使「一只在草地上奔跑的金毛犬」这句文本与对应图像在高维语义空间中落在相近位置。这种无需人工标注的自监督学习方式,成为此后几乎所有多模态大模型(包括GPT-4V、LLaVA)的核心设计参照。GPT-4V(2023年9月)的发布标志着多模态能力正式进入主流商用阶段,此后国内的通义千问广告VL、Kimi Vision、豆包视觉版等产品相继落地。
从工作流设计角度看,多模态能力的普及意味着数据输入源从纯文本扩展至截图、录屏、图表等非结构化形式,大幅拓宽了AI自动化能够处理的业务场景边界。你可以直接截图发给AI提问,把视频发给AI做总结,或借助通义万相等模型生成图片和视频。豆包的视频通话穿搭指导功能就是典型应用场景。
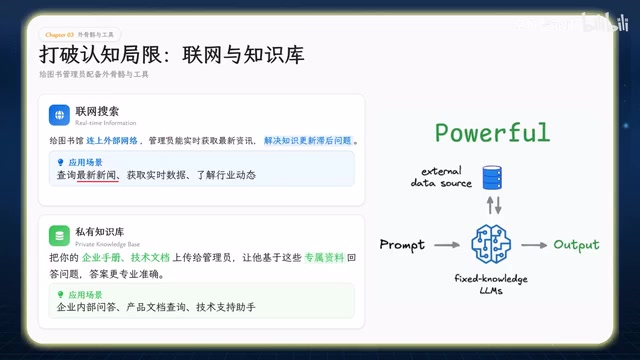
联网搜索解决知识陈旧问题
给模型接入外部网络,是解决知识截止问题最直接的方案。对于新闻、实时数据等需求,联网搜索能保证AI始终掌握最新信息,输出结果更加可靠。
RAG解决私有数据缺失
针对"不了解你"的问题,方案是构建私有知识库——将企业手册、技术文档等整理成数据库。用户提问时,系统先在数据库中检索相关片段,再与问题一并交给大模型作答,从而实现精准的定制化回答。
这正是 RAG(检索增强生成,Retrieval-Augmented Generation) 技术的核心原理。RAG由Meta AI研究团队(Lewis等人)于2020年在NeurIPS会议上正式提出,其核心洞察是:相比将知识硬编码进模型参数(参数记忆),存储在可检索的外部数据库中(非参数记忆)更具灵活性。其架构分为两个阶段:检索阶段使用向量数据库(如Chroma、Pinecone、Milvus)将文档切分为固定长度的文本块,每块通过嵌入模型转化为通常768至1536维的稠密向量,检索时借助近似最近邻算法(HNSW、Annoy等)在毫秒级内从海量文档中召回最相关的Top-K片段;生成阶段将检索结果作为上下文注入大模型,引导其基于私有知识作答。相比直接对模型进行微调(Fine-tuning),RAG的优势在于知识库可实时更新、成本极低,且能通过引用来源提升答案可信度。这使其广泛应用于企业问答、电商客服、物流客服及私人助手等场景。
工作流编排:从传统节点到AI智能体
补齐能力后,就可以正式编排工作流了。
传统工作流的局限
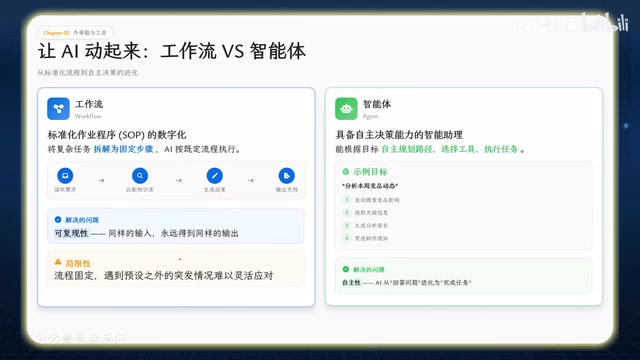
传统工作流将每一步操作都做成节点,通过拖拽连接,从开始到结束依次执行。优点是稳定——相同输入必然得到相同输出;但缺点明显:AI只是工作流中的一环,完全没有发挥其自主决策能力。
引入智能体实现自主决策
智能体(Agent)是具备自主决策能力的AI。现代LLM-based Agent通常遵循「感知—规划—行动」循环:模型首先理解用户意图,随后调用ReAct(Reasoning + Acting)框架将复杂任务分解为子步骤。ReAct由Yao等人于2022年提出,其核心是让模型在「思考(Thought)」、「行动(Action)」、「观察(Observation)」三种状态间循环迭代——模型先输出推理过程,再调用工具执行操作,观察工具返回结果后继续推理,直至任务完成。再通过**工具调用(Function Calling)**驱动外部API、数据库或代码执行器完成具体操作。Function Calling是OpenAI于2023年6月在GPT-4中正式引入的原生能力,开发者将可调用工具以JSON Schema格式描述给模型,模型判断需要使用工具时会输出结构化的调用请求,而非自由文本,应用层解析后执行真实操作并将结果返回——这使Agent从「会说话的文本生成器」变为能可靠驱动外部系统的自动化执行者。
智能体与传统工作流的根本区别在于:传统工作流的执行路径在设计时已完全确定,而Agent能够根据中间结果动态调整后续行动策略。给它一句话,比如"分析本周竞品动态",它就能自行拆解任务:搜索信息、提取关键内容、生成分析报告,甚至发邮件通知你。
将智能体的自主性与工作流的稳定性结合,就能构建出既稳定又智能、能应对复杂场景的自动化系统——这正是本文方案的核心思路。
落地方案:Scale Agent插件实战
实现上述能力的关键,是一个名为 Scale Agent 的插件。低代码/无代码(Low-code/No-code)开发平台近年来随着企业数字化转型需求的爆发而迅速普及,Gartner预测到2026年低代码应用开发将占企业应用开发总量的65%以上。在AI工作流编排领域,Flowise、Dify、Coze、n8n等开源或半开源平台已形成初步生态。
Scale Agent作为其中的插件形态,其「完全开源+本地部署」定位专门面向对数据安全有较高要求的企业用户——这类用户往往无法将内部文档上传至第三方SaaS平台,本地化部署成为绕不开的硬性需求。在低代码平台中安装后,即可获得三大优势:
- 可视化编排:拖拽式配置,无需编写代码,非技术背景的业务人员同样可以参与AI自动化建设。
- 完全开源:无需付费,安全性有保障,适合企业内部部署。
- 技能可复用:可下载他人提供的技能包借鉴经验,也可让AI辅助生成定制化技能包。
搭建高质量工作流的三要素
总结来看,构建一套可靠的AI工作流需要三个关键要素:
- 核心大模型作为大脑:优先选用能力较强的模型,以应对复杂任务并给出准确回答。
- Scale Agent插件:无需绘制复杂流程图,借助技能包快速搭建工作流。
- 智能体自主决策:用技能包规范AI行为边界,同时充分发挥AI的自主智能。
无论是否具备开发背景,都能借助这套方案让AI产出满意的成果。工作流编排的本质,正是用平台承载、用技能规范、用智能驱动——三者结合,才能构建出真正高效的自动化系统。
核心要点
核心要点
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。