格式感知融合:让FP4预训练提速两倍的工程实践

格式感知融合通过协同设计量化流程,使FP4预训练吞吐量较bfloat16基线近乎翻倍。
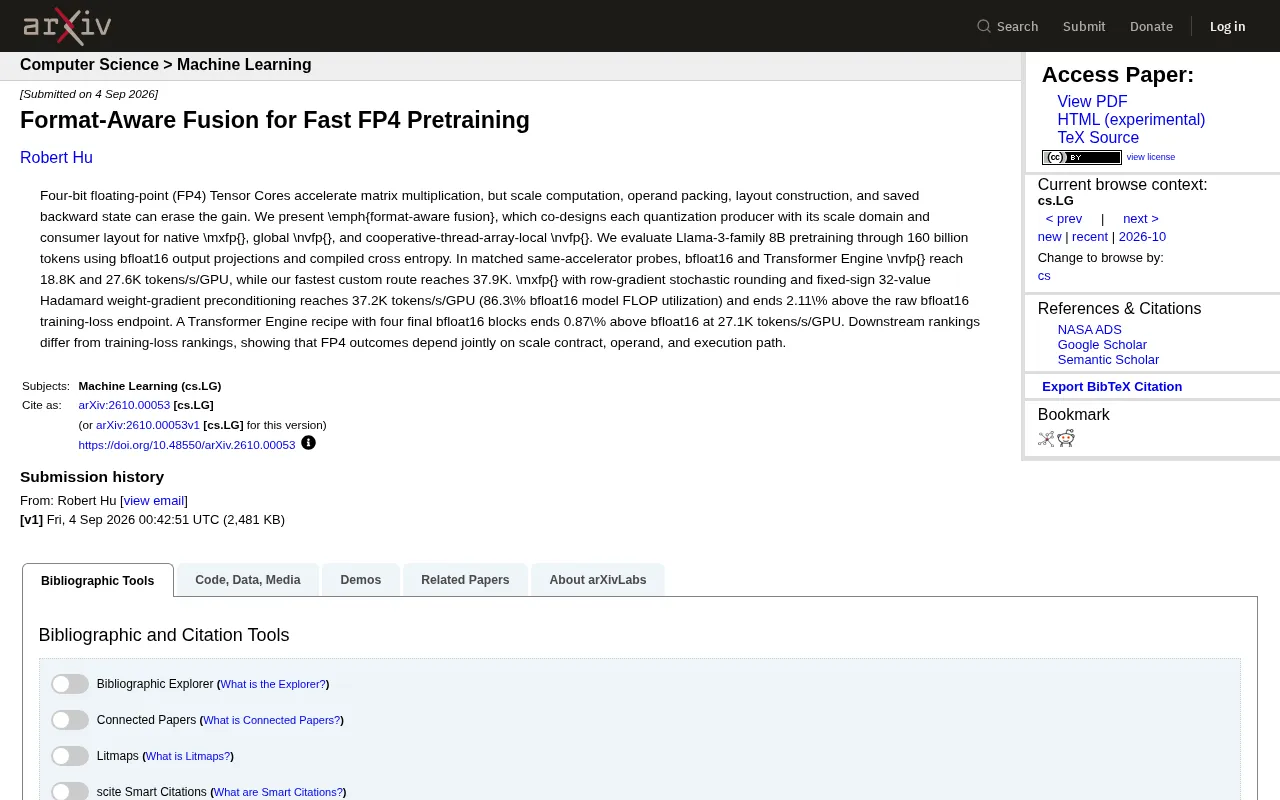
FP4张量核心的理论算力优势在实践中常被量化辅助操作(缩放因子计算、操作数打包、布局转换)的开销所抵消。arXiv:2610.00053提出"格式感知融合"(format-aware fusion),将量化生产者、缩放域与消费者布局统一协同设计,针对mxfp和nvfp两种格式分别优化执行路径。在Llama-3 8B、1600亿token的预训练实验中,最快自定义路线达到37.9K tokens/s/GPU,较bfloat16基线18.8K近乎翻倍;mxfp方案结合行梯度随机舍入与Hadamard权重梯度预处理,在86.3% MFU下训练损失仅高出bfloat16终点2.11%。论文还指出下游任务排名与训练损失排名不一致,提示FP4方案须经多维度评估,不能仅凭loss曲线做判断。
格式感知融合:让FP4预训练提速两倍的工程实践
四比特浮点(FP4)张量核心(Tensor Core)为矩阵乘法带来了诱人的加速前景,但真正落地时,缩放因子计算、操作数打包、布局构造以及反向传播状态的保存,往往会把硬件带来的收益消耗殆尽。一篇新发布的 arXiv 论文(arXiv:2610.00053)提出了名为"格式感知融合"(format-aware fusion)的方法,试图从工程层面重新设计量化流程,让 FP4 的理论优势真正转化为端到端的训练吞吐。
FP4加速为何常常"纸上富贵"
FP4 张量核心能够以极低的比特宽度完成矩阵乘法,理论上可以大幅提升算力密度。但在实际的大模型训练中,围绕矩阵乘法的辅助操作成了瓶颈。量化不是免费的——你需要计算缩放因子(scale),需要把操作数按硬件要求打包(operand packing),需要构造特定的内存布局(layout construction),还要为反向传播保存中间状态。
这些步骤如果设计不当,所消耗的时间和带宽会把 FP4 本应带来的加速完全抵消。论文的核心观点正是:FP4 的成败不只取决于计算精度,而是由"缩放契约、操作数、执行路径"三者共同决定的系统性工程问题。
FP4(4位浮点)张量核心是NVIDIA Blackwell架构(GB200/B100系列)引入的新特性。与INT4不同,FP4保留了浮点数的指数位,能更自然地表示神经网络权重和激活的动态范围分布。但FP4只有4个比特:1位符号、2位指数、1位尾数(E2M1格式),或者1位符号、1位指数、2位尾数(E1M2格式),数值表示范围极其有限。这意味着量化前必须精确计算缩放因子(scale factor)——即确定一个"缩放契约",把原始的bfloat16/float32数值映射到FP4可表示的范围内,任何误差都会直接导致溢出或精度损失。主流的两种缩放体系是:NVIDIA的nvfp(块级缩放,每个数值块共享一个缩放因子)和MX标准的mxfp(更细粒度的微缩放,由英特尔、AMD、微软等联合定义),二者在缩放粒度和内存开销上存在显著差异,也带来了不同的工程权衡。
格式感知融合的设计思路
论文提出的方法针对不同的量化格式进行协同设计。它将每一个量化生产者(quantization producer)与其对应的缩放域(scale domain)以及消费者布局(consumer layout)绑定在一起,分别适配三种场景:原生的 mxfp、全局的 nvfp,以及协作线程数组(CTA)局部的 nvfp。
这种"co-design"的理念意味着不再把量化当作一个孤立的前处理步骤,而是把它和后续的消费方式统一考虑。缩放因子在哪里计算、以什么粒度计算、数据以什么布局交给张量核心,都被纳入同一套设计中,从而避免了格式转换和布局重排带来的隐性开销。
两个关键的数值技巧
在 mxfp 路线上,作者引入了两项值得关注的数值处理技术:
- 行梯度随机舍入(row-gradient stochastic rounding):在梯度量化时采用随机舍入而非确定性舍入,有助于缓解低精度带来的偏差累积。
- 固定符号的32值 Hadamard 权重梯度预处理(fixed-sign 32-value Hadamard weight-gradient preconditioning):通过 Hadamard 变换对权重梯度进行预处理,改善低比特下的数值分布。
这两项技术是让 FP4 训练在精度上保持可接受水平的重要保障。
随机舍入(Stochastic Rounding)是一种在低精度计算中缓解系统性偏差的技术。传统的"就近舍入"(round-to-nearest)在梯度累积时会产生有偏的截断误差,低精度下尤其明显,长期累积会导致模型收敛方向偏移。随机舍入则以与误差大小成比例的概率决定向上或向下取整,从统计期望上保持无偏性,代价是引入了可控的随机噪声。Hadamard预处理则来自信号处理领域:Hadamard变换是一种正交变换,能把数据投影到一组正交基上,使变换后的系数分布更均匀、峰值更小(降低峰峰比)。对于FP4量化而言,原始权重梯度往往呈现尖锐的长尾分布,极端值会"浪费"宝贵的动态范围;经过Hadamard变换后,数值能量被均匀分散,量化误差整体降低。"固定符号的32值"指的是使用符号固定的32×32 Hadamard矩阵,避免了符号随机化带来的额外开销,使该预处理步骤可以高效地融合进核函数中。
实测数据:吞吐量翻倍,精度可控
论文在 Llama-3 家族的 8B 模型上进行了预训练评测,训练规模达到 1600 亿 token,输出投影层使用 bfloat16,并采用编译后的交叉熵。在相同加速器的对照实验中,结果相当亮眼:
| 方案 | 吞吐量 (tokens/s/GPU) | 相对训练损失 |
|---|---|---|
| bfloat16 基线 | 18.8K | — |
| Transformer Engine nvfp | 27.6K | — |
| 最快自定义路线 | 37.9K | — |
| mxfp(随机舍入+Hadamard预处理) | 37.2K(86.3% MFU) | 高于 bfloat16 终点 2.11% |
| TE 配方(末尾4个bfloat16块) | 27.1K | 高于 bfloat16 终点 0.87% |
从数据看,最快的自定义路线把吞吐量从 bfloat16 基线的 18.8K 推高到 37.9K,几乎翻倍。mxfp 方案达到 37.2K tokens/s/GPU,对应 86.3% 的 bfloat16 模型 FLOP 利用率(MFU),这是一个相当高的利用率水平,同时训练损失终点仅比纯 bfloat16 高出 2.11%。
相比之下,Transformer Engine 的配方在末尾保留四个 bfloat16 块,训练损失仅比 bfloat16 高 0.87%,但吞吐量停留在 27.1K。这体现了速度与精度之间的权衡关系。
一个容易被忽视的结论:下游表现与训练损失排名不一致
论文中最具启发性的发现之一是:下游任务的排名与训练损失的排名并不一致。换句话说,训练损失更低的方案,未必在下游评测中表现更好。
这个现象提醒从业者,不能仅凭训练损失曲线来判断某个低精度方案的优劣。FP4 的最终效果受到缩放契约、操作数格式和执行路径的联合影响,单一指标的评估可能产生误导。对于计划把 FP4 投入生产的团队而言,需要在真实下游任务上做充分验证,而不是停留在 loss 层面。
训练损失与下游任务性能脱节的现象在大模型研究中并不罕见,但在低精度训练场景下尤为值得警惕。其根本原因在于:训练损失衡量的是模型在训练分布上的平均预测误差,而下游任务(如常识推理、代码生成、指令跟随)往往依赖特定的知识表征和泛化能力,这些能力对量化引入的噪声模式更为敏感。FP4量化对不同层、不同参数的扰动并不均匀——例如注意力层的键值矩阵与前馈层的权重对量化误差的容忍度不同——这种非均匀扰动可能在损失曲线上表现为微小差异,却在特定下游能力上造成可观的退化。因此,这一发现对工程实践的指导意义是:FP4方案的验证必须建立涵盖多样下游任务的评测基准,不能以"收敛到更低loss"作为唯一的方案选择标准。
对低精度训练的意义
这项工作的价值不仅在于具体的加速数字,更在于它把 FP4 训练从"精度能不能收敛"的讨论,拉回到"系统工程如何设计"的层面。随着张量核心对更低比特格式的支持越来越完善,围绕量化的数据流设计将成为压榨硬件性能的关键战场。
格式感知融合的思路——把量化生产者、缩放域和消费者布局统一协同设计——为后续研究提供了一个清晰的框架。对于追求极致训练吞吐的大模型团队来说,这类工程级优化可能比单纯堆砌算力更具性价比。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。