Gemini 3.5 Transcribe:谷歌语音转写模型核心能力全解析

谷歌发布Gemini 3.5 Transcribe,将大模型能力融入语音识别,实现从转写到理解与执行的跨越。
谷歌推出Gemini 3.5 Transcribe,这款新一代语音转文字模型将大语言模型的语义理解与工具调用能力深度整合进语音识别流程。相比传统ASR方案,它不仅在词错误率(WER)上有所改进,还引入了函数调用、自定义词汇、多说话人识别、85种以上语言支持以及实时流式转写等面向生产环境的核心能力。其最大突破在于"智能转写+函数调用"的组合——模型在将语音转为文字的同时,能解析用户意图并直接触发外部API,将语音从被动记录工具升级为主动执行的Agent入口。这一设计大幅简化了语音应用的开发链路,也进一步巩固了谷歌Gemini多模态生态的整体竞争力。
谷歌推出Gemini 3.5 Transcribe语音转写模型
谷歌近日发布了全新的语音转文字(Speech-to-Text)模型 Gemini 3.5 Transcribe,将大语言模型的智能能力深度整合到语音识别领域。与传统的ASR(自动语音识别)方案不同,这款模型不仅追求更低的转写错误率,还引入了函数调用、自定义词汇、多说话人识别等一系列面向生产环境的实用能力。
从官方发布的信息来看,Gemini 3.5 Transcribe的定位十分明确:不只是把声音变成文字,而是提供一套可以直接嵌入应用工作流的智能语音理解系统。这标志着谷歌正在把其在大模型上的优势,系统性地延伸到语音这一关键的多模态入口。
Gemini 3.5 Transcribe核心能力解析
更精确的转写与更低的WER
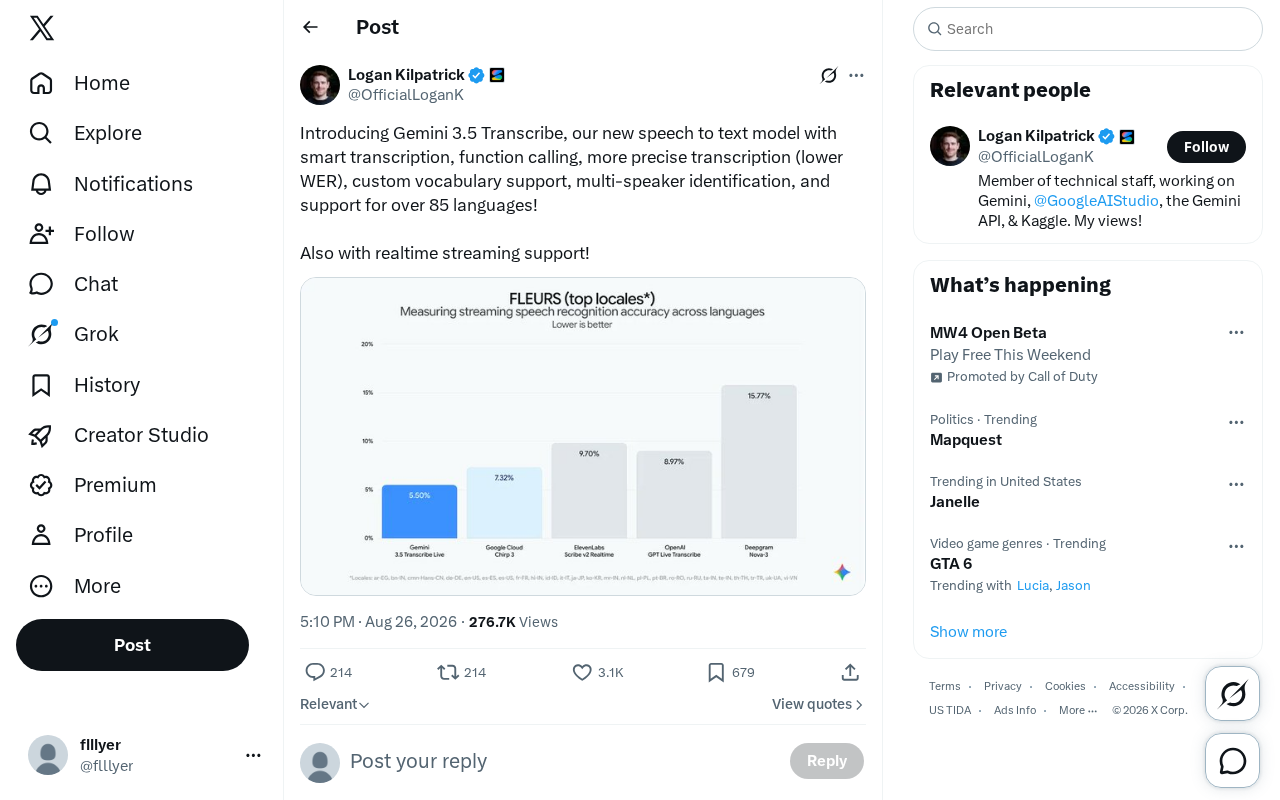
衡量语音识别质量最核心的指标是词错误率(WER, Word Error Rate)。官方强调Gemini 3.5 Transcribe实现了更低的WER,意味着在同样的音频输入下,模型能够更准确地还原原始语义内容。
对于会议记录、字幕生成、客服质检等高精度场景而言,WER每降低一个百分点,都意味着后期人工校对成本的显著下降。谷歌将大模型的语言理解能力融入转写过程,使得模型不仅"听得清",还能结合上下文进行更合理的推断,从而减少同音词、专业术语等常见错误。
智能转写与函数调用
最具想象空间的能力是**智能转写(Smart Transcription)与函数调用(Function Calling)**的结合。模型在转写的同时,可以理解语音中的意图,并直接触发外部工具或API。
举例来说,当用户在语音中说出"帮我预约明天下午三点的会议",模型不仅能准确转写这句话,还能解析出结构化的意图,并调用日历接口完成操作。这实际上把语音转写从一个"被动记录工具"升级为"主动执行的智能代理入口",为构建语音驱动的Agent应用打开了大门。
面向生产环境的实用特性
自定义词汇支持
在企业级应用中,通用语音模型往往在专有名词、品牌名、行业术语上表现不佳。Gemini 3.5 Transcribe提供了自定义词汇(Custom Vocabulary)支持,允许开发者注入特定领域的词表,从而大幅提升在医疗、法律、金融等垂直场景下的识别准确度。这是模型能否真正落地生产的关键差异化能力之一。
多说话人识别功能
模型内置了**多说话人识别(Multi-speaker Identification)**功能,能够在多人对话中区分不同的发言者。这对于会议纪要、访谈记录、播客转写等场景至关重要——它不仅告诉你"说了什么",还能标注出"谁说的",输出带有说话人标签的结构化文本。
超过85种语言支持
在语言覆盖方面,Gemini 3.5 Transcribe支持超过85种语言,为全球化部署提供了坚实基础。对于跨国企业和面向多语言市场的产品而言,单一模型即可覆盖绝大多数语言需求,显著降低了技术栈的复杂度。
实时流式转写能力
除了批处理场景,Gemini 3.5 Transcribe还支持实时流式转写(Realtime Streaming)。模型可以在音频持续输入的过程中,边听边输出转写结果,延迟极低。
实时流式能力是构建语音助手、实时字幕、在线会议辅助等交互式应用的必备条件。结合前面提到的函数调用能力,可以设想这样的场景:用户在实时对话中随口下达指令,系统即时响应并执行,几乎不存在感知延迟。这正是通往自然语音交互体验的关键一步。
分析与展望:从转写到理解和执行
Gemini 3.5 Transcribe的发布,反映了谷歌在语音AI领域的战略思路:将语音识别与大模型能力深度融合,从"转写"走向"理解"和"执行"。
过去的语音转写方案大多是独立的专用模型,输出纯文本后再交由其他系统处理。而Gemini 3.5 Transcribe通过将转写、意图理解、工具调用整合到同一模型中,大幅简化了语音应用的开发链路。开发者不再需要拼接多个组件,而是可以在单一模型的基础上快速构建端到端的智能语音应用。
值得关注的是,这一模式也进一步强化了谷歌Gemini生态的整体性。语音作为最自然的人机交互方式,正在成为各大厂商争夺的入口。随着OpenAI、谷歌等公司在多模态语音领域持续发力,未来的AI应用形态很可能从"打字输入"逐步转向"自然对话",而具备智能转写与函数调用能力的模型,将是支撑这一转变的核心基础设施。
对于开发者而言,现在正是评估和尝试这类新一代语音模型的好时机。无论是提升现有产品的语音体验,还是探索全新的语音Agent形态,Gemini 3.5 Transcribe都提供了一个值得认真考量的技术选项。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。