Gemini 3.8 语音合成实测:自定义专属AI声音

谷歌Gemini Audio推出新TTS能力,支持提示词生成、海量预设声音、多角色导演及安全声音复刻。
谷歌为Gemini Audio带来了全面升级的文本转语音功能,核心卖点包括四个层面:通过简单提示词即可生成情感可控的语音;提供超过一千种预设声音并支持音高、音色的细粒度调整;支持多说话人对白场景,创作者可像导演一样引导每个角色的表演风格;以及借助快速语音身份验证安全地复刻本人声音。整体而言,谷歌希望将TTS从单纯的朗读工具升级为面向短视频、广告、有声内容创作者的完整"配音工作台",大幅降低专业级配音的制作门槛。目前官方演示侧重功能展示,定价与上线时间等细节尚未披露。
谷歌为 Gemini Audio 带来了新一代文本转语音(TTS)能力,核心卖点是让创作者能够通过简单的提示词生成一致、富有表现力的语音,甚至可以安全地复刻自己的声音。这段官方演示以制作一支产品宣传片为线索,串联起了新模型的几项关键功能。
从提示词到富有表现力的语音
演示的开场是一个非常真实的创作场景:制作团队需要为新 TTS 模型录制一段旁白,但对第一版念白的语气并不满意,于是反复调整——"不,更像这样"、"介绍……文本转语音"。这个过程恰好展示了新模型的核心价值:把简单的文字提示(simple prompts)转化为一致且富有表现力(consistent, expressive)的语音输出。
与传统 TTS 生成的机械音不同,Gemini Audio 强调的是"按需(on demand)"生成可控的情感和语气。对于需要频繁修改配音的短视频、广告和播客创作者来说,这种即时可调的特性能大幅缩短制作周期。
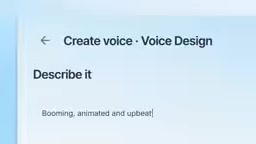
上千种预设声音与自由定制
当脚本进入需要多角色的对白场景时,演示者提到可以"从超过一千种现成的声音中挑选"(over a thousand ready-to-go voices)。庞大的声音库意味着创作者几乎不需要额外录音,就能为不同角色匹配合适的音色。
更进一步,这些声音并非固定不变。演示中直接抛出一个需求:"如果我们把这个声音调得再低沉一点呢?"——系统随即完成了调整,并强调"可以随心所欲地改变它"(change it however you want)。这种对音高、音色的细粒度控制,让预设声音库的实用性成倍提升。
多说话人对白与"导演式"控制
新模型的一大亮点是对多说话人场景(multi-speaker scene)的支持。创作者可以把保存好的多个偏好声音"拖放"到同一段对白中,快速搭建起有来有回的对话。
更有意思的是"导演"(direct them)这一概念——不仅能指定谁说话,还能引导每个角色的表演方式。演示中出现的"嗯哼"这类语气词,说明模型能够处理对话中的自然停顿和反应,而不只是逐字朗读。这让 AI 语音第一次具备了接近真人配音的场景调度能力。
传统TTS系统通常只能处理单一说话人,要实现多角色对白,制作者需要分别调用不同的声音模型,再将音频片段手动拼接,流程繁琐且难以保持语境连贯。"多说话人"(Multi-speaker)支持意味着模型在生成时能够感知对话结构,根据角色切换自动调整语气和节奏,而非简单地逐段拼接独立片段。这在技术上依赖于对对话上下文的建模——模型需要理解"谁在回应谁",从而让后一句话在音调和情绪上自然承接前一句,这也是为何"导演式引导"能够产生接近真人对戏效果的底层原因。
安全复刻你自己的声音
演示接近尾声时,创作者提出"或许应该用我自己的声音",随后念出了一段富有画面感的旁白:"灯塔看守人注视着银色的地平线,晨雾缓缓散去。"这一段展示了声音复刻(voice cloning)功能。
关键在于安全性——官方明确指出,复刻自己的声音需要通过"快速的语音身份验证"(a quick verbal identity check)来保护。这是对声音克隆滥用风险的直接回应,只有本人才能授权复刻自己的声音,避免了未经许可的语音伪造问题。在深度伪造日益普遍的背景下,这种身份校验机制是负责任 AI 落地的重要一环。
声音克隆(Voice Cloning)技术本身已发展多年,早期系统需要数小时的录音样本才能生成可用的声音模型,而近年来的神经网络方案已将所需样本压缩至数秒。然而,技术门槛的降低也带来了严重的滥用风险:攻击者可以用少量录音伪造他人声音,用于电话诈骗、虚假证据或舆论操控。谷歌在此引入"语音身份验证"的做法,与部分平台采用的"声纹授权"机制类似——用户需主动朗读特定文本,系统以此确认操作者就是声音的原始拥有者。这一机制并不能完全杜绝滥用,但它将责任链锚定在了真实身份上,配合平台的使用条款,可在法律和技术两个层面形成一定的保护屏障。
对创作者意味着什么
把这些功能串起来看,Gemini Audio 想做的是一个完整的语音创作工作流:从提示词生成,到海量预设选择,再到音色微调、多角色导演,最后落到安全的个人声音复刻。整个演示以"Give your words a voice(为你的文字赋予声音)"作结,点明了产品定位。
这段官方素材更多是功能展示,缺乏具体的定价、发布时间和技术指标细节。但从演示的完整度来看,谷歌显然希望把 TTS 从单纯的"朗读工具"升级为面向内容创作者的"配音工作台"。对短视频、广告、有声内容从业者而言,这类工具的成熟意味着专业级配音的门槛正在快速下降。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。