Gemini 4 Argon API实战:思考等级、后台模式一次讲透
Free Code Camp 20 分钟教程演示 Gemini 4 Argon 从密钥到生成打砖块游戏的全流程。
Google 最强模型 Gemini 4 Argon 已开放 API,Free Code Camp 发布了一期不到 20 分钟的速成教程,覆盖从申请密钥、环境配置到调用模型的完整路径。文章梳理了 Argon 的三大特性:先思考再作答(思考等级 low/medium/high)、超 400 万 token 上下文、后台运行能力。教程通过一个求平均分的 bug 实测了 low 与 high 思考等级在耗时和 token 消耗上的差异,建议逐级试跑选最低可用等级;用 previous_interaction_id 一行实现多轮对话记忆;最后以后台模式加 high 思考等级和 131072 的 max_output_tokens,让模型在单个 HTML 文件中生成完整打砖块游戏。文末还收录了 Google DeepMind 工程师对 Argon 创意写作与多工具协作能力的分享。
Google 最新旗舰模型 Gemini 4 Argon 已通过 API 向开发者开放。Free Code Camp 发布的一期速成教程,用不到 20 分钟演示了从申请密钥到让模型在后台生成一款打砖块游戏的完整流程。这期内容对想快速上手 Argon 的开发者来说,信息密度相当高。
Gemini 4 Argon 是什么:面向硬任务的推理模型
据 Free Code Camp 介绍,Gemini 4 Argon 是 Google 目前能力最强的模型,定位非常明确——专攻复杂编码、数学、科学这类硬任务。在代码中调用时,模型 ID 就是字符串 gemini-4-argon(视频中口述为「Gemini 4 Argon」)。
对初学者而言,有三个特性值得先建立认知:
- 先思考再作答:模型在输出前会进行推理,思考深度由
thinking level控制,可选 low、medium、high,默认为 medium。 - 超大上下文窗口:超过 400 万 token,输入、思考过程、输出共享这一额度。按视频里的说法,一个 token 大约是一个单词的小片段。
- 后台运行能力:可以把大任务交给模型,稍后再取回结果,计算发生在 Google 服务器上而非本地。
环境准备:密钥、计费与项目初始化
教程的第一步是到 Google API Studio 用 Google 账号登录,点击获取 API Key 并创建密钥。视频特别强调:密钥所属项目必须启用计费,否则 Argon 会直接拒绝请求。密钥要当作密码对待,不能写进代码,更不能推到 GitHub。
项目搭建走的是 Node.js 路线:新建文件夹、npm init、安装 Google 官方 SDK(视频中口述为 @google/genai 包),然后在 package.json 中加入 "type": "module" 以支持 import 和顶层 await。密钥存放在 .env 文件的 GEMINI_API_KEY 变量里,SDK 会自动读取该变量,代码中完全不接触密钥,.env 则写进 .gitignore。
第一次调用:interaction 是核心概念
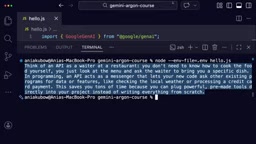
在 hello.js 中,导入 SDK 并创建 client(传空对象即可,密钥从环境变量自动获取),然后调用 client.interactions.create()。
视频把 interaction 解释为「与模型的一次往返」:送入输入,拿回输出。调用时指定 model 和 input(即提示词),最后打印 interaction.output_text 得到纯文本答案。运行时用 node --env-file 加载密钥。
第一次请求的等待时间比预期长,原因是默认的 medium 思考等级会在回答前先推理。这正好引出下一个话题。
SDK 与 API 的关系:文中提到的 @google/genai 是 Google 官方维护的 JavaScript/TypeScript SDK,它封装了底层 REST API 的鉴权、序列化与错误处理。开发者无需手动构造 HTTP 请求头或解析 JSON 响应,SDK 会读取 GEMINI_API_KEY 环境变量并自动附加到每次请求中。client.interactions.create() 等方法本质是对 REST 端点的类型化包装,返回的 interaction 对象结构也与 API 原始响应保持一致。
为什么用 node --env-file:Node.js 20.6 起内置了 --env-file 标志,可在启动时加载 .env 文件中的变量,替代了此前常用的 dotenv 包。这样密钥不会进入代码仓库,也无需额外依赖,是当前推荐的本地开发做法。
思考等级实测:low 与 high 的代价差异
为了观察思考等级的作用,教程设计了一个小实验:一段求考试平均分的函数,传入 80、90、100,期望得到 90,实际返回 NaN。
bug 本身不难找——循环用了小于等于,多跑了一次,scores[i] 为 undefined,与数字相加即得 NaN。视频用 hunt 函数包装调用,通过 generationConfig 设置思考等级,同时记录耗时和 interaction.usage 中的思考 token 数,分别以 low 和 high 各跑一次。
结果是两个等级都找到了 bug,但秒数和 token 消耗差距明显。那是否应该无脑用 high?教程给出的建议来自 Google:在三个等级上分别试跑任务,选能给出好答案的最低等级。思考 token 按输出计费,想得越多越慢越贵。像这种简单 bug,low 就足够。
思考 token 的计费逻辑:在 Gemini 的计费体系中,模型在输出前进行的推理过程(即“思考”)所消耗的 token 被归类为输出 token,按输出价格计费。这意味着 high 等级不仅耗时更长,费用也显著高于 low。interaction.usage 中通常会分别列出输入 token、输出 token 和思考 token,便于开发者核算单次调用成本。对于批量或高频场景,选对思考等级比优化提示词更能直接控制开支。
多轮对话:一行 previous_interaction_id 解决记忆
此前的每次调用都是孤立的,Argon 不记得之前问过什么。教程在 chat.js 中先让它修复上述 bug,再追问「如果数组为空会怎样」——只有模型记得那个函数,这个问题才成立。
做法是把 previous_interaction_id 设为第一次 interaction 的 ID,对话历史由 Google 侧维护,模型从上次的断点继续,并补上了防止除以零的检查。视频点评得很直白:如果要做聊天机器人,这一行基本就是「给它记忆」的全部。
后台模式:一句话生成可玩的打砖块游戏
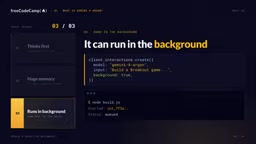
压轴演示是让 Argon 在单个 HTML 文件里写出完整的打砖块游戏。这类大任务耗时可达数分钟,普通请求可能超时,所以要启用后台模式——同一个 create 调用,改三处:background 设为 true、思考等级设为 high、max_output_tokens 提到 131072。
视频提醒,不设 max_output_tokens 时,后台模式大约在 6.4 万 token 处停止。这次 create 返回的 interaction 状态是 queued 或 in progress,需要每 5 秒用 client.interactions.get 轮询。完成后答案分散在多个 step 中,把各 model output step 的文本拼接起来写入 game.html。
整个过程在 Google 服务器上完成,可以合上笔记本稍后再取结果。最终打开 game.html,得到的是带分数、生命值和重新开始按钮的完整游戏。
轮询与 step 结构:后台模式返回的 interaction 并非最终答案,而是一个任务句柄。用 client.interactions.get 轮询时,状态会经历 queued → in_progress → completed(或 failed)。完成后,interaction.steps 是一个数组,其中类型为 model_output 的 step 才包含实际文本;思考过程、工具调用等会以其他 step 类型出现。因此拼接答案时必须过滤 step 类型,否则会把推理内容混入最终文件。这也是文中强调“把各 model output step 的文本拼接起来”的原因。
Google 工程师视角:不只是写代码
视频请到了 Google DeepMind 开发者体验团队的 Jack Weatherspoon。他最喜欢的点是:可以把想法直接抛给模型,它会做大量推理、联网搜索,最终给出一个你可能自己都没完全想清楚的优雅方案。
他提到的一个演示案例颇具说服力:同事 Genevieve 拍下自家书桌的照片发给 Argon,要求转成 3D 赛车场景。模型通过 Blender MCP 搭建了各组件,用 nano banana 生成车身和背景贴图,还上网搜索引擎音效并自行加入音频。
被问到不那么显眼的用例时,Weatherspoon 的回答是创意写作。他认为 Argon 是市面上他最喜欢的写作模型,行文不像 AI,也没有很多模型的固定套路——团队在写作训练上投入了大量研究。
Blender MCP 与 nano banana:MCP(Model Context Protocol)是一种让模型调用外部工具和服务的开放协议,Blender MCP 即通过该协议把 Blender 的建模、材质、渲染能力暴露给模型。模型可以像调用函数一样创建物体、设置灯光、导出场景。nano banana 是 Google 的图像生成模型(Gemini 2.5 Flash Image)的社区昵称,擅长保持角色与风格一致性,文中用它生成车身和背景贴图,正是利用了这一特性。两者结合,使“照片→3D 场景”的端到端自动化成为可能。
上手建议
这期教程的价值在于把 Argon 的几个关键开关串成了一条可复现的路径:思考等级决定成本与速度的平衡,previous_interaction_id 提供对话记忆,后台模式加足够的 max_output_tokens 撑起长任务。对已经会写几个 JavaScript 函数的开发者来说,跟着走一遍就能把 API 跑通。剩下的,就是拿自己的项目去试。
相关推荐
Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。
Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。
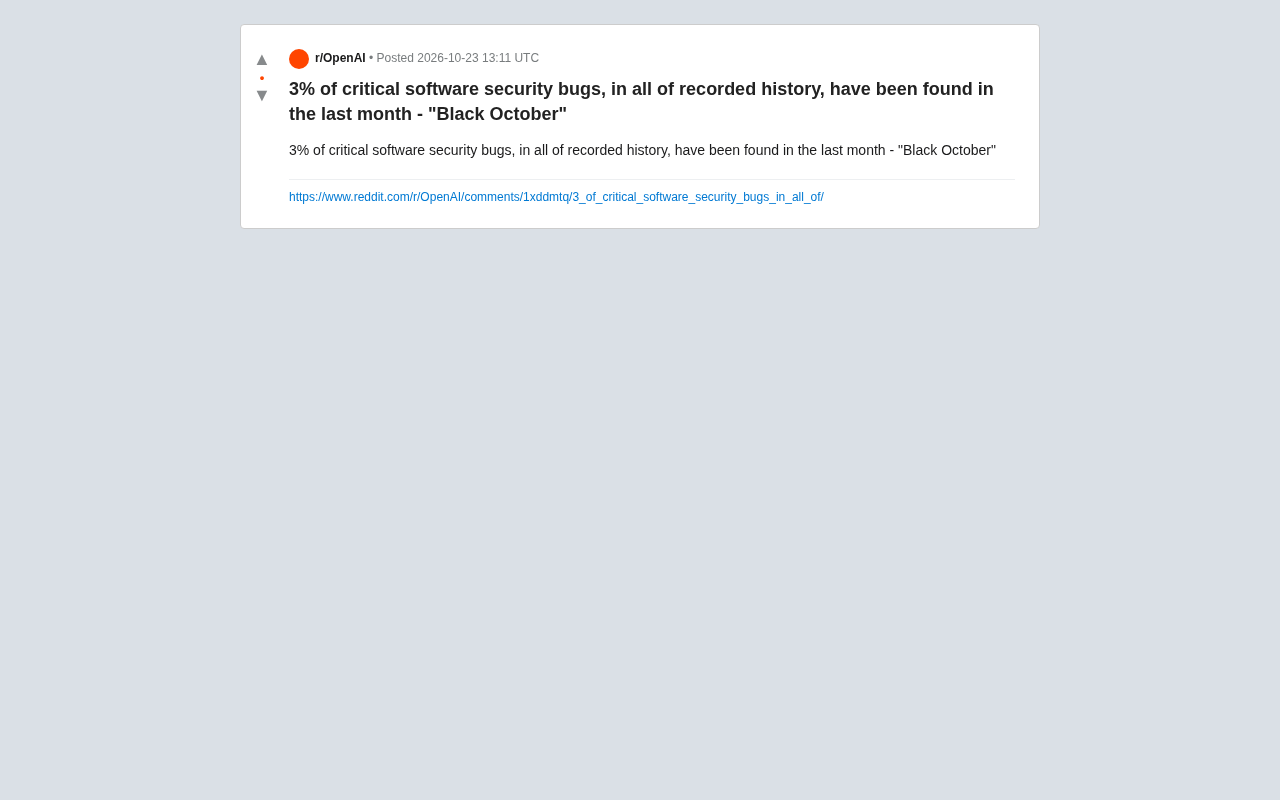
“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。