Gemini 4 Argon vs Claude Opus 5.5:Google 终于回归?
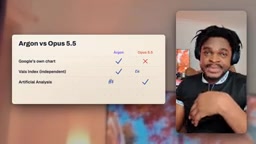
Gemini 4 Argon 让 Google 重回第一梯队对话,但并非最强,且短板与隐患明显。
Google 发布 Gemini 4 Argon 后,创作者 Ebenezer Don 实测认为它是 Google 很久以来首款能与 Claude Opus 5.5 同台竞技的模型,但并非最强。Argon 在 VAUX 独立榜单排名第一、与 Opus 基本持平,但在 artificial analysis 仅排第八,表现高度依赖任务类型。实测中 3D 生成惊艳,UI 设计和等待体验却明显落后于 Opus。价格方面,每 token 约为 Opus 一半,但 12 月 1 日起翻倍,且完成同一任务消耗 token 数超过 GPT-6 Astra 两倍。Google 产品线混乱也削弱了用户信任。作者建议用户用真实工作测试,而非轻信图表或 Demo。
Google 发布 Gemini 4 Argon 后,科技圈迅速分成两派:一派认为 Google 终于回到第一梯队,另一派则翻出 Google 过往“跳票”的历史,提醒大家别急着庆祝。YouTube 创作者 Ebenezer Don 在实测后给出了一个相对克制的结论:Argon 是 Google 很久以来第一款真正能和 Claude Opus 5.5 同台竞技的模型,但它并不是最强的那个。
发布背景:从跳票到全民可用
Google 此前承诺的 Gemini 3.5 Pro 曾计划在夏季推出,但最终没有落地。Argon 最初也只面向“可信合作伙伴”开放,外界一度担心它会重蹈覆辙。如今 Argon 终于向所有用户开放,Google 官方将其定位为编码、商业工作和网络防御场景下的最佳模型,并在自家图表上把 Argon 排在 Opus 5.5、Fibu 5.1 和 GBD6 Astra 之前。
不过 Google 在图表脚注中承认,对其他多数模型的测试并非由 Google 自己执行,而是直接采用了各家公司公布的自我评测数据。这一点与 Meta 本周被诟病的行为类似,但区别在于:Argon 在独立榜单上确实拿到了第一名。
独立榜单上的真实位置
在 VAUX 指数——一个覆盖金融、法律和编码任务的独立排行榜上,Argon 排名第一,Opus 紧随其后,二者基本持平。但运行成本目前约为 Opus 的两倍。而在 artificial analysis 这个曾揭穿 Meta 排名的独立指数上,Argon 仅排第八,落后于 Opus,甚至落后于 MuseWonder。
两个独立榜单给出截然不同的结论,说明 Argon 的表现高度依赖任务类型。这正是它“不是世界最强,但已进入战局”的写照。
VAUX 指数与 artificial analysis 的差异:VAUX 指数是一个聚焦金融、法律和编码任务的独立评测榜单,其测试集更贴近专业工作场景,因此对模型在结构化推理和长上下文处理上的能力较为敏感。而 artificial analysis 是一个综合性的独立模型评测平台,覆盖推理、知识、编码、数学等多维度,并会公开测试方法和原始数据,曾因揭穿 Meta 的排名争议而受到关注。两者排名分歧的原因在于任务分布不同:Argon 在专业垂直任务上表现突出,但在更广泛的综合能力上仍有短板。这也提醒读者,任何单一榜单都只能反映模型能力的一个侧面,选择模型时应结合自身任务类型参考对应榜单。
实测表现:3D 惊艳,UI 拖后腿
Ebenezer Don 在 Gemini 应用中用 Pro 账户进行了实测(目前 Pro 用户只能在此使用 Argon,Anti-Gravity 工具仅限 Ultra 用户)。
第一个测试是熔岩灯。Argon 生成的版本“还不错”,但蜡会卡在顶部,而且它自作主张在灯上叠了一个控制面板。更糟的是等待过程:将近三分钟没有任何进度反馈,用户也无法切换到代码视图查看它在做什么。
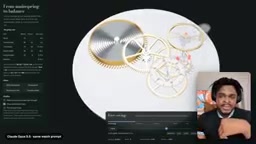
第二个测试是机械手表。Argon 用时约五分钟,3D 部分表现远超预期——金色质感、光照、轮子运动都很到位。但 3D 之外的设计却像是两三年前的模型水平,画面还会闪烁。同一个提示词交给 Claude Opus 5.5,虽然耗时更长,但整体更精致、无闪烁、细节经得起放大。
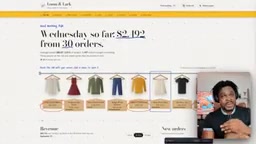
第三个测试是纯前端创意:为小型服装网店构建最有创意的管理后台。Argon 用时约三分半,Opus 用时约十七分钟。Argon 的产出“不难看”,但只是常规的卡片、聊天框和数据表,缺乏创意。Opus 则把导航做成卷尺,商品挂在布架上、价签低库存标红,新订单像小票一样打印出来,点击商品还能看到尺码、销量和补货提醒。浅色主题甚至用了方格纸和手绘笔记。
在 Bug 修复测试中,Argon 表现不错:不到一分钟就找到了限流器中的缺陷,解释清楚并给出两个正确修复方案。
Gemini 应用、Anti-Gravity 与 AI Studio 的定位差异:Gemini 应用是面向普通用户的对话式入口,提供 Pro 和 Ultra 订阅层级;Anti-Gravity 是 Google 面向开发者的智能体编程工具,强调自主执行和多步骤任务;AI Studio 则是面向开发者的模型试验场,提供 API 调试和原型构建能力。三者功能存在重叠,但订阅权限并不互通——Pro 用户可在 Gemini 应用中使用 Argon,却无法在 Anti-Gravity 中调用,只有 Ultra 用户才能使用 Anti-Gravity。这种权限割裂加剧了产品线混乱,也让用户难以判断该在哪个入口完成工作。
价格陷阱与生态混乱
Argon 目前每 token 价格约为 Opus 的一半,但这只是 introductory price——12 月 1 日起价格翻倍,届时与 Opus 持平。artificial analysis 还发现,Argon 完成同一任务所需的 token 数超过 GPT-6 Astra 的两倍。便宜的单 token 价格,不等于便宜的单个任务成本。
另一个让用户头疼的问题是 Google 产品线的混乱。Gemini 应用、Anti-Gravity、AI Studio 功能重叠,Pro 用户在 Gemini 里有 Argon,却在 Anti-Gravity 里用不了。Google 还曾将 Project IDX 改名为 Firebase Studio 后关闭,Gemini CLI 也在六月对 Pro 和 Ultra 用户下线,由 Anti-Gravity CLI 取代。
Introductory price(介绍性定价):这是云服务和 AI 模型发布时常见的定价策略,厂商以低于长期水平的折扣价吸引早期用户试用和迁移,通常设有明确的截止日期。Argon 目前每 token 价格约为 Opus 的一半,但官方已注明 12 月 1 日起翻倍,届时与 Opus 持平。这种定价方式容易让用户在对比时产生“更便宜”的错觉,却忽略了价格恢复后的长期成本。更关键的是,单个任务的总成本还取决于 token 消耗量——artificial analysis 发现 Argon 完成同一任务所需的 token 数超过 GPT-6 Astra 的两倍,这意味着即使单 token 价格较低,实际完成任务的成本可能反而更高。评估模型成本时,应以“每任务成本”而非“每 token 价格”为准。
结论:Google 回来了,但能待多久?
Argon 确实让 Google 重新回到了与 Opus 同一场对话中,甚至可以说是 Google 在竞争中的“回归之作”。但它不是最强模型,UI 生成能力和等待体验仍有明显短板,价格优势也只是暂时的。
更值得警惕的是历史模式:Gemini 3 Pro 发布时外界也曾以为 Google 回来了,但之后并未持续缩小差距。Argon 会不会只是 Google 在 2026 年的一次“打卡”,然后等到 2027 年再“回归”一次?这取决于 Google 能否在模型迭代之外,把产品生态的混乱一并解决。
对普通用户来说,最务实的建议来自创作者本人:用自己的真实工作去测试,而不是相信任何一方的图表或别人的 Demo。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。