Gemini 4 Argon与Opus 5.5打平?每任务成本反高50%
Gemini 4 Argon 性能比肩 Opus 5.5,但 token 消耗更高导致每任务成本反超 50%。
Google 发布全新稀疏 MoE 架构的 Gemini 4 Argon,支持约百万 token 上下文,在 Cursor 编程基准上与 Claude Opus 5.5 几乎打平(52.8% vs 52.5%)。但每百万 token 价格仅为其一半的 Argon,完成同一任务的账单却高出约 50%,原因是输出 token 消耗达 2.7 至 2.8 倍。API 有三处关键变化:输入、思考与输出共享百万 token 预算并支持后台分块模式;思考常开、分三档且按输出计费,温度参数被忽略;显式缓存移除,改为隐式前缀缓存,命中可享 95% 折扣。独立测试显示 Argon 通过率更高但账单更贵,且排名高度依赖测试方:终端类基准 Claude 领先,Frontier SWE 由 Astra 领跑。文章建议团队改用“每个合并 PR 成本”作为评估指标,并在 12 月 1 日涨价前完成自有 PR 重放对比。
Gemini 4 Argon 来了。Google 称其为全新架构的稀疏混合专家模型,而非旧模型的微调。在 Cursor 的编程基准上,它与 Claude Opus 5.5 几乎打平:默认设置下 52.8% 对 52.5%。但一个反直觉的数据是:Argon 的每百万 token 价格只有 Opus 的一半,完成同一任务的账单却高出约 50%。这背后的逻辑,值得每个用 API 做 agent 的团队重新算一遍账。
Argon 是什么:新架构与三个 API 变化
Argon 是 Google 首个 Gemini 4 系列模型,支持约百万 token 的上下文窗口。Google 未公布其具体参数量,只说明它是稀疏混合专家架构。定价方面,当前为每百万 token 输入 2 美元、输出 10 美元,与 Sonnet 5.5、GPT 6.1 同档;12 月 1 日起将涨至 4.20 美元,与 Opus 对齐。
对开发者影响最大的是三处 API 设计。其一,输入、思考与输出共享约百万 token 的预算,普通调用最多返回约 6.5 万 token,开启后台模式后服务器以 64k 分块持续推进,单次响应上限接近百万 token——代价是延迟,困难提示可能需要数分钟。其二,思考功能常开,可选低、中、高三档,默认中档,温度参数被忽略,且思考 token 按输出计费,Google 明确警告它可能比旧模型消耗更多预算用于思考。其三,显式缓存被移除,依赖创建缓存的 agent 代码必须改造,取而代之的是隐式缓存——只要请求共享前缀,缓存输入可享 95% 折扣。
稀疏混合专家(Sparse Mixture of Experts, MoE)架构的核心是“用多少算多少”:模型内部包含大量专家子网络,但每次前向传播只激活其中一小部分(通常是 top-k 路由),因此总参数量可以很大,而单次推理的计算量远小于同等参数量的稠密模型。这正是 Argon 能在百万级上下文下维持可用延迟的基础。稀疏性也带来工程挑战——专家并行需要跨设备通信,路由不均衡会导致部分专家过载;同时“总参数”与“激活参数”两个数字含义不同,前者影响显存占用,后者才决定推理算力,比较模型时不能只看总参数量。
隐式前缀缓存(implicit prompt caching)与文章提到的显式缓存是两种不同的工程路径。显式缓存要求开发者主动创建缓存对象、管理其生命周期与 TTL,控制精细但代码耦合度高;隐式缓存则由服务端自动识别请求开头的相同前缀,命中即按折扣计费,开发者无需改代码。其代价是“前缀必须逐 token 完全一致”——系统提示词里任何动态内容(时间戳、用户名、随机 ID)出现在前缀中,都会导致后续全部失效。这也是为什么文章强调“缓存 token 始终为零时先修提示词前缀”,以及有测试者见到失效导致成本放大数倍。
Google 的自证与一次独立复现
Google 给出的案例中,最实用的是让其优化自家的 ADK Python agent(约 20 万行代码)。Argon 无人值守运行 11 小时,提出六项优化,两项被采纳并上线,使长会话的准备时间缩短约 40%,另外四项被人审否决。
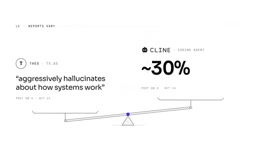
独立测试则提供了另一面。开发者 Paddo 在生产 monorepo 上重放了六个真实改动,每个模型跑 20 次,用原始测试评分。Argon 有 16 次全部通过,Opus 为 13 次,且 Argon 从未破坏原本通过的测试。但 token 消耗上,Argon 写出的输出 token 是 Opus 的 2.8 倍,账单 58 美元对 46 美元。Cursor 的观察类似:约 2.7 倍 token 换来相同分数。不过结果并不一致——Theo(T3.gg)反馈它在真实编码中“对系统运作方式有严重的幻觉”,而 coding agent Klein 则称 Argon 比 Claude 系模型少用约 30% token。
“思考 token”(reasoning tokens)指模型在给出最终回答前生成的内部推理内容。它们不直接展示给用户,但在 API 计费上通常计入输出侧,因为消耗的是相同的解码算力。思考档位(低/中/高)本质是控制推理链的长度上限:档位越高,模型自我检查与回溯的次数越多,简单任务上这是纯浪费,困难任务上则可能决定成败。这解释了文章中的一个看似矛盾的现象——同样一道题,高档模型分数更高但账单也更贵,而“保留能通过的最低档”正是用通过率换取成本的标准做法。此外,思考常开且忽略温度参数意味着采样随机性被压缩,同一输入多次运行的方差会变小,复现测试时这一点对评分稳定性有直接影响。
排名取决于测试方:没有单一赢家
Google 在发布表中让 Argon 以最高思考档运行,其他模型则混用实验室数据与公开榜单,且遗漏了与 Argon 当前同价的 Sonnet 5.5 和 GPT 6.1。独立榜单补上了这些空白:Val's AI 在统一 agent 下运行 Terminal Bench 4,Argon 得 57.6,Opus 65.2,Sonnet 64.1;Proximal 的 Frontier SWE 每任务给 20 小时,Argon 55,Astra 65.5。但 Argon 在 Val's Index of Professional Work 上排名第一,Artificial Analysis 也将其评为与 GPT 6 Astra 同级。结论是分场景的:长调用与知识工作 Argon 领先,终端类基准 Claude 占优,Frontier SWE 则由 Astra 领跑。
别比每 token 价格,比每个合并 PR 的成本
真正可操作的建议是换一套度量:停止比较每 token 价格,改比“每个合并修复的成本”。具体做法是,挑选团队已合并的 5 到 10 个 PR,在干净快照上逐一重放,用随修复一起提交的测试来评分;Argon 分别以低、中、高三档运行,保留能通过的最低档——这也是 Google 自己的建议;记录通过率、输出 token 与缓存 token。如果缓存 token 始终为零,先修提示词前缀,有测试者见到前缀失效导致成本放大六倍以上。最后用同样的 PR 跑一遍当前模型,赶在 12 月 1 日涨价前完成对比。
Argon 是真正的前沿模型,百万级输出能力也是新东西。但标价是按 token 计的,账单是按任务结的。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。