Gemini 4 Carbon 登陆 Devin:编码基准得分跃升,成本更低

Gemini 4 Carbon 上线 Devin 双端,基准得分提升至 40.0% 且成本更低。
Devin 宣布 Gemini 4 Carbon 正式上线 Devin Desktop 和 Devin CLI,替代前代 Gemini 4 Argon。新模型在编码基准 FrontierCode 2.0 上的得分从 26.3% 提升至 40.0%,同时每任务成本更低,实现性价比双向改善。Devin 作为 AI 编码代理平台,通过双端覆盖桌面可视化与 CLI 自动化两类工作流。文章分析了基准提升的意义、成本下降在批量任务中的放大效应,并建议开发者保留 Argon 作为对照,用既有任务集对比测试后再切换默认模型。整体来看,这是一次偏向实用主义的更新,以基准得分和成本两个核心指标说话。
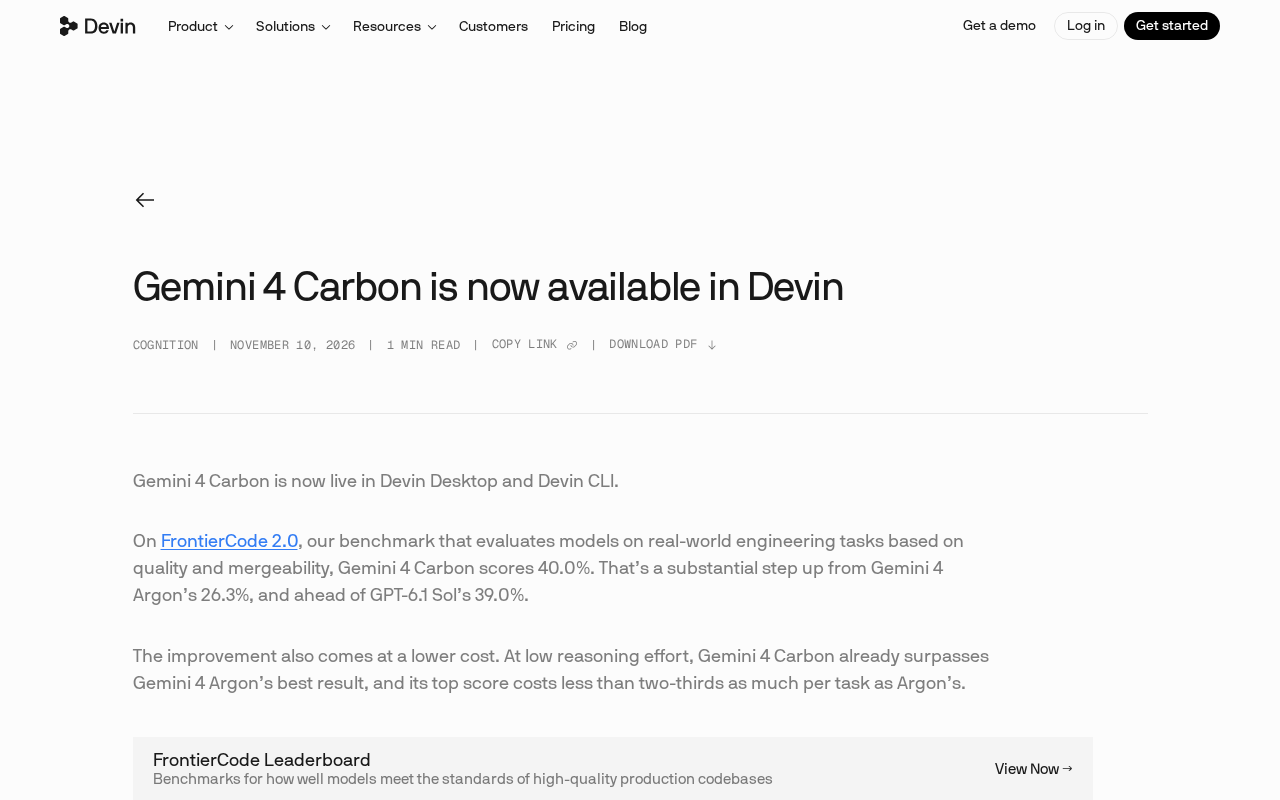
AI 编程工具 Devin 宣布,Gemini 4 Carbon 已正式上线 Devin Desktop 和 Devin CLI。相比上一代 Gemini 4 Argon,新模型在编码基准 FrontierCode 2.0 上的得分从 26.3% 提升至 40.0%,同时每任务成本更低。这一变化对依赖 AI 编码代理的开发者来说值得关注:更强的基准表现叠加更低的单任务开销,意味着在相同预算下能完成更多复杂编码任务。
Gemini 4 Carbon 在 Devin 中的定位
Devin 是一个面向软件工程的 AI 代理平台,提供桌面端和命令行两种交互形态。此次 Gemini 4 Carbon 同时接入 Devin Desktop 和 Devin CLI,说明平台希望让开发者在图形界面和终端工作流中都能获得一致的模型能力。
从命名看,Carbon 是 Gemini 4 系列的一个版本,而 Argon 是其前代。Devin 选择在这个时间点上线 Carbon,核心卖点是编码能力的提升和成本的下降。对于把 Devin 当作日常编码助手的用户,模型切换通常不需要额外配置,但实际体验会反映在任务完成率和交互轮次上。
需要说明的是,Gemini 4 Carbon 与 Gemini 4 Argon 均属于 Google 的 Gemini 4 模型家族,Devin 作为第三方集成平台,通过 API 调用这些模型来完成编码任务。Devin 本身并非模型开发者,而是一个代理商,它将 Cognition 公司开发的自主代理能力与外部大语言模型结合。因此,模型切换通常涉及后端配置更新,对终端用户透明。这种架构意味着 Devin 可以灵活接入不同供应商或版本的模型,开发者需要关注的是模型在具体任务上的表现,而非底层技术细节。
FrontierCode 2.0 得分:40.0% 意味着什么
FrontierCode 2.0 是一个编码基准测试。根据官方披露,Gemini 4 Carbon 在该基准上的得分为 40.0%,而 Gemini 4 Argon 为 26.3%。接近十四点的绝对提升,在编码基准中属于比较明显的进步。
需要客观看待的是,40.0% 的绝对得分说明这类基准测试仍具有相当难度——模型并非在所有任务上都能通过。但基准分数的主要价值在于横向对比:同一测试条件下,Carbon 相对 Argon 的提升幅度,能帮助开发者判断是否值得切换。对于已经在 Devin 中运行自动化编码流程的团队,这种提升可能直接转化为更少的失败重试和人工干预。
成本维度的变化
官方同时提到 Gemini 4 Carbon 的每任务成本低于 Argon。将“得分更高”和“成本更低”放在一起,性价比的提升是双向的。AI 编码代理的运营成本往往由多次模型调用累积而成,单任务成本下降在批量任务场景下会被放大。
FrontierCode 2.0 是评估 AI 编码代理能力的基准测试之一,其设计通常包含多步骤编程任务,要求模型理解代码上下文、编写可运行代码并通过测试。与单轮代码生成基准不同,FrontierCode 更注重代理在完整任务生命周期中的表现,包括错误修复和迭代。40.0% 的得分表明模型能完整解决约四成的测试任务,其余任务则部分或完全失败。这类基准的绝对分数受任务难度和评分标准影响,因此横向对比同一基准下的不同模型版本更具参考价值。
在 AI 编码代理的语境中,“每任务成本”通常指完成一个典型编码任务所消耗的模型调用费用总和,包括多次交互、代码生成、测试运行等环节。由于代理式工作流往往需要多轮模型调用,单次调用价格的微小差异会在任务级别被放大。成本下降可能源于模型推理效率提升、输出 token 减少或定价调整。对于批量处理任务的团队,每任务成本降低直接减少了运营预算,使得在相同支出下可以尝试更多任务或扩大自动化范围。
对开发者工作流的影响
Devin Desktop 和 Devin CLI 的双端上线,覆盖了两类典型使用场景。桌面端适合需要可视化跟踪任务进度的开发者,CLI 则适合将 Devin 嵌入脚本和 CI 流程的团队。
模型能力的提升在代理式编码中会体现在几个方面:对代码库上下文的理解、多步任务的规划、以及出错后的自我修正。FrontierCode 2.0 的分数提升可以视为这些能力的综合指标,但具体到单个项目,实际表现仍取决于代码库规模、语言生态和任务类型。建议开发者在切换到 Carbon 后,先用既有任务集做一轮对比测试,再决定是否全面替换。
CLI 场景的特别价值
在 CLI 中使用 Devin 的团队通常更关注可自动化程度和成本可控性。Carbon 更低的每任务成本与 CLI 的批处理特性契合度较高,适合在代码审查、依赖升级、测试补全等重复性任务上扩大使用范围。
模型迭代节奏下的选择建议
Gemini 4 系列在短时间内从 Argon 迭代到 Carbon,基准得分大幅提升而成本下降,反映出模型供应商在编码场景上的竞争仍在加速。对 Devin 用户而言,平台侧完成模型接入意味着切换成本很低,真正的决策点在于验证新模型与自己项目的匹配度。
一个务实的做法是:保留 Argon 作为对照,在 Carbon 上重跑近期失败或效率偏低的任务,观察通过率和交互轮次的变化。如果提升符合预期,再调整默认模型配置。对于成本敏感型团队,每任务成本的下降本身就可能构成切换理由,即便基准提升在个别项目上不那么明显。
总体来看,Gemini 4 Carbon 在 Devin 中的上线是一次偏向实用主义的更新:不追求参数层面的叙事,而是用基准得分和成本两个开发者最关心的指标说话。
相关推荐
Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。
Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。