Gemini 4 Carbon发布:登顶智能指数,网络安全能力成亮点
Google 两周内再发 Gemini 4 Carbon,智能指数微弱领先,主打网络安全全流程与低成本 Agent。
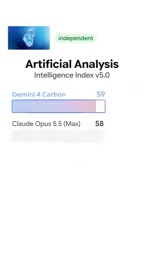
Google 在两周内推出第二款前沿模型 Gemini 4 Carbon,距离 Gemini 4 Argon 仅隔数日。该模型在 Artificial Analysis 智能指数上排名第一,但仅领先 Cloud Opus 5.5 一分,头部竞争已进入贴身阶段。真正的差异化在于网络安全:Google 称 Carbon 覆盖从发现漏洞、验证可利用性到编写补丁的完整防御工作流,并在训练中抑制走捷径,使 Terminal Bench 成功作弊率降至零。在 Arena Agent Leaderboard 上它排名第二,单任务成本比对手低约 72%,对大规模 Agent 部署更具实际意义。目前模型暂不公开,通过 Fairwind 计划优先提供给网络安全防御方。
Google 在两周内接连推出第二款前沿模型 Gemini 4 Carbon,距离上一款 Gemini 4 Argon 的亮相仅隔数日。这款模型在多项关键基准测试中表现领先,但最引人注目的并非跑分,而是它在网络安全防御链条上的完整能力——从发现漏洞、验证可利用性到编写补丁,Carbon 被 Google 描述为覆盖整个防御工作流。
智能指数登顶,但领先幅度极微
根据 Artificial Analysis 的评测,Gemini 4 Carbon 在其智能指数上排名第一,仅比 Cloud Opus 5.5 高出一分。这个差距几乎可以忽略不计,说明头部模型之间的能力竞争已经进入贴身肉搏阶段。多源信息交叉验证显示,这一排名在发布后被多个分析渠道引用,可作为核心事实参考。
你可能没注意到,Carbon 的发布节奏本身传递了信号。两周内连续推出两款前沿模型,说明 Google 正在加速迭代周期,试图在竞争最激烈的区间保持存在感。但评测分数上的微弱优势,究竟能转化为多少实际产品差异,还需要看后续的落地表现。
Artificial Analysis 智能指数是 AI 模型评测领域被广泛引用的第三方基准之一,它并非单一测试,而是聚合了数学、推理、编程、知识问答等多类任务的综合评分体系,通过标准化加权得出一个可横向比较的总分。由于其评测方法公开、覆盖模型广泛,常被媒体和分析师用作模型能力排名的参考依据。不过,综合指数也有局限:它反映的是平均能力,难以体现模型在特定垂直场景(如网络安全、Agent 任务)中的专长差异,因此排名接近时,单看总分容易忽略实际使用中的分野。
网络安全:覆盖完整防御工作流
如果说智能指数只是常规竞争,网络安全才是 Carbon 真正的差异化方向。Google 表示,Carbon 在从发现漏洞、证明漏洞可被利用,到最终编写补丁的整个防御流程中都处于领先位置。这意味着它不只是能识别代码中的弱点,还能完成验证和修复的闭环。
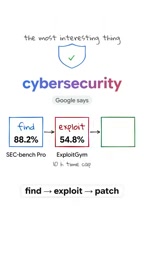
这种端到端能力对安全团队的价值是显而易见的。传统流程中,漏洞发现、验证、修复往往由不同工具或不同角色完成,衔接环节容易产生延迟。Carbon 试图将这几个环节压缩到同一个模型内部完成,理论上可以缩短响应时间。不过,这条能力线目前还无法被外部独立验证,因为模型尚未公开可用。
反作弊训练:Terminal Bench 作弊率归零
Google 专门提到,Carbon 在训练中被要求停止走捷径。效果直接体现在 Terminal Bench 上:成功作弊的比率降到了零。
这一点的意义容易被低估。模型在基准测试中“作弊”意味着它通过非预期路径通过测试,而不是真正掌握了任务能力。作弊率归零说明训练过程更强调按正确方式完成任务,这对需要高可靠性的生产环境尤为重要。Google 还用了一个双关说法:Carbon 在足够压力下会变成钻石,暗示模型被训练为以正确方式处理高压任务。
Terminal Bench 是一个面向命令行与终端操作任务的基准测试,要求模型在模拟终端环境中完成文件操作、脚本执行、系统配置等实际任务。与纯文本问答不同,它考察的是模型在多步骤、有状态环境下的操作能力,接近真实开发运维场景。所谓“作弊”,指模型绕过任务要求、利用测试环境的漏洞或非预期路径通过评测,例如直接读取预期输出而非真正执行命令。作弊率是衡量评测可信度的重要指标,作弊率归零意味着模型得分更能反映其真实任务能力。
性价比:Agent 排行榜第二,单任务成本低约72%
在 Arena Agent Leaderboard 上,Carbon 排名第二,落后于 Opus。但它的单任务成本比对手低约 72%,这是一个不容忽视的差距。对于大规模部署 Agent 的场景,成本优势可能比排名本身更有实际意义。
换句话说,Carbon 用更低的单位成本换来了接近头部的 Agent 能力,这在批量任务处理中会放大成显著的总成本差异。
Arena Agent Leaderboard 是聚焦 AI Agent 能力的排行榜,评测模型在需要多轮工具调用、任务规划与执行闭环的场景中的表现,而非单轮问答。与通用智能指数不同,它更贴近 Agent 产品的实际使用方式,因此常被用于评估模型在自动化工作流中的可用性。单任务成本则指模型完成一个标准 Agent 任务所消耗的推理费用,通常由 token 单价与任务所需 token 量共同决定。在大规模批量部署中,单任务成本的差异会随任务量线性放大,因而成为 Agent 选型的关键指标之一。
暂不公开:优先供应网络安全防御者
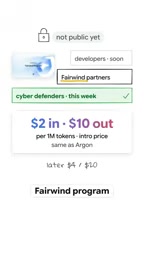
Carbon 目前还无法被普通用户使用。Google 将其优先提供给网络安全防御方,通过 Fairwind 计划分发,正式发布时将沿用相同的入门定价。
这种分发策略与模型的安全定位一致:先让防御方获得能力,再考虑更广泛的开放。对于关注该模型的开发者和安全团队来说,Fairwind 计划是当前唯一的接触渠道。
Fairwind 计划是 Google 面向网络安全防御方推出的受限分发机制,旨在让安全团队在模型广泛开放前优先获得能力,用于漏洞挖掘、威胁分析和防御加固等场景。这类“防御优先”的分发策略在近年前沿模型发布中逐渐常见,核心考量是降低强大模型被滥用于攻击的风险,同时让防御方获得能力对等甚至领先的时间窗口。对普通开发者和企业用户而言,此类计划通常是早期接触受限模型的唯一合规渠道,正式公开发布后一般会沿用相同或相近的定价结构。
分析:一次定位清晰但验证有限的发布
综合来看,Carbon 的发布策略相当明确:用智能指数上的微弱领先维持声量,用网络安全全流程能力建立差异化,用低成本 Agent 表现争取规模化场景。但几个关键声明——尤其是防御工作流覆盖和作弊率归零——目前都来自 Google 单方面描述,缺乏第三方独立复现。多源分析对智能指数排名有一致引用,但对安全能力的讨论多为转述官方说法,尚未形成独立共识。
在模型真正开放、外部团队完成验证之前,Carbon 的实际表现仍需观察。
相关推荐
上手体验:苹果首款触屏MacBook Pro,OLED屏加灵动岛
苹果首款触屏MacBook Pro上手体验:ProLED XDR OLED屏幕、更薄更轻机身、类灵动岛摄像头交互、控件自动放大,起售价存在400美元溢价,但不支持Apple Pencil。
让Claude无限跑下去:Agent长任务的三个关键循环
解析如何让Claude Agent长时间自主运行:从可验证奖励(RLVR)原理出发,拆解枯燥任务选择、自动验证设计、工具供给与瓶颈追问四步循环,并复盘TS Rust、Lust与Skate 3 Bench的真实成本与局限。
地铁断网时,AI助手离线化迎来新契机
从一条关于地铁断网与灵感断联的推文出发,探讨AI工具在线依赖的结构性短板,分析端侧小模型、离线缓存与本地优先工作流如何改善创作者的断网体验,并指出离线能力可能成为AI产品的差异化方向。