Gemini 4 Carbon发布:谷歌靠网络安全重返第一?

Gemini 4 Carbon主打网络安全与超长任务,多数测试领先但并非全胜。
谷歌发布新一代模型Gemini 4 Carbon,官方称其为自家最强模型,主打网络安全与超长任务两项能力。综合智能指数从上一代Argon的50提升到59,官方17项测试中拿下15项第一,但大型软件工程输给GPT、操作电脑输给Cloud Opus,说明优势集中在特定方向而非全面碾压。网络安全三项测试全部第一,Grace1提示注入攻击测试被攻破比例为0;25万至100万token超长文本找线索准确率达96.2%。第三方Artificial Analysis将其排在第一,目前仅向部分网络安全专家开放,并通过FairOne计划逐步扩大合作范围。
谷歌在10月28日发布了新一代模型Gemini 4 Carbon,官方称之为「自家最强模型」,并打出网络安全和超长任务两张招牌。综合来看,这是一次幅度不小的升级,但「重返第一」的说法需要拆开看——它在多数测试中领先,却并非全胜。
两大招牌:网络安全与超长任务
据B站UP主介绍,Carbon的核心卖点集中在两个方向。其一是网络安全:谷歌内部团队让它连续数天在大型代码库中自主找bug、修bug,展示的是长时程任务下的稳定性。其二是超长上下文:在25万到100万token的超长文本里寻找线索,准确率达到96.2%,写漏洞利用的能力提升近13个百分点。
这两项能力的组合指向同一个使用场景——让模型在庞大且复杂的代码与文档中长时间自主作业。网络安全只是这个能力的极端体现,因为漏洞挖掘既需要长上下文理解,又需要多步推理和验证。
从代际对比看,上一代Argon的综合智能指数为50,Carbon提升到59。这个幅度被UP主形容为「不是小修小补,是一次大升级」。
Token与上下文窗口:Token是模型处理文本的基本单位,可粗略理解为字或词片段;上下文窗口指模型单次能“记住”并处理的最大token量。25万至100万token约相当于数十万到上百万汉字,足以容纳整个中型代码库或长篇技术文档。上下文越长,模型越难保持对关键信息的稳定检索与推理,因此超长上下文下的准确率是衡量模型工程能力的重要指标,也是自主漏洞挖掘这类任务的前提。
17项测试15项第一,但输了两场
官方给出的17项测试中,Carbon拿下15项第一,对手包括GPT-6、Astra、Cloud Opus 5.5和Fable 5.1。但它并没有全赢——大型软件工程一项输给了GPT,操作电脑一项输给了Cloud Opus。
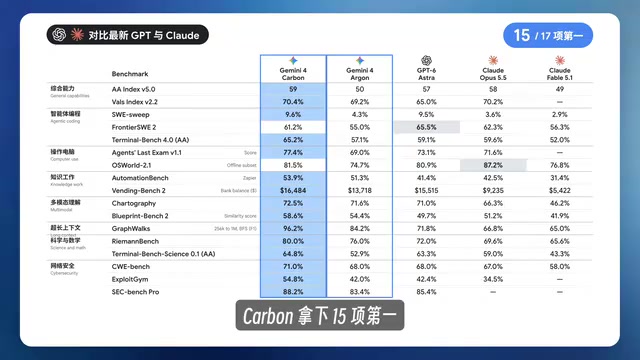
这个结果值得注意:它说明Carbon的优势高度集中在特定方向,而不是全面碾压。网络安全是本次的主场,找漏洞88.2%、补漏洞71%、写漏洞利用4.8%,三项全部第一。在Grace1提示注入攻击测试中,Carbon被攻破的比例为0,这一项对其安全定位是强背书。
提示注入攻击(Prompt Injection):指攻击者在模型读取的输入中嵌入恶意指令,诱导模型偏离原任务、泄露信息或执行非预期操作。对具备代码执行与自主作业能力的模型而言,这类攻击风险更高。Grace1测试中被攻破比例为0,意味着在该测试设定的攻击样本下模型未被成功操控,但这只是特定基准下的结果,并不等于对所有攻击方式免疫。
实际体验:图像与视频生成的意外表现
在能力测试之外,一些实际使用案例更能说明模型的综合素质。有博主让三家模型渲染同一滴水落进湖面的画面,比较真实感;也有人只给Carbon两张图,它就用3GS复刻出两个黑洞地平线的效果;还有人让它生成一只追蝴蝶的水墨猫。
这些案例更偏向生成质量与创意执行,和网络安全的主线并不直接相关,但反映出一个信号:Carbon在视觉任务上的表现没有因为专攻安全而被削弱。
第三方评测与价格
第三方机构Artificial Analysis将Carbon排在第一,这为谷歌的「最强」说法提供了一个外部参照。不过单一榜单的权重有限,更值得关注的是它在具体细分任务上的胜负分布。
价格方面,推广期每百万token输入2美元、输出10美元,之后恢复原价。当前Carbon只开放给部分网络安全专家,并通过FairOne计划逐步向更多可信合作伙伴开放。这种有限开放策略与其安全定位一致——先在小范围内验证,再扩大信任边界。
Artificial Analysis:是一家独立的大模型评测机构,通过综合多项基准测试与人工评估给出模型排名和智能指数,常被业界用作横向对比的参考。第三方榜单能降低厂商自评的偏向性,但排名高度依赖其测试集构成与权重设计,单一榜单不宜作为选型的唯一依据,结合细分任务胜负分布看更可靠。
token计价方式:大模型API通常按输入token和输出token分别计费,输入指用户提交的提示与上下文,输出指模型生成的内容。Carbon推广期输入每百万token 2美元、输出10美元,输出单价明显更高,因为生成过程计算成本更大。对超长上下文场景,输入token量可能极大,成本估算需把上下文长度纳入考量。
结论:领先是局部领先
Carbon在网络安全和超长文本任务上确实建立了明显优势,综合智能指数和第三方排名的提升也支撑了「大升级」的判断。但大型软件工程和电脑操作两项的失利说明,它更接近「在自己的主场领先」,而不是在所有维度上重返第一。对关注安全场景的团队来说,这可能是当前最值得评估的模型;对通用任务而言,选型还需要看具体需求。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。