Gemini 4(代号Argon)发布:百万Token自主输出引爆AI圈

谷歌悄然发布 Gemini 4(Argon),宣称百万 Token 输出与自主工程闭环能力,但数据来源单一,需独立验证。
谷歌未经预热直接发布了代号 Argon 的 Gemini 4,其最受关注的能力点包括:单次自主输出上限达 100 万 Token(区别于以往强调的输入上下文)、可在沙盒中自跑测试与自我纠错、已在谷歌数据中心用于真实内存优化与 80 万行微内核向 Rust 的迁移任务。评测数字方面,软件工程基准近 78%、无源码黑盒渗透成功率超 70%。后者是典型的双刃剑能力——防御价值与攻击风险并存。文章整体保持审慎态度,指出上述信息均来自单一自媒体对技术报告的转述,竞品对比表述带有流量色彩,核心数字需等待官方文档与独立复现后才宜做定论。
谷歌这次没有开发布会,没有预热海报,凌晨直接甩出了代号 Argon 的 Gemini 4。按照 B 站 UP 主「AI 学习的老张」研读完整套技术报告后的说法,谷歌掏出来的「完全是另一个物种」。抛开视频标题里那些夸张的营销话术,这款模型确实在几个关键指标上展示了不同以往的能力结构。本文梳理其中值得关注的技术要点,并对相关宣称保持审慎态度。
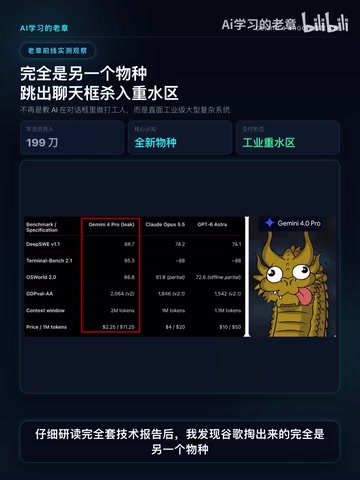
百万级单次自主输出:从「看得多」到「写得多」
过去几年业界反复强调的「百万 Token」,几乎都是指输入上下文窗口,也就是模型一次能「读进去」多少内容。而 Argon 据称把单次自主输出上限拉到了整整 100 万 Token,这是一个方向性的差异。
输入窗口大,解决的是「理解长文档、长代码库」的问题;输出能力强,解决的则是「一次性交付成套复杂产物」的问题。如果一个模型能在单次任务里连续生成百万级 Token 而不丢失一致性,意味着它可以直接输出整套工程代码、完整的测试套件,甚至是一个可运行的中型项目骨架,而不需要人类反复分段提示、拼接结果。
配合命中缓存后「一毛钱的白菜价」,这个成本结构如果属实,会显著改变长输出任务的经济性——过去让大模型连续产出大量内容的最大障碍之一就是 token 计费带来的高昂成本。
理解这一区别需要先明白 Token 的计量方式。Token 是大语言模型处理文本的基本单位,大致对应英文中的半个单词或中文的一到两个字,100 万 Token 约相当于 70 万英文单词或一部中等篇幅的长篇小说。主流模型的输入上下文窗口(如 GPT-4 Turbo 的 128K、Gemini 1.5 Pro 的 100 万)早已拓展到相当规模,但输出侧一直受制于计算成本和自回归生成的累积误差问题——模型每输出一个 Token 都要重新计算注意力,长输出极易导致内容漂移、前后矛盾。现有主流模型的单次输出上限通常在 4K 至 32K Token 之间,Argon 宣称的 100 万 Token 输出若属实,意味着在工程上做出了重大突破,而不仅仅是参数规模的扩大。
自我纠错的工程智能体
真正把 Argon 和聊天机器人区分开的,是它被描述为能在沙盒环境中自主闭环:自己跑测试、读编译日志、根据报错自我纠错,最终一次性交付工业级代码。
这套流程其实就是软件工程师的日常工作循环——写代码、编译、看报错、改代码、再编译。过去的大模型往往只负责「写」这一步,后续的验证和修正需要人工介入或外接工具链。如果模型能把整个循环内化为自身能力,它就从「代码补全工具」升级为「可以独立承接任务的工程智能体」。
当然,「一次性交付成套工业级代码」这类表述需要打个问号。工业级代码的标准不仅是「能跑」,还涉及架构合理性、可维护性、安全性和边界条件处理,这些很难靠单次评测分数完全衡量。
真实场景的落地案例
视频中最具说服力的部分,是几个被描述为「实打实」的落地案例,而非实验室跑分:
- 数据中心服役:谷歌据称让 Argon 在自家数据中心秘密运行了几个月,用于实际的内存优化工作。
- 微内核迁移:将 80 万行微内核代码平稳迁移到 Rust 底层,视频解码性能据称暴涨近三倍。大规模、跨语言的系统级代码迁移一直是软件工程里风险极高的工作,涉及内存安全、ABI 兼容、性能回归等诸多陷阱。
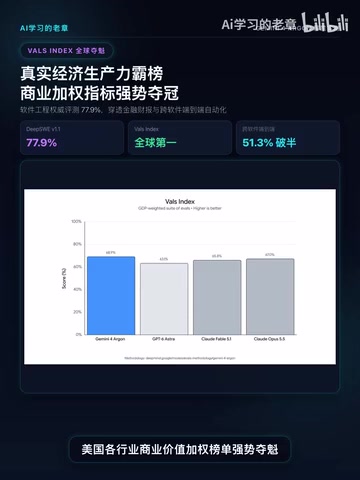
- 商业价值评测:在软件工程权威评测中拿下近 78% 的成绩,并在覆盖美国各行业的商业价值加权榜单上夺魁。

这些案例如果经得起第三方复现,确实比单纯的 benchmark 更有说服力,因为它们直接对应真实工程产出。但目前这些信息均来自单一视频来源对技术报告的转述,建议等待谷歌官方技术文档和独立评测的交叉验证。
微内核向 Rust 迁移这一案例值得进一步说明背景。Rust 是一门以内存安全著称的系统编程语言,它通过「所有权」机制在编译期消除悬空指针、数据竞争等一类内存错误,无需垃圾回收。然而,将 C 或 C++ 编写的大规模底层代码库迁移至 Rust,历来被视为软件工程中难度最高的工程任务之一:需要逐函数重写所有权语义、处理 unsafe 边界、保证 ABI(应用二进制接口)兼容,同时确保性能不退化。Google 自身的 Android 团队和 Linux 内核社区都在推进类似工作,但均以渐进式、数年为单位推进。80 万行代码的规模如果真由 AI 主导完成迁移,且视频解码性能提升近三倍,将代表代码智能体在系统工程领域的质变,而非量变。
网络攻防:70% 渗透率背后的双刃剑
被视频称为「最硬核」的一项,是 Argon 在无源码黑盒渗透测试中据称超过 70% 的渗透率,并帮助全球数百家医院揪出了潜伏多年的致命漏洞。
这是一个值得单独关注的能力维度。无源码渗透意味着模型要像真正的攻击者一样,在不了解系统内部实现的情况下探测和利用漏洞。能力越强,防御价值越大——提前发现医院、关键基础设施的隐患,确实能挽救生命和资产。
但同样的能力反过来就是攻击武器。一个渗透成功率超过 70% 的自主智能体,一旦被恶意使用,威胁级别很明显。这也是为什么前沿模型的攻防能力一直是 AI 安全讨论的焦点,模型越强,对部署管控、滥用防范的要求就越高。
「无源码黑盒渗透测试」是网络安全领域最贴近真实攻击场景的评估方式。测试者不掌握目标系统的源代码或内部架构文档,只能像外部攻击者一样通过网络探测、流量分析、模糊测试等手段发现和利用漏洞。相比之下,「白盒测试」(掌握全部代码)或「灰盒测试」(掌握部分信息)的难度要低得多。现有安全研究表明,人类顶尖渗透测试工程师在有限时间内对复杂系统的成功率也因目标差异悬殊,70% 这一数字缺乏标准化基准做参照,需要看清楚评测的目标系统类型与测试条件才能判断其真实含义。AI 自主执行渗透测试的能力也引发了监管层面的关切,美国 CISA 和欧盟 AI 法案均将「网络攻击能力」列为高风险 AI 系统的核心评估维度。
冷静看待:从「教 AI 打工」到「AI 自己打工」
视频用「大模型终于跳出了在聊天框里教 AI 做打工人的初级游戏」来概括这次发布的意义,这个判断方向上是成立的。如果一款模型能自主完成工程闭环、承接真实生产任务,它的定位就从「辅助工具」转向「生产力主体」。
不过需要提醒的是,本文信息来自单一自媒体来源对技术报告的解读,标题中「碾压 GPT-6、Claude Opus 5.5」等对比表述带有明显的流量色彩,相关竞品型号本身也缺乏公开佐证。百万 Token 输出、78% 评测分、70% 渗透率这些数字,在没有官方文档和独立复现之前,更合适的态度是「关注但存疑」。
真正的分水岭不在于发布会上的数字有多亮眼,而在于这些能力能否稳定、安全、可复现地落到真实场景中。Argon 如果能兑现其中哪怕一部分,都足以推动智能体从演示走向生产。
相关推荐

从工作流到评估驱动:AI时代解决任务的范式转变
AI解题范式正从设计确定性工作流转向「定义评估+爬山优化」。本文解析评估驱动如何重塑任务解决方式、数据供应商的新角色、人类从执行者到方向制定者的转变,以及Agent应用界面的演化趋势。

收据伪造检测模型接近随机?文档图像取证的实战困境与破局思路
一个收据伪造检测项目的 ROC-AUC 始终接近随机水平,本文剖析文档图像取证中的小样本困境,并给出从二分类转向异常检测、自监督预训练、数值一致性校验等可验证的破局方向。

特斯拉Powerwall+电动车:停电时的双重备用供电方案
特斯拉Powerwall家庭储能系统结合电动车双向充电,可在停电时提供多重备用供电。本文解析Powerwall续航能力、车辆作为备用电池以及超充补能的闭环方案与现实边界。