Gemini 4 Neon 登顶 Models Engineering Index 榜首
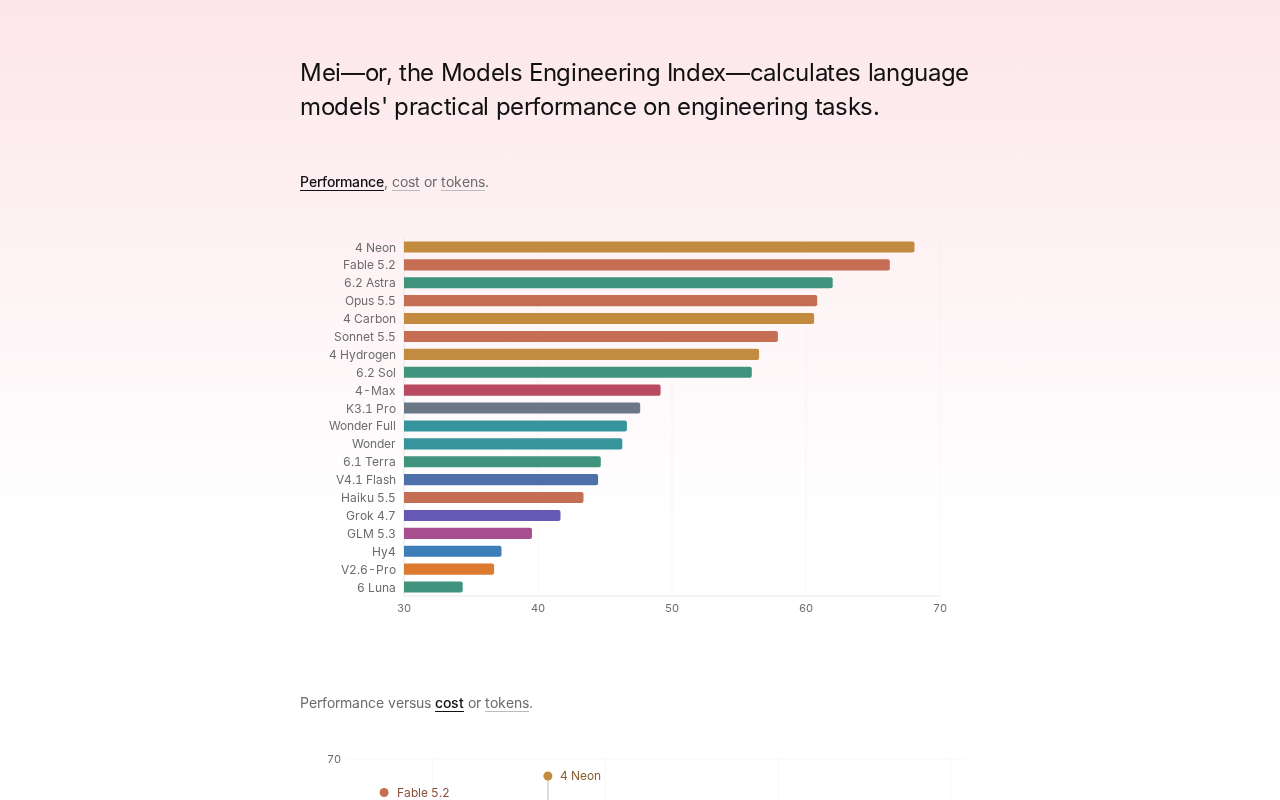
Gemini 4 Neon 登顶 Models Engineering Index,社区更关注评测透明度。
据 Hacker News 讨论帖,Gemini 4 Neon 在 Models Engineering Index 上超越此前领先的模型成为新的第一名,该帖获得 55 分和 24 条评论。文章指出,该榜单被视为模型工程能力的风向标,此次登顶意味着谷歌在模型工程化落地方面取得阶段性进展,但原帖未披露具体评测维度和分数细节,实际含金量仍待佐证。评论区围绕排名可信度、评测标准透明度及实际任务表现展开讨论,反映出行业对单一榜单代表真实工程能力的普遍焦虑。对开发者而言,这一排名提供了新的可选项,但技术选型仍需结合延迟、成本、稳定性等指标,并通过小规模验证和社区复现来判断。
榜单易主:Gemini 4 Neon 成为新晋第一
据 Hacker News 讨论帖,Gemini 4 Neon 在 Models Engineering Index 上超越此前领先的模型,成为新的第一名。该帖子获得 55 分和 24 条评论,在技术社区引发关注。
Models Engineering Index 是衡量模型工程能力的专业榜单,其排名变化常被视为技术风向标。此次 Gemini 4 Neon 登顶,意味着谷歌在模型工程化落地方面取得了阶段性进展。不过,原帖仅提供排名结论,未披露具体评测维度和分数细节,因此这一变动的实际含金量仍有待更多数据佐证。
Models Engineering Index 并非学术界广泛引用的基准(如 MMLU、HumanEval),而是聚焦“模型工程能力”的行业榜单,通常考察模型在真实工程任务中的表现,例如代码生成与修复、工具调用、多步骤任务编排、长上下文处理与指令遵循等。此类榜单的排名往往依赖主办方自建的评测集与评分权重,公开程度不一,因此排名结果对模型选型有参考意义,但不宜直接等同于综合能力排序。理解这一点,有助于判断 Gemini 4 Neon 登顶究竟是工程适配性的胜利,还是评测口径变化带来的波动。
社区反应:关注排名,更关注评测方法
从评论区的讨论热度看,开发者对榜单本身的关注,不亚于对模型能力的兴趣。Hacker News 上 24 条评论围绕排名可信度、评测标准是否透明、以及新模型在实际任务中的表现展开。
这类讨论反映出行业对模型评测的普遍焦虑:单一榜单的排名能否代表真实工程能力?不同评测集之间的可比性如何保证?在缺乏公开方法论的情况下,排名第一更多是信号而非定论。
在模型评测领域,常见的可信度问题包括:评测集是否公开、是否与训练数据存在污染(data contamination)、评分是否依赖单一 LLM 作为裁判(LLM-as-a-judge)而引入偏见、以及不同榜单之间的分数是否可比。Hacker News 等技术社区的讨论传统上对“黑箱排名”保持警惕,倾向于要求可复现的评测脚本与原始样本。这也是为何评论区在关注排名的同时,更强调方法论透明度——缺乏公开评测维度和分数细节时,排名只能作为弱信号,需要社区复现或第三方独立评测来交叉验证。
对开发者的意义:排名之外看落地
对一线开发者而言,Gemini 4 Neon 登顶的直接价值在于提供了一个新的可选项。模型工程索引的排名变化,通常会影响技术选型时的参考权重,但最终决策仍取决于具体场景下的延迟、成本、稳定性等工程指标。
建议开发者关注后续是否有更详细的评测报告放出,并结合自身业务负载进行小规模验证。在官方数据缺席时,社区复现和实际压测是更可靠的判断依据。
技术选型中常用的实践是建立内部小规模评测集(golden set),用自身业务的真实请求样本对比候选模型在准确率、首 token 延迟、吞吐、单位调用成本和失败率上的差异。榜单排名可作为初筛依据,但延迟与成本这类工程指标高度依赖部署方式(API 还是自托管)、区域和并发负载,无法从公开榜单直接推导。建议在正式迁移前做 A/B 压测和灰度发布,并保留回滚方案,以降低排名变动带来的选型风险。
相关推荐

Daybreak Red部署指南:监督式安全调查参考架构
Daybreak Red参考架构解析:介绍监督式安全调查的安全控制设计、部署配置流程与运行监控机制,为团队落地受控安全调查提供工程参考。

苹果自研AI智能体:能替你操作Mac的Agent要来了
苹果据报正在开发可操控Mac的AI智能体,对标Meta Muse、Claude、OpenAI Dots等产品。本文分析苹果在agent赛道的系统级优势、竞争格局与可能的落地路径。

Anthropic上市:七位创始人套现近20亿美元
Anthropic完成创纪录IPO,每股83美元定价下七位创始人合计套现近20亿美元,每人2.8亿美元,公司募资近1050亿美元。本文分析AI公司上市潮中的资本化路径与市场信号。