Gemini 4 Neon vs Claude Opus 5.5:基准测试与真实代码的反转
基准测试与生产代码评测结果迥异,工具链环境扭曲模型表现,选模型需按负载实测。
文章通过对比 Google Gemini 4 Neon 与 Anthropic Opus 在基准测试和生产代码中的表现,揭示了模型评测中工具链环境的扭曲效应。Google 宣称 Neon 在 19 项基准中赢 16 项,但代码审查公司的生产代码长会话测试中 Opus 以约 87% 对 80% 胜出,长会话差距达 12 个百分点。同一 Neon 模型在 Google 的 AntiGravity 工具中得分 39%,中性环境仅约 13%,说明框架绑定严重影响了评测结果。Neon 在 3D 场景和前端构建上不输 Opus 且成本低 25% 至三分之二,但在硬核生产代码和长文本任务上 Opus 仍占优。文章建议用户根据自身负载实测,并指出 Neon 默认高配档位性价比最高。
当基准测试遇上真实代码,胜负翻盘
Google 宣称 Gemini 4 Neon 在 19 项基准测试中赢了 16 项。但一家代码审查公司把两个模型放到自己的生产代码上跑,结果 Opus 以 7 个百分点的优势胜出。这不是简单的跑分误差,而是揭示了模型评测中一个被长期忽视的维度:工具链环境对实际表现的扭曲。
据 YouTube 频道和 X 上多位开发者的交叉验证,这个结论正在被越来越多的一线使用者认可。但在 3D 场景、前端原型等任务上,Neon 的表现又让人动摇。到底该信谁?答案取决于你拿它做什么。
第一天的测试:3D 场景与直觉判断
最早流传的对比测试是一个 3D 场景,单提示词、单 HTML 文件。在这个任务上,Neon 明显领先 Opus,甚至接近 Google 更大的模型 Carbon。但其他并排对比的结果有来有回,没有一边倒。
一位连续三个月高频使用 Opus 的开发者说,用了 Neon 四小时后,他意识到自己之前一直在“否认”。另有人把 Opus、Neon 和 4D 的三份输出混在一起、去掉标签,让人猜哪份来自哪个模型——这个盲测比看起来难得多。
但这并不意味着 Opus 已经出局。同一位测试者给两个模型相同的提示词、最高推理等级:Neon 花了 20 分钟、约 3.50 美元;Opus 花了 18 分钟、约 7.20 美元。Neon 塞进了更多细节,但他仍然认为 Opus 的整体效果更好。
长文本与风格:Opus 的隐性优势
在幻灯片生成测试中,Neon 的前几页看起来不错,但一旦文本变重,Opus 就拉开了差距——它保留了背景特效,而 Neon 变得平淡。更典型的是代码量差异:同样规格的 Turbulon 手表页面,Neon 写了近 4000 行,Opus 只用了约 1700 行,不到一半,但测试者更喜欢 Opus 的风格。
“风格”这个词在讨论 Opus 时反复出现。这不是可量化的跑分,却是决定产出可用性的关键因素。
生产代码测试:Opus 赢在长会话
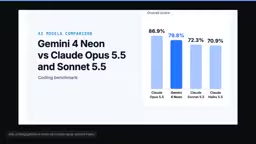
最值得信任的测试来自一家代码审查公司,它把两个模型放到自己的生产代码上,进行长时间调试会话,由独立评审打分。结果 Opus 约 87%,Neon 约 80%。在长会话上差距扩大到 12 个百分点。更关键的是稳定性:在一个任务中,Neon 四次运行里有三次对服务行为做出了同样的错误断言——这正是 bug 被带上线的典型路径。
公平地说,Neon 每次会话成本低约 60%,完成速度快约 40%。但速度与成本的诱惑,在长链条调试中可能被稳定性问题抵消。
长会话调试(long-horizon debugging)是评估编码模型的一项关键但常被简化的能力。它要求模型在数十轮交互中保持对代码库状态、已尝试方案和错误历史的连贯记忆,并逐步缩小问题范围。与单轮代码生成不同,长会话中模型需要处理上下文窗口的压缩、工具调用的累积错误以及任务目标的动态调整。Opus 在长会话上领先 12 个百分点,说明它在维持长期一致性方面更强——这通常与模型的上下文管理策略、对自身输出错误的检测能力以及代理框架的状态保持机制有关。Neon 在四次运行中有三次对服务行为做出相同错误断言,暴露的正是长会话中的“固执性”问题:模型一旦形成错误假设,就难以通过后续交互自我纠正。这种失败模式在真实生产环境中尤其危险,因为开发者可能信任模型的断言而忽略验证,最终导致 bug 上线。因此,长会话稳定性比单次生成质量更能预测模型在实际调试工作中的可用性。
工具链陷阱:AntiGravity 拖了后腿
Neon 怎么能在 19 项基准中赢 16 项,却在这里输?很大一部分原因在它运行的工具里。在一个编码基准上,Neon 在 Google 自己的编码工具 AntiGravity 中得分 39%,而在中性环境中只有约 13%。同一个模型,环境不同,分数天差地别。
Google 的图表还漏掉了 Fable 5.2 和 GPT 6.2 Astra,这两个模型得分都更高。而 AntiGravity 正是抱怨最集中的地方:有人说它不可用,因为 agent 跑不了几分钟就卡在错误上;也有人说它比之前好,但离前沿工具还差得远。
如果你用的是 Gemini Pro 或 Ultra 套餐,你被绑定在 AntiGravity 和 Gemini 应用上。Opus 没有这个问题——即使在 Google 自己的基准里,Opus 也是在 Cloud Code 里跑的,而很多开发者已经在用这个工具。把 Neon 迁移到其他工具也不顺畅:有人在 Cursor 里用 Neon,它反复重复同一步骤,而在 AntiGravity 里却正常。
所以选这两个模型,你实际上是在同时选模型和工具。
在讨论模型能力时,一个常被忽略的事实是:大语言模型本身不直接执行代码或操作文件,它必须通过一个“代理框架”(agent harness)来调用工具、读取上下文、执行命令。这个框架负责把用户任务拆解成模型可理解的步骤,管理多轮对话的状态,并处理错误重试。不同的代理框架在工具调用格式、上下文窗口管理、错误恢复策略上差异巨大,同一个模型在不同框架下的表现可能天差地别。AntiGravity 是 Google 为 Gemini 系列模型提供的编码代理环境,它与 Gemini 模型深度集成,但工具调用的稳定性和错误处理机制一直受到开发者诟病。当模型被绑定在特定框架中时,评测分数反映的就不再是纯粹的模型能力,而是“模型+框架”的联合表现。这也解释了为什么同一模型在 AntiGravity 中得分 39%,而在中性环境(如直接 API 调用或第三方代理)中仅约 13%——前者可能针对框架做了特殊优化或提示词适配,后者则暴露了模型在通用场景下的真实水平。因此,比较模型时必须明确评测环境,否则结论可能完全失真。
价格与切换意愿
价格是 Neon 的明显优势。按 token 算,它比 Opus 便宜 25%。按任务算,差距更大:在 Artificial Analysis Index 上,Neon 高配版比 Opus 便宜 25%,得分却和 Opus 最高配差不多,成本约为三分之一,时间也少得多。
确实有人在切换。一位开发者说 Neon 终于取代 Opus 成了日常主力;另一位说它好到可以停用 Opus。一位创始人在看到早期数据后,第一天就启动了 Neon 对 Opus 的生产环境盲测——结果还没出来。
结论:按负载选模型
综合多位测试者的共识:3D 场景和前端构建,Neon 不输 Opus,甚至更好,而且便宜得多;硬核生产代码和长文本,人们仍然倾向 Opus;很多人表示,如果 Neon 能在 AntiGravity 之外跑得好,他们会更快迁移。
还有一个实用细节:把 Neon 留在默认的高配档位。超高配只多一分,成本却高约 70%,在一个测试中得分反而更低。
Opus 5.5 发布已有两个月,Anthropic 不会坐以待毙。真正的建议是:拿你自己的负载去测,看它是否对你有用。跑分是别人的,工作流是你自己的。
相关推荐
Gemini 4 Neon实测:成本减半性能逼近旗舰
Gemini 4 Neon 实测汇总:智能指数 61 分超越自家旗舰 Carbon,Coding Agents 性能与 Opus 5.5 打平但成本减半。含纯代码 3D 演示、官方定价与失败案例。
Gemini 4 Neon 实测对比 Claude Opus 5.5:谁更值得切换
Gemini 4 Neon 实测对比 Claude Opus 5.5:官方基准知识工作与长上下文领先,但编程仍略逊;独立评测智能指数更高却更慢更啰嗦,两轮实测各有胜负,告诉你什么场景该切换。
Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 在对比测试中用一次性提示词完胜 Claude Opus 5.5,但实测冷启动暴露水物理崩坏与 bash 可靠性短板。本文拆解其 API 定价陷阱、8 智能体 Swarm 的真实威力,以及什么场景该用 Neon、什么场景该换 GPT 6.2 Sol。