Gemini 4 Pro现身Arena灰测:3D与物理能力全面升级
谷歌疑似以匿名变体形式在Arena平台测试Gemini 4 Pro,社区案例显示其3D生成与交互能力大幅跃升。
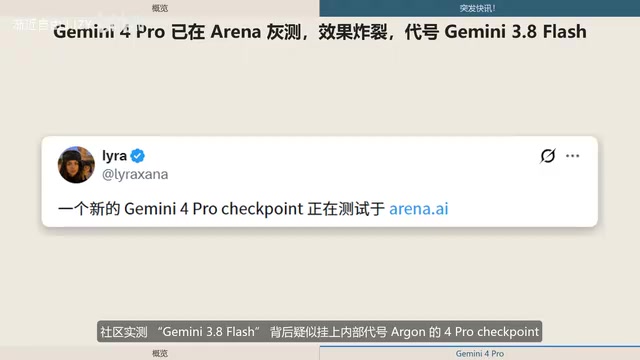
据社区爆料,谷歌正以内部代号Argon的早期检查点,将Gemini 4 Pro隐藏在Arena平台的"Gemini 3.8 Flash"匿名变体中进行幽灵测试。多项异常指标——包括画质与3D效果突然跃升、Checkpoint ID变化、生成耗时增加、输出上限达256K token——指向该变体背后实为更强大的模型。社区收集的疑似输出案例覆盖交互式3D建模、可玩赛车游戏、科学可视化等场景,展示了模型在空间理解与物理模拟方面的整体进步。此外,有传闻称新模型将支持高达2M token的超长上下文,并对标Astra与Fable 5.1等前沿方案。目前所有信息均为社区推测,谷歌官方尚未确认,需谨慎看待精选案例的代表性。
谷歌下一代旗舰模型正在悄然接受实战检验。据B站AI资讯博主爆料,Gemini 4.0 Pro 已在大模型竞技场 Arena 中开启"幽灵测试"(Ghost Test),社区实测显示其在画质渲染、3D 空间理解和物理模拟等方面出现了远超日常水平的表现。以下结合公开测试线索,梳理这次灰度测试透露出的关键信号。
幽灵测试与内部代号 Argon
所谓幽灵测试,是大模型上线正式版本前的一种匿名灰度验证方式——模型以匿名变体身份出现在 Arena 中接受盲测,避免用户先入为主的品牌偏好,从而获得更客观的能力评估。
此次社区注意到 Arena 中突然上线了一个新变体 Gemini 3.8 Flash,但实测表现与其命名并不匹配。多位测试者推测,这个 Flash 变体背后疑似挂载了内部代号为 Argon 的 4 Pro Checkpoint,也就是说,用户在与 Flash 交互时,实际调用的可能是尚未发布的 Gemini 4 Pro 早期检查点。
支撑这一判断的证据包括几个方面:输出画质和 3D 生成效果突然远超日常 Flash 水平;Flash 的 Checkpoint ID 发生变化;模型开始展现出对三维空间与物理规律的理解;单次生成耗时明显变长;以及输出上限被提升至 256K token。这些指标的集体跃升,很难用同代小模型的常规优化来解释。
大模型竞技场 Arena(即 Chatbot Arena,由加州大学伯克利分校 LMSYS 团队创建)是目前最具影响力的模型能力众包评测平台。用户在不知道对话方身份的情况下与两个匿名模型交互,随后投票选出更好的回答,平台据此生成 Elo 积分排名。正因为测试者不知道自己在用哪家模型,品牌光环效应被大幅压缩,评测结果被认为比单纯的基准测试更接近真实用户偏好。各大实验室也因此热衷于在正式发布前,将新模型以匿名变体的形式投入 Arena "预热",在收集真实用户反馈的同时悄悄积累 Elo 分数——这正是"幽灵测试"频繁出现在 Arena 的制度根源。
对标 Astra 与 Fable 5.1
据爆料,Gemini 4.0 Pro 此次瞄准的竞争对手是 Astra 与 Fable 5.1(原文提及的"Extra""Faber"疑为语音转写误差)。这一定位意味着谷歌希望在下一代模型的多模态交互与内容生成能力上,与业界最前沿的方案正面竞争。
更值得关注的是上下文窗口。有传闻称新模型可能支持高达 2M token 的上下文长度。如果属实,这将大幅拓展模型处理长文档、大型代码库和复杂多轮任务的能力边界,进一步巩固谷歌在超长上下文这一细分方向上的传统优势。
需要提醒的是,上述参数目前均来自社区推测和第三方观察,谷歌官方尚未确认 Gemini 4 Pro 的存在或任何技术规格。在正式发布前,这些数字应被视为线索而非结论。
超长上下文窗口是谷歌近几代 Gemini 模型的标志性技术方向。Gemini 1.5 Pro 曾率先支持 100 万 token 上下文,后续版本进一步拓展至 200 万 token,而本次传闻的 2M token 延续了这一路线。上下文长度的实际意义远不止数字本身:100 万 token 大约相当于 75 万个英文单词,可容纳一整个中型代码库或数十份长篇研究报告;2M token 则意味着模型可以在单次对话中"阅读"一部百科全书级别的知识库而无需分段。这项能力对需要跨越大量上下文进行推理的任务(如全库代码重构、长周期多轮科研对话)具有实质性价值,也是谷歌区别于 OpenAI 等竞争对手的核心差异化方向之一。
疑似输出案例:3D 与交互能力抢眼
社区收集了大量疑似出自 Gemini 4 Pro 的输出样例,最直观的进步集中在 3D 建模、可视化和交互式内容生成上。
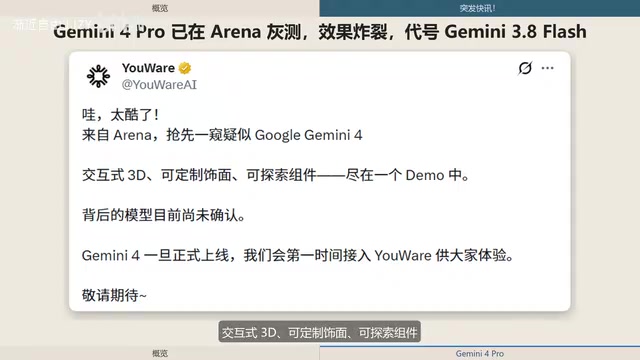
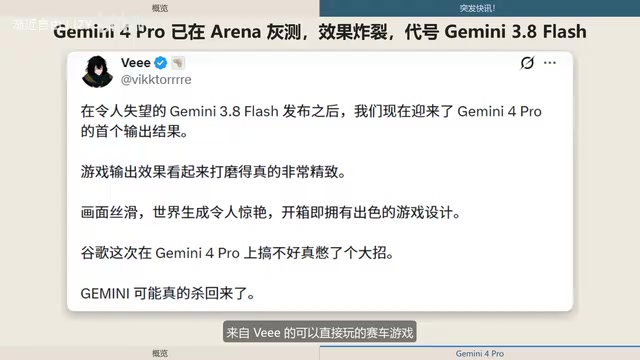
从公开的测试列表来看,涉及的场景相当丰富:Lumina 分享的 PS5 主机 SVG 实例、UVL 的公路自行车可视化界面、可定制且可探索的交互式 3D 组件、空客 H145 直升机的 3D 模型、可以直接上手玩的赛车游戏、控制飞机飞行的小游戏,以及沃尔克像素风宝塔建模等。这些案例的共同点是——不再是静态图像或纯文本,而是可交互、有空间结构、遵循物理逻辑的复合产物。
其中多个"提湖骑自行车"测试(分别来自 7-Eleven 1121 和 Harshice)被反复引用,这类场景需要模型同时理解人物姿态、自行车结构与运动物理,是检验空间与物理理解能力的典型题目。
此外,Hicam 提供的三维细胞结构对比案例,则展示了模型在科学可视化方向的潜力——将抽象的生物结构转化为准确、可对比的三维呈现,对模型的知识准确性和空间建模能力都是双重考验。
文中提到的多个案例涉及 SVG 和交互式 3D 内容生成——这类任务对大模型而言属于较高难度的"代码即视觉"挑战。模型需要将用户的自然语言描述直接翻译为结构化的矢量图形代码(SVG)或 WebGL/Three.js 等 3D 渲染代码,再由浏览器实时执行并呈现。这个过程要求模型同时具备空间几何推理、物体结构理解和代码精准生成三方面能力,任何一环出错都会导致最终画面崩坏。过去主流模型在此类任务上的通病是空间关系错乱、物理比例失真或代码逻辑缺陷;而本次社区案例中出现可实际操作的赛车游戏和可探索的交互式 3D 组件,暗示模型在将"空间概念"转化为"可运行代码"的链路上取得了显著进步。
如何看待这波"性能炸裂"
从这些线索综合判断,Gemini 4 Pro(若确实存在)的核心突破很可能不在于传统的文本对话能力,而是在空间理解、物理模拟和交互式内容生成这条路线上的整体跃进。256K 输出上限与传闻中的 2M 上下文,也预示着模型正朝着处理更复杂、更完整任务的方向演进。
不过,作为读者仍应保持谨慎。幽灵测试阶段的表现存在样本偏差,社区精选的"炸裂"案例往往是优中选优的结果,未必代表模型的平均水平。真正的能力评估,还需等待官方发布后的系统性基准测试。
无论如何,这次灰度测试透露出的方向值得关注:大模型的竞争焦点正从"能说会写"向"理解世界、构建可交互内容"迁移。谷歌在这条路径上的布局,或将成为下一轮模型竞赛的重要变量。
相关推荐
API和API Key到底是什么?用DeepSeek文档4分钟看懂
API和API Key到底是什么?本文基于DeepSeek官方文档和终端实操,用"门与钥匙"的比喻带你4分钟看懂API调用原理,零基础也能学会,理解所有AI工具的底层逻辑。
警惕"一键部署GPT-6"骗局:第三方API套壳陷阱解析
网传"一键部署GPT-6免费用"教程真伪核查:所谓GPT-6 X-TRAW模型并不存在,第三方令牌与一键安装器存在套壳、数据泄露等安全风险,本文教你辨别AI工具部署骗局。
AI Agent入门指南:智能体的原理、组成与应用全解析
AI Agent智能体零基础入门解析:详解Agent与聊天机器人的区别、大脑记忆工具三大核心组件、Agent如何弥补大模型的记忆与联网缺陷,以及通用/专用/搭建平台三类智能体的应用场景。