Gemini Live API重磅更新:原生音频首次支持前沿级推理

Gemini Live API新增主动式音频、上下文注入、异步函数调用与高阶推理四大能力,让语音AI更接近真人对话逻辑。
Google为Gemini Live API带来了四项针对语音交互核心短板的重要更新。主动式音频让模型懂得在特定条件下才开口,避免无谓打断;上下文注入允许开发者在对话进行中静默传递背景信息,无需触发额外对话轮次;异步函数调用将耗时工具执行与实时对话解耦,后台任务运行期间对话不卡顿;最突破性的是首次将高阶推理引入原生音频模型,复杂任务可在后台独立执行,模型同时保持对用户输入的即时响应。这些功能均已在Gemini Live API中开放,为开发者构建更接近真人对话节奏的语音代理提供了坚实基础。
Google的Gemini Live API迎来了一波重磅更新,多项此前呼声极高的功能终于落地。这次演示中,Google团队别出心裁地让Gemini Live自己来介绍这些新特性,通过一场人机对话直观展示了每个功能的实际表现。以下结合官方演示内容,逐一拆解这次更新的核心亮点。
主动式音频:让AI学会“看情况说话”
最直观的一个改变是主动式音频(Proactive Audio)。在传统的语音交互中,模型往往对每一句话都要作出回应,这在多人对话或需要背景铺垫的场景中显得笨拙。而现在,开发者可以通过提示让智能体只在“相关时刻”才开口。
演示中,主持人明确告诉Gemini:只有在被称呼为“Gemini”时才回应。于是在做完开场白后,模型安静等待,直到被点名才接话。这种能力让语音代理更接近真实的对话节奏——它懂得何时该说、何时该沉默。
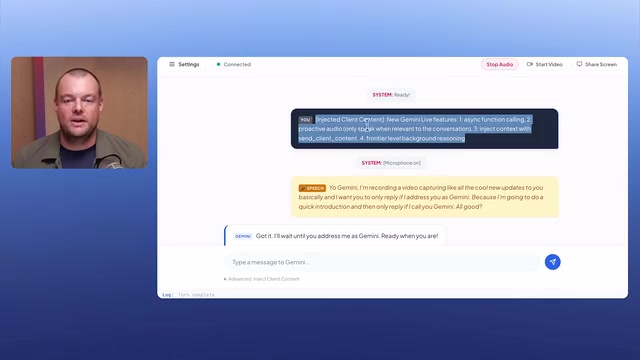
对于构建语音助手、会议记录或多轮对话应用的开发者来说,这一特性能显著减少不必要的打断,让交互体验更自然。
上下文注入:不打断对话也能“递情报”
另一个实用功能是通过 send client content 注入上下文而不强制触发一轮对话。简单说,开发者可以在对话进行中悄悄向模型“喂”信息,而不需要模型立即用语音回应。
这在需要“背景通道”传递数据的场景中极为有用——比如实时更新的库存状态、用户身份信息或系统状态,都可以静默注入到对话上下文里,模型会在合适的时候利用这些信息,但不必每次都打断当前的交流节奏。
异步函数调用:长任务在后台跑,对话不卡壳
**异步函数调用(Async Function Calling)**解决了一个长期痛点:当工具调用需要较长时间才能返回结果时,整个对话不必陷入停滞。
演示中,主持人请Gemini查询订单号为1234XYZ的物流状态。模型一边在后台执行查询,一边保持与用户的实时沟通,最终返回“订单已发货,预计到达时间”的结果。这意味着耗时较长的工具(如数据库查询、外部API调用)可以在后台运行,而智能体依然能流畅地继续交谈。
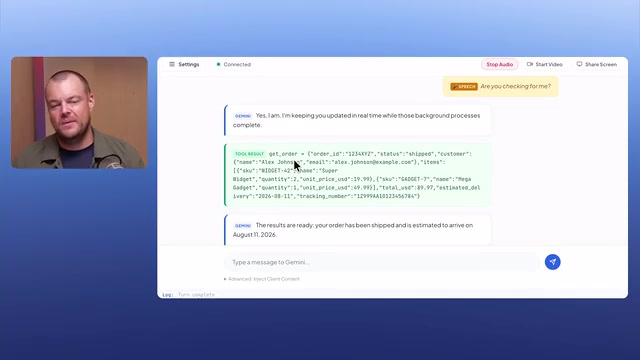
对于电商客服、订单查询、数据检索类应用,这一能力让语音代理既能处理复杂后台逻辑,又不牺牲交互流畅度。
传统的同步函数调用模式下,模型在发出工具调用请求后必须等待结果返回才能继续生成响应,这在网络延迟或复杂计算场景中会造成明显的"卡顿感",用户体验大打折扣。异步函数调用的核心机制是将工具执行与对话推理解耦:模型发起调用后立即释放推理资源,继续处理用户输入,待工具结果就绪时再将其合并进上下文。这种设计与现代后端开发中的 async/await 模式高度相似,本质上是把阻塞式I/O变成非阻塞式I/O。对于实时语音场景而言,哪怕后台查询耗时数秒,用户感知到的对话延迟依然接近零,从而在保证任务完整性的同时维持了语音交互的即时感。
前沿级推理首次登陆原生音频
本次更新最具突破性的,是首次将高阶推理(Higher Reasoning)和后台推理引入Gemini Live,把前沿级别的推理能力带到了原生音频体验中。
演示用了一个经典的测试任务——让模型绘制一只骑自行车的鹈鹕的SVG图形。标准原生音频模型给出的结果并不理想,鹈鹕画得较为粗糙。随后主持人切换到max高阶推理模型,再次尝试同一任务,效果明显提升:生成的SVG包含了头盔、飘动的围巾以及细节丰富的自行车结构。
更关键的是,这个复杂的绘图任务被放在后台执行,耗时较长,但模型在此期间依然保持响应——主持人可以继续和它闲聊,它也能正常回答其他问题。这正是“后台推理”与“实时交互”协同工作的价值:把重任务丢到后台,同时维持对话的即时性。
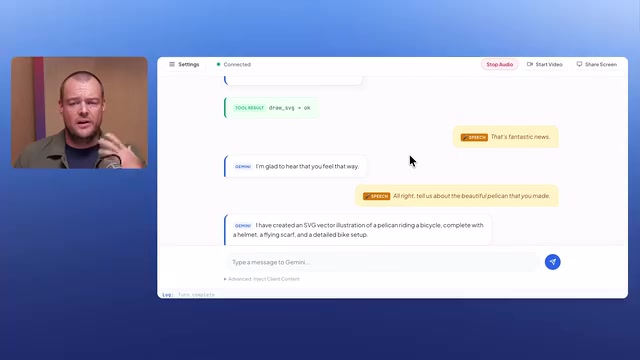
将复杂推理与实时语音交互结合,是这次更新真正称得上“groundbreaking”的地方。此前原生音频模型多以流畅度见长,而推理深度有限;如今二者兼得,为语音应用打开了新的想象空间。
原生音频(Native Audio)模型与传统的文本转语音(TTS)管道有本质区别。TTS管道的工作流是:文本模型生成文字回复,再由独立的语音合成模块将文字转化为音频,两个阶段串联完成。而原生音频模型直接以音频Token为输出单元进行端到端生成,省去了中间的文本桥接层,带来更低的延迟和更自然的语调、停顿与情感表达。然而,这种架构的代价是推理深度受限——模型的计算资源被音频生成占据,难以同时执行链式推理(Chain-of-Thought)。此次将"后台推理"引入原生音频,相当于为模型开辟了一条独立的"思考通道":复杂任务在后台以文本推理模式完成,最终结果再以原生音频形式输出,从而绕过了原生音频模型在推理深度上的固有瓶颈。
这些更新意味着什么
综合来看,这四项功能——主动式音频、上下文注入、异步函数调用、高阶推理——分别针对语音交互的不同短板:说话时机、信息传递、长任务处理和推理深度。它们大多是自Gemini Flash Live发布以来社区反复要求的特性。
对开发者而言,这意味着可以构建出更接近真人对话逻辑的语音代理:懂得何时开口、能在后台默默处理复杂任务、并具备解决复杂问题的推理能力。这些能力现已在Gemini Live API中开放,感兴趣的开发者可以直接上手尝试。
(本文基于Google官方演示视频整理,功能表现以实际API文档为准。)
相关推荐
Qwen Image 2.1 实测:7B 模型的图像生成能力如何?
Reddit 用户抢先体验 Qwen Image 2.1,实测生成 200+ 人物图像。本文解析这款 7B 参数图像生成模型的画质表现、噪点问题以及图像编辑与参考图能力。
Meta Muse评测:强大却令人不安的AI助手
Meta的AI助手Muse功能强大却令人不安。其Mac应用可访问信息、日历和备忘录引发隐私担忧,而它无法描述自身的局限更揭示了当前AI的深层问题。本文解析Muse评测背后的信任与边界议题。
Deodand:中世纪英格兰为致死之物定价的古老法律
Deodand 是英格兰普通法中一项为致死之物定价并没收的古老制度。本文解析其法律逻辑、从宗教赎罪到财政工具的演变,及其对当今自动驾驶与 AI 责任归属讨论的启示。