Gemini智能体模式实战:让AI高效搞定API数据层代码

作为Android开发者,我们真正想投入精力的是产品创新,而不是那些重复、枯燥的样板代码工作。而这恰恰是AI智能体(Agent)最擅长发挥价值的地方。近期,一位Android开发者分享了他在Android Studio中使用**Gemini智能体模式(Agent Mode)**处理API文档与数据层编写的真实案例,结果令人印象深刻。
AI智能体(Agent)技术背景
AI智能体(Agent)是人工智能领域的一个重要概念,它不仅仅是传统的代码补全工具,而是具备自主规划、多步骤执行和上下文理解能力的智能系统。与GitHub Copilot等基于代码片段预测的工具不同,Agent模式能够理解完整的任务目标,自主拆解步骤,调用多种工具(如文件读取、API调用、代码分析),并在执行过程中进行自我纠错。这种能力使得AI可以从"写一行代码"进化到"完成一个模块",标志着AI辅助编程从被动响应到主动协作的转变。Gemini的智能体模式正是这一技术趋势的代表,它将Google的大语言模型能力与IDE深度整合,实现了从需求理解到代码生成的端到端自动化。
从技术架构角度来看,传统AI编程工具如GitHub Copilot最初版本主要基于代码补全(Code Completion)范式,其核心技术是通过Transformer模型预测开发者下一步可能输入的代码片段,本质上是一种高级自动补全。而Agent模式代表了一种根本性的架构转变:它引入了Planning(规划)、Tool Use(工具调用)、Memory(记忆管理)和Reflection(自我反思)四大核心能力。Agent能够将一个高层次目标(如"根据这份API文档编写数据源")自动分解为多个子任务,依次执行并在每一步检查结果是否符合预期。如果某一步出错,Agent可以自主回溯和修正,而不需要开发者重新输入指令。这种自主性和鲁棒性使得Agent能够处理传统代码补全工具完全无法胜任的复杂工程任务。
Android Studio与Gemini的深度集成
Android Studio作为Google官方推荐的Android开发IDE,基于JetBrains的IntelliJ IDEA平台构建。2024年起,Google开始将Gemini大语言模型深度集成到Android Studio中,从最初的代码补全(Code Completion)逐步升级到智能体模式(Agent Mode)。这种集成不同于第三方插件的松散耦合,而是在IDE层面实现了对项目结构、依赖关系、编译配置的全面感知,使得AI能够理解整个项目的上下文环境,而不仅仅是当前编辑的文件。这意味着当开发者向Gemini发出指令时,AI已经"看到"了项目中所有的接口定义、数据模型和架构约定,能够生成与项目整体风格一致的代码。
痛点:繁琐的数据层编写
在实际的商业项目中,开发者经常面临这样的场景:客户拥有一套复杂但文档完善的自定义API,用于对接安全后端。开发者需要根据这些文档,编写准确、高效的数据层(Data Layer)代码。
这类工作虽然技术含量不算高,却极其耗费时间,且容易出错。你需要逐字对照API文档,处理各种字段映射、请求参数、返回结构,同时还要遵循项目既有的架构规范。稍有疏忽,就可能引入难以排查的bug。
在企业级Android开发中,数据层代码通常占据整个项目代码量的30%-40%,但其中大部分是高度模式化的样板代码:定义API接口、编写数据传输对象(DTO)、实现字段映射、处理错误响应等。这些工作虽然模式固定,但由于每个API的字段名称、数据类型、嵌套结构各不相同,无法简单地用代码模板一键生成,开发者不得不逐一手写。
其中,DTO与领域模型(Domain Model)的映射是一个看似简单实则容易引入缺陷的环节。DTO直接对应API返回的JSON结构,其字段命名通常遵循后端的命名习惯(如snake_case),而领域模型则使用Android/Kotlin的命名约定(如camelCase)。两者之间的映射不仅涉及命名转换,还包括类型转换(如将字符串类型的日期转为LocalDateTime)、空值处理(API可能返回null但领域模型要求非空默认值)、以及嵌套结构的展平或聚合。在大型项目中,这些映射代码可能占据数据层代码量的相当比例,且每一处映射都可能成为潜在的bug来源。
这种"看似简单实则繁琐"的特点,使其成为AI辅助编程的理想应用场景——任务结构明确、规则清晰、容错空间大,AI可以在减轻开发者负担的同时保持较高的准确率。
正如这位开发者所言:"作为Android开发者,我想把时间花在创新上,而不是这些苦力活。"于是,他选择让Gemini的智能体模式来承担这部分"重活"。
实践:用Gemini Agent编写数据源
这次实践的核心任务,是根据客户提供的API文档,使用Retrofit编写完整的数据源(Data Source),并且必须契合项目中已有的接口定义与架构设计。
Retrofit框架技术解析
Retrofit是Android开发中最流行的HTTP客户端库之一,由Square公司开发并开源。它的核心优势在于将HTTP API转换为Java/Kotlin接口,通过注解的方式声明请求方法、URL路径、请求参数等信息,极大简化了网络请求代码的编写。Retrofit基于OkHttp实现底层网络通信,支持多种数据格式转换器(如Gson、Moshi),并且天然支持协程和RxJava等异步编程模式。在实际项目中,开发者通常会为每个API端点定义一个接口方法,Retrofit会在运行时动态生成实现类。这种声明式的API定义方式既提高了代码可读性,也便于进行单元测试和接口文档管理,因此成为Android数据层开发的事实标准。
Retrofit的成功不仅在于其自身的设计优雅,还在于它构建了一个丰富的生态系统。Converter(转换器)负责将HTTP响应体反序列化为Kotlin/Java对象,常用的有Gson Converter、Moshi Converter和Kotlinx Serialization Converter。CallAdapter(调用适配器)则决定了API方法的返回类型,开发者可以选择返回协程的suspend函数、RxJava的Observable、或者LiveData。在Kotlin协程普及后,suspend函数+Flow的组合已成为主流选择,它提供了结构化并发和背压处理能力。此外,OkHttp的Interceptor(拦截器)机制允许开发者在请求发送前和响应接收后插入自定义逻辑,常见用途包括添加认证Token、请求日志记录、网络状态检测和缓存策略管理。
值得一提的是,Retrofit的底层引擎OkHttp同样由Square公司开发,它实现了HTTP/2和SPDY协议支持、连接池复用、透明压缩、请求重试和重定向等关键特性。在Android数据层架构中,OkHttp负责底层的TCP连接管理和字节流传输,而Retrofit则在其之上提供了声明式的API抽象层。开发者还可以通过OkHttp的拦截器(Interceptor)机制实现统一的请求头注入、日志记录、Token刷新等横切关注点,这种分层设计使得网络通信栈既灵活又可维护。
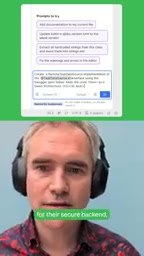
开发者的做法非常值得借鉴。他没有笼统地让AI"帮我写数据层",而是采取了几个关键策略:
1. 将API文档直接纳入提示词
他把部分API文档作为提示词(Prompt)的一部分直接提供给Gemini。这意味着AI不是凭空猜测接口结构,而是基于真实、准确的文档信息进行代码生成。这从源头上保证了生成代码与接口规范的一致性。
从技术原理来看,这种做法利用了大语言模型的In-Context Learning(上下文学习)能力。上下文学习允许模型在不更新权重的情况下,通过提示词中提供的示例和参考信息来"学习"新的任务模式。当开发者将API文档嵌入提示词时,模型会将文档中的结构化信息(端点路径、请求方法、参数列表、响应格式等)作为生成代码的约束条件,确保输出严格遵循文档规范。这与Fine-tuning(微调)不同——微调需要大量标注数据和训练过程,而上下文学习是即时的、一次性的。其效果取决于提供的上下文质量和相关性:越具体、越结构化的参考信息,模型生成的代码就越准确。这也是为什么直接提供API文档比口头描述API结构要有效得多。
2. 明确架构约束
他要求生成的代码必须适配项目中已有的接口定义。这一点至关重要——在真实项目中,代码从来不是孤立存在的,它必须融入既有的架构体系。
数据层架构与分层设计原则
在现代Android架构中(如MVVM、MVI或Clean Architecture),数据层(Data Layer)承担着关键的职责:它是应用与外部数据源(网络API、数据库、缓存等)交互的唯一通道,负责数据的获取、转换和持久化。良好的数据层设计需要遵循"单一职责原则"——它应该尽可能"薄"(thin),只处理数据的CRUD操作和格式转换,不包含任何业务逻辑或UI相关代码。这种分层设计的好处是显而易见的:数据层可以独立测试,业务逻辑变更不会影响数据获取方式,且便于切换不同的数据源实现(比如从网络切换到本地缓存)。在实际项目中,数据层通常包含Repository(仓储)、DataSource(数据源)和Model(数据模型)等组件,各司其职,形成清晰的依赖关系。
Clean Architecture(清洁架构)由Robert C. Martin提出,强调依赖规则——外层可以依赖内层,但内层不能依赖外层。在Android中,这通常被实现为三层结构:表现层(Presentation Layer)负责UI和用户交互,领域层(Domain Layer)包含业务规则和用例(Use Case),数据层(Data Layer)处理数据获取和持久化。Repository模式作为数据层的核心设计模式,通过定义接口(在领域层)和实现类(在数据层)的分离,实现了依赖倒置,使得业务逻辑完全不关心数据的来源是网络还是本地数据库。在本案例中,开发者要求AI生成的代码必须适配"已有的接口定义",本质上就是在确保AI输出遵循这一架构原则。
3. 精准限定任务边界
最关键的一步:他明确指示智能体只编写数据源部分,给它一个"小切片"(small slice)去处理,而不是一次性生成整个功能模块。
这个细节体现了与AI协作的核心经验:任务边界越清晰,AI的输出质量越高。当你把复杂问题拆解成明确、可控的小任务时,AI才能真正发挥价值。这也与软件工程中的"分而治之"(Divide and Conquer)原则一脉相承——无论是人类还是AI,处理小而明确的任务时,出错概率都会大幅降低,而输出质量则显著提升。
结果:架构精准、零业务逻辑泄漏
最终的成果让这位开发者用"魔术"(magic trick)来形容:
- 架构精准:生成的Retrofit数据源完美契合了项目既有的接口定义与架构规范;
- 零业务逻辑泄漏:数据层保持了纯粹,没有混入任何本不该出现在这一层的业务逻辑;
- 符合最佳实践:AI理解到数据源应当尽可能"薄"(as thin as possible),严格遵守了分层架构的设计原则。
换句话说,Gemini不仅仅是"写出了能跑的代码",而是写出了符合软件工程规范、结构清晰的高质量代码。这才是AI编程工具真正的价值所在。
评估AI生成代码的质量不能仅看"能否编译通过"或"功能是否正确",还需要考量多个软件工程维度:代码是否符合项目的命名规范和编码风格、是否遵循了SOLID设计原则、是否存在层级职责越界(如数据层混入业务逻辑)、异常处理是否完善、是否便于单元测试等。
SOLID是面向对象设计的五大基本原则:单一职责原则(SRP)要求每个类只有一个变更的理由;开放封闭原则(OCP)要求对扩展开放、对修改封闭;里氏替换原则(LSP)要求子类能够替代父类使用;接口隔离原则(ISP)要求接口应该小而专注;依赖倒置原则(DIP)要求高层模块不依赖低层模块的具体实现。在数据层设计中,SRP要求每个DataSource类只负责与一个特定的外部数据源交互;DIP要求数据层通过接口向上层暴露能力,使得业务逻辑层不依赖于具体的网络库或数据库实现;OCP则要求在添加新的API端点时,不需要修改已有的数据源代码,而是通过扩展来实现新功能。
在本案例中,"零业务逻辑泄漏"这一评价特别值得注意——它意味着AI不仅理解了语法层面的正确性,还理解了架构层面的约束,这是当前AI编程工具能力的一个重要里程碑,表明大语言模型已经具备了一定程度的软件架构认知能力。
启示:如何高效使用AI智能体
这个案例虽然简短,却蕴含了几条极具参考价值的AI协作方法论:
提示词工程(Prompt Engineering)实践
提示词工程是与大语言模型交互的核心技能,它决定了AI输出的质量和准确性。高质量的提示词应该包含三个关键要素:明确的任务描述、充足的上下文信息和清晰的约束条件。在本案例中,开发者将API文档直接嵌入提示词,这属于"上下文学习"(In-Context Learning)技术——通过提供具体的参考资料,让AI理解特定领域的规范和要求。同时,通过"架构约束"限定生成代码的接口规范,这是"约束式生成"(Constrained Generation)的应用,能有效避免AI输出不兼容的代码。而"任务切片"则体现了"链式思维"(Chain-of-Thought)的理念——将复杂任务拆解为多个可管理的小步骤,每一步都有明确的输入输出,这种方式显著提升了AI的执行成功率和代码质量。
第一,喂给AI高质量的上下文。 直接将API文档纳入提示词,让AI基于事实而非猜测工作,是保证代码准确性的前提。在大语言模型的工作机制中,提供具体的参考文档相当于为模型建立了一个临时的"知识锚点",使其生成内容能够紧密围绕实际需求,而非依赖训练数据中可能过时或不匹配的通用模式。
第二,用架构约束框定AI的行为。 告诉AI它的代码需要适配哪些既有接口和设计模式,能有效避免AI"自作主张"生成不兼容的代码。这本质上是在为AI设定"护栏"(guardrails),让它在一个安全的范围内发挥创造力。
第三,任务切片,逐步推进。 与其让AI一口气完成整个模块,不如给它明确的"小切片"。这不仅提升了输出质量,也让开发者更容易审查和把控最终结果。从实践经验来看,当任务范围超过200-300行代码时,AI生成代码的错误率和架构偏离度会显著上升;而控制在50-100行的"小切片"范围内,则往往能获得令人满意的结果。
结语
随着Gemini智能体模式深度集成进Android Studio等主流开发工具,AI正在从"代码补全助手"进化为"能够独立完成模块任务的开发伙伴"。对于开发者而言,掌握与AI协作的正确方法——提供优质上下文、设定清晰边界、合理拆分任务——将成为提升开发效率的关键技能。把枯燥的重复劳动交给AI,把宝贵的精力留给真正的创新,这或许正是AI编程工具带给我们最大的意义。
值得注意的是,这种人机协作模式并不意味着开发者的技能变得不重要。恰恰相反,只有深入理解软件架构、设计原则和项目规范的开发者,才能向AI提出精准的指令,并对AI的输出做出正确的评判。AI工具放大的是开发者已有的专业能力,而非替代它。未来的优秀开发者,将是那些既精通技术又善于驾驭AI工具的人。
相关推荐

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。

吴恩达谈Agentic AI:拨开炒作看智能体构建的核心技能
吴恩达 Agentic AI 课程开讲,剖析智能体炒作背后的真实价值。从客户支持、法律文档到医疗诊断的落地场景,揭示评估与错误分析为何是构建智能体工作流的核心技能。

吴恩达谈Agentic AI:构建智能体应用的核心方法论
吴恩达 Agentic AI 课程深度解读:从术语被过度炒作说起,剖析智能体工作流在客户支持、深度研究、法律与医疗诊断中的真实应用,并揭示优秀开发者依靠评估(Evals)与错误分析的纪律化开发流程这一核心方法论。