Gemma 4 并行智能体实战:本地多Agent协同生成SVG
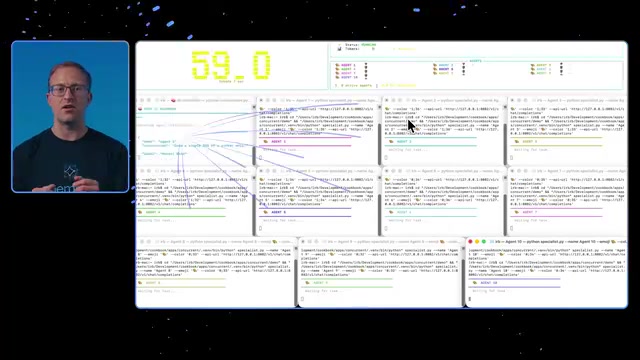
Gemma 4 26B本地运行编排器+10个并行子智能体,借助批处理在单机GPU上实现高吞吐多Agent协同。
本文介绍了一段 Gemma 4 26B 模型的本地多智能体演示:一个编排器智能体接收「生成科幻SVG图形」的指令后,将任务拆解并同时派发给10个子智能体并行执行,最终自动聚合结果生成完整画廊。核心技术支撑是模型批处理,通过将多个并发请求打包送入GPU,使单机在所有并发任务上达到超过170 tokens/s的合计推理速度。演示进一步将该能力延伸至企业场景,包括大规模任务并行求解以及为50人办公室提供完全本地、私有的聊天机器人服务,主打数据不出本地、无云端调用费用的部署优势。文章同时提示读者应理性看待演示数据:170 tokens/s为合计速度而非单Agent速度,真实效果还受任务可拆分度、子任务依赖关系和显存容量等因素制约。
Gemma 4 的并行智能体演示:本地多Agent协同
这段演示聚焦于 Gemma 4 的多智能体(multi-agent)能力,全程运行在本地环境,使用的是 Gemma 4 26B 模型。整个流程从一个简单的高层指令开始——「基于太空或科幻主题生成一组独特的 SVG 图形」。
值得关注的地方在于系统的调度方式:一个「编排器智能体」(orchestrator agent)接收到提示词后,并不会逐个生成图像,而是将任务拆解并分发下去。它一次性生成了 10 个独立的子智能体(sub-agents),让它们并行处理各自的子任务。
这种「拆分—分发—并行」的架构,本质上是把一个大任务降维成多个可并发的小任务。对于需要批量产出、彼此独立的工作负载来说,这种模式能显著压缩整体耗时。
批处理带来的本地推理性能
演示中强调,得益于 Gemma 4 的批处理(batch processing)能力,这 10 个子智能体可以在同一台本地机器上并行运行,甚至声称单块 GPU 也能承担。
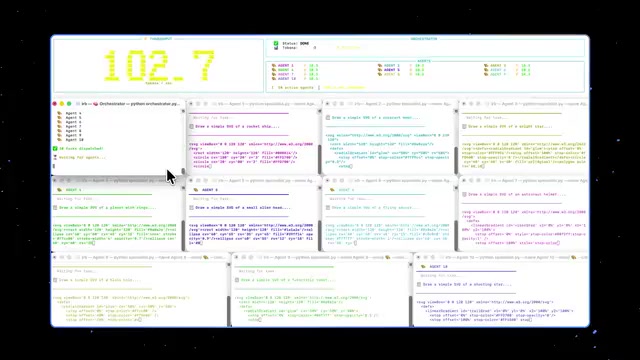
性能数据方面,演示给出的数字是在所有并发任务上达到每秒超过 170 个 token 的推理速度。模型批处理(model batching)是这里的关键——通过把多个请求打包成一个批次送入模型,硬件的计算资源利用率更高,从而在不增加显卡数量的前提下提升整体吞吐。
需要冷静看待的是,「170 tokens/s」是跨所有并发任务的合计速度,而非单个 agent 的独立速度。这种指标在批处理场景下是合理的表达方式,但读者在对比自己的实际负载时应注意这一点。
模型批处理(model batching)的原理值得进一步说明。GPU 的并行计算单元(CUDA core / tensor core)在处理单个请求时往往处于低利用率状态,大量算力处于等待或空闲。批处理通过将多个独立的推理请求拼接成同一个张量矩阵,一次性送入 GPU 完成矩阵乘法运算,从而将原本串行的多次计算合并为一次,显著提升硬件利用率。对于大语言模型而言,这通常通过「连续批处理」(continuous batching)实现——推理引擎动态地将已完成的序列替换为新请求,而不必等待整批序列同时结束,进一步减少 GPU 的空闲时间。这也是为什么在多智能体并发场景下,合计 token 吞吐率会远高于单个请求独占 GPU 时的速度。
从SVG画廊看自主协作的结果
几秒钟之内,各个子智能体完成了代码编写,编排器再把所有结果无缝收集起来,最终汇总成一个完整的 SVG 艺术画廊呈现给用户。
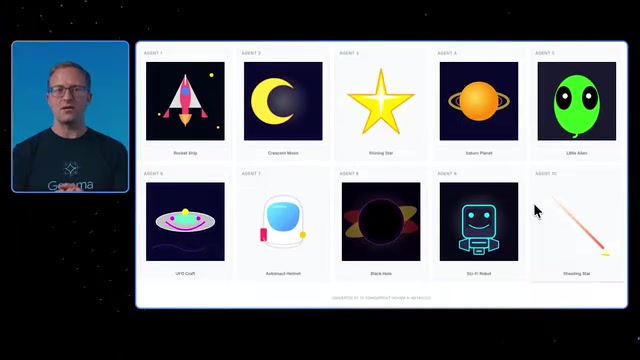
演示中反复强调的一点是:画廊里的每一个图标,都是由 Gemma 4 在本地、同时且自主地编写完成的。这说明多智能体的价值不只在「并行加速」,还在于「任务自动拆解与结果自动聚合」这一整条流水线的自动化程度。
面向真实工作流的想象空间
演示的收尾把这套能力延伸到了企业级场景。一个思路是:并行拉起 10 个甚至更多的 agent harness,把一个庞大的企业任务瞬间拆解并同时求解。
另一个更具体的设想是本地私有部署——为一个 50 人规模的办公室提供完全本地、私有的聊天机器人能力,全部跑在一到两块 GPU 上。
这个方向的吸引力在于数据隐私与成本:数据不出本地,无需为每次调用支付云端费用,同时通过批处理把有限的 GPU 资源摊薄到多个用户或多个任务上。对于对合规和数据主权敏感的团队来说,本地并行 AI 提供了一条不依赖外部 API 的路径。
「agent harness」在多智能体框架中指的是承载和管理单个智能体运行的执行容器或包装层,负责为每个子智能体提供独立的上下文、工具访问权限和生命周期管理。与单体应用不同,harness 化的智能体可以被批量实例化、监控和回收,是实现「弹性扩缩容」的基础。在本地 GPU 资源有限的场景下,harness 的设计直接决定了并发数量的上限——每个 agent 实例需要占用一定的 KV cache 显存,当并发量超过显存容量时,系统需要通过队列或分页机制进行调度,否则会导致 OOM(显存溢出)错误。
小结与观察
这段演示描绘了一个清晰的方向:本地化的并行多智能体正在成为一种可行的部署范式。核心技术支撑是编排器架构加模型批处理,把「一个大任务」变成「多个可并发的小任务」,再用批处理提升单机吞吐。
作为一段产品演示,它更多是展示能力上限而非严谨的基准测试。真实工作流中,任务的可拆分程度、子任务之间的依赖关系、以及显存对并发数量的限制,都会影响实际效果。但它给出的核心启发依然成立——当模型足够小巧、批处理足够高效时,把多个智能体压缩到一两块 GPU 上并行工作,正在从概念走向可用。
相关推荐
Java开发者入门AI Agent:Spring AI Alibaba框架实战指南
面向Java开发者的AI Agent入门指南,解析Agent核心概念、Workflow与Agentic技术流派划分,以及Spring AI Alibaba Agent Framework在企业垂直业务中的落地实战,助力简历包装与技术选型。
从零搭建企业级AI Agent:核心概念与四阶段学习路线拆解
从零搭建企业级AI Agent的完整指南:解析Agent核心概念、四大能力(翻译官/工具达人/记忆管家/任务管家)与基础到实战的四阶段学习路线,帮助AI开发者建立系统认知。
Fireworks推出SII专业智能指数:面向真实工作的行业基准
Fireworks推出SII专业智能指数:面向真实工作的行业基准
Fireworks推出Specialized Intelligence Index(SII)专业智能指数,聚合各行业真实工作基准测试,由实际使用团队构建,推动AI评测从通用榜单走向应用导向。