更多程序还是更多重复?拆解LLM Harness的覆盖率与专业化
受控实验揭示:自动生成LLM推理框架的覆盖率收益主要来自重复执行而非真正的任务专业化。
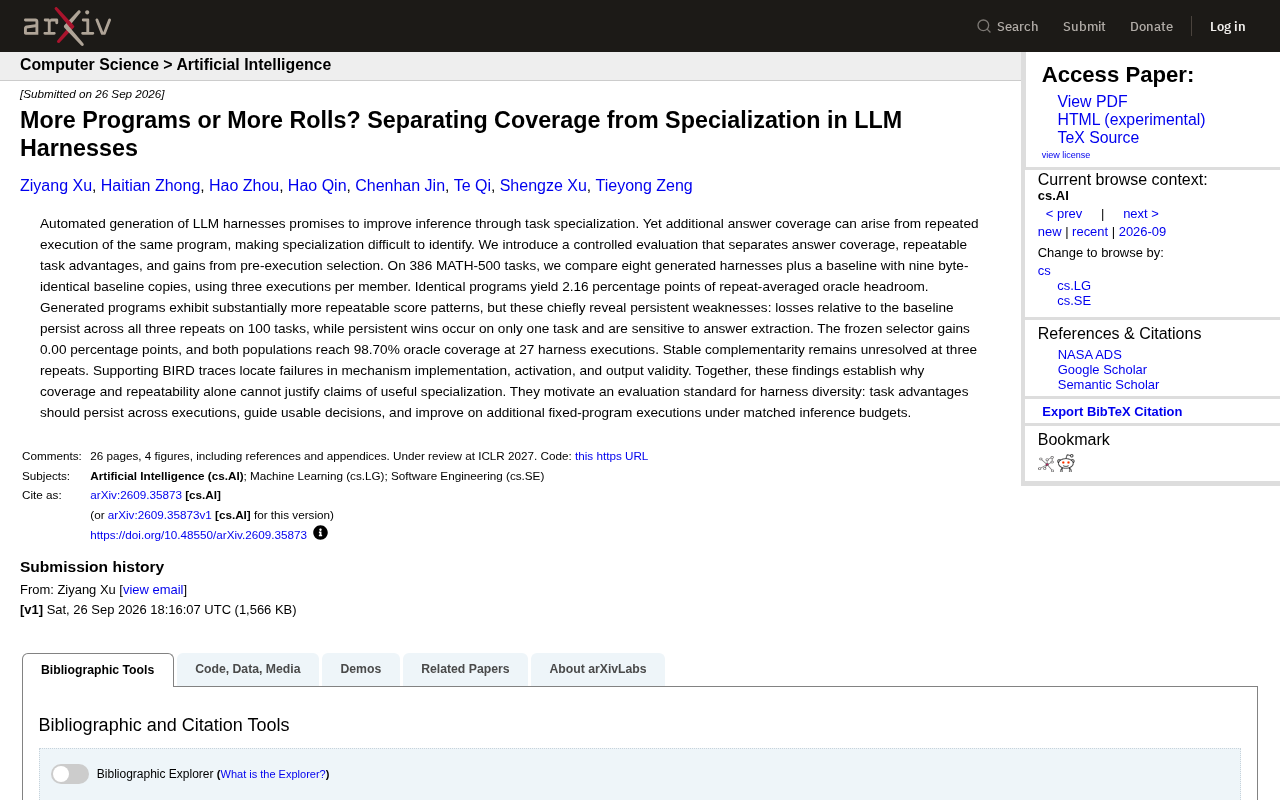
这篇arXiv论文针对"自动生成LLM harness能否带来有用专业化"这一问题设计了严格的受控实验。研究在MATH-500的386个任务上,用九个字节完全相同的基线副本作为对照组,将覆盖率收益拆解为重复执行效应、专业化效应和预执行选择效应三部分。结果发现,单纯重复执行已能带来2.16个百分点的oracle覆盖率提升;自动生成的harness虽呈现出可重复的得分模式,但100个任务持续输、仅1个任务持续赢,可重复性主要暴露的是稳定的弱点而非优势;两组程序在27次执行后均收敛至98.70%的oracle覆盖率,冻结选择器收益为零。据此,论文提出了更严格的专业化评估标准:优势须跨执行持续存在、能被选择机制利用,并在相同算力预算下优于简单重复基线。
一个被忽视的评估陷阱
自动生成LLM harness(推理执行框架)常被寄予厚望:通过任务专业化来提升大模型的推理表现。这背后的直觉很简单——为不同类型的任务定制专门的执行程序,理应比通用方案表现更好。但这项发表于arXiv的研究提出了一个尖锐的问题:我们真的能证明这些定制程序带来了"有用的专业化"吗?
研究团队指出一个容易被混淆的现象:额外的答案覆盖率(answer coverage)可能仅仅来自对同一个程序的反复执行,而不是来自程序本身的专业化能力。换句话说,如果你多跑几次同样的程序,命中正确答案的概率自然会上升,这种收益很容易被误读为"专业化优势"。
LLM Harness(推理执行框架)是指围绕大语言模型构建的一套程序化执行环境,用于控制模型的输入格式、推理流程、输出解析及答案提取等环节。在数学推理、代码生成等任务中,研究者常为不同类型的问题自动生成定制化的 harness,例如针对几何题生成含坐标计算逻辑的执行程序,期望通过任务专属的结构设计让模型"发挥得更好"。Oracle 覆盖率则是衡量 harness 集合性能的常用指标:若一组程序中至少有一个能在某道题上给出正确答案,则该题被"覆盖",覆盖率越高理论上代表这组程序的集体能力越强。问题在于,oracle 覆盖率本质上是一个上界指标——它只问"能不能命中",而不问"靠什么命中",因此极易将重复执行带来的随机命中误读为专业化带来的系统性优势。
受控实验的设计巧思
为了把不同来源的收益拆开来看,研究者设计了一套受控评估方案,专门区分三种效应:答案覆盖率、可重复的任务优势,以及来自预执行选择(pre-execution selection)的收益。
实验在 MATH-500 数据集的 386 个任务 上展开。对比对象包括八个自动生成的 harness 加一个基线程序,同时还准备了九个字节级完全相同的基线副本作为对照。每个成员执行三次。
这个"字节相同副本"的设计是全文的关键。它相当于一个纯净的对照组——因为这些副本代码完全一样,它们之间的任何得分差异都不可能来自专业化,只能来自随机执行的波动。这就为衡量"纯重复带来的收益"提供了基准。
重复本身能贡献多少?
结果显示,完全相同的程序在重复执行下,产生了 2.16 个百分点 的重复平均 oracle 提升空间。也就是说,仅仅靠多跑几次,就能挤出两个多百分点的覆盖率收益——这部分收益与任何"专业化"都无关。
生成程序的优势到底是什么
研究发现,自动生成的程序确实表现出更明显的可重复得分模式。乍看之下这像是好消息——稳定的模式意味着可预测的行为。但深入分析后,结论恰恰相反:这些可重复的模式主要暴露的是持续性的弱点,而非持续性的优势。
数据很能说明问题:相对于基线的性能损失在全部三次重复中持续存在的任务有 100 个,而持续性的胜出仅出现在 1 个任务上,并且这个胜出还对答案提取(answer extraction)方式高度敏感。
这意味着生成的 harness 更多是在稳定地"输",而不是稳定地"赢"。它们的可重复性并不能转化为可靠的任务优势。
选择器的收益为零
实验还评估了一个"冻结选择器"(frozen selector),即在执行前根据某种策略挑选程序。结果是它带来了 0.00 个百分点 的收益。这进一步说明,在缺乏真实专业化的前提下,预执行选择也无法凭空创造价值。
更有意思的是,两个群体(生成程序组与基线副本组)在 27 次 harness 执行后都达到了 98.70% 的 oracle 覆盖率。终点相同,恰恰说明专业化并没有在覆盖率上留下独特印记。
**答案提取(answer extraction)**是 harness 执行流程中的最后一环,负责从模型的原始输出中识别并提取最终答案,例如将"所以 x = 42"解析为数字 42。这一步骤看似简单,实则对评估结论影响显著——不同的提取规则(如正则表达式的宽严程度、对 LaTeX 格式的兼容性等)会导致同一模型输出被判为正确或错误。本文中那个"持续胜出的 1 个任务"对答案提取方式高度敏感,意味着其优势可能并不来自推理能力本身,而是恰好契合了某种特定的输出格式约定。这提示研究者:在比较不同 harness 时,需要保持答案提取逻辑的一致性,否则格式匹配的差异会污染专业化能力的测量。
失败到底出在哪里
借助 BIRD 追踪(BIRD traces),研究定位了失败的具体环节,主要集中在三个方面:机制实现(mechanism implementation)、激活(activation)和输出有效性(output validity)。
这个诊断很有价值。它说明生成 harness 的问题往往不是"策略方向错了",而是在把机制真正落地、正确触发、以及产出符合规范的输出这些工程层面上出了问题。换句话说,很多失败是可修复的实现缺陷,而非根本性的能力缺失。
BIRD(Behavior-Informed Reasoning Diagnosis,或类似的行为追踪机制)是一种对程序执行过程进行细粒度分解的诊断工具,将失败原因拆解到具体执行步骤层面。机制实现失败指程序中的核心算法逻辑存在错误,例如循环边界写错或公式推导有误;激活失败指程序虽然实现正确,但未能在适当条件下被触发执行,例如条件分支判断失效导致关键代码路径被跳过;输出有效性失败则指程序执行完成但输出格式不符合下游答案提取的规范要求。将失败定位到这三个层级的意义在于:它们对应不同的修复策略——实现错误需要修改算法,激活错误需要调整控制流,输出有效性错误只需规范化输出格式。这种分层诊断为未来改进自动生成 harness 的质量提供了具体的工程抓手。
为专业化立一个更硬的标准
这项工作最核心的贡献,是说明了为什么单靠覆盖率和可重复性无法证明有用的专业化。稳定的得分和更高的命中率看起来很诱人,但它们可能只是重复执行的副产品。
基于此,作者提出了一套 harness 多样性的评估标准。真正有用的任务优势应当满足三个条件:
- 跨执行持续存在:优势不能是单次运气,要在多次重复中稳定复现;
- 能指导可用的决策:优势必须能被选择机制利用,转化为实际收益;
- 在匹配的推理预算下超越额外的固定程序执行:也就是说,专业化程序要能打败"简单地多跑几次基线"这个朴素基准。
第三条尤其关键——它把"更多程序"与"更多重复"放在同一推理预算下正面对决。如果一个精心生成的 harness 组合,其收益还不如把同样的算力用来重复运行基线,那所谓的专业化就名不副实。
对实践者的启示
对于正在探索 LLM agent、多程序采样或自动化推理框架的团队,这篇论文提供了一个务实的警示:不要被覆盖率数字迷惑。在报告专业化收益之前,先问自己一个问题——同样的算力预算下,简单重复执行能不能达到相近的效果?
研究也坦承,在三次重复的条件下,稳定的互补性(stable complementarity)问题仍未解决。这为后续工作留下了空间:需要更多的重复次数、更严格的匹配预算,以及对答案提取鲁棒性的关注,才能真正厘清 harness 多样化的价值边界。
这类严谨的"祛魅"研究,对于避免评估中的自欺尤为重要。当整个领域都在追逐更复杂的自动化框架时,一个能把随机收益和真实能力清晰分开的评估方法论,其价值不亚于任何新方法本身。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。