gg-friggin-ez:面向Node.js的免费多语言内容审核工具

gg-friggin-ez 是一款面向 Node.js 的开源多语言内容审核工具,主打印度语系支持、抗规避能力与超低处理成本。
gg-friggin-ez 是一款可通过单行 npm 命令接入 Node.js 项目的开源内容安全过滤器,由 Shikhar Srivastava 开发。其核心差异化在于三点:原生支持卡纳达语、泰米尔语、印地语等印度语系(主流方案普遍覆盖不足);具备 evasion-aware 能力,可识别 leetspeak、ASCII 图形、字符间距及罗马化拼写等常见规避手段;以及极低的处理成本(每百万条消息约 4 美元,延迟低于 500 毫秒)。工具底层依托 TypeSafe AI 的 System 1 模型,强调「快、准、便宜」。不过该产品仍处于早期阶段,模型技术细节不透明,多语言准确率和生产环境稳定性有待更多实践验证,适合对成本敏感、需覆盖南亚语言的团队列入候选方案小规模评估。
一个专为开发者打造的内容安全过滤器
在社交产品、评论系统和聊天应用日益普及的今天,内容审核成为绕不开的技术难题。开源工具 gg-friggin-ez 试图用一种轻量、低成本的方式解决这一痛点——它是一款可直接嵌入 Node.js 项目的多语言脏话与毒性内容筛查器,由 Shikhar Srivastava 开发,目前在 Product Hunt 上获得 78 票,排名第 13。
该工具的核心定位是「drop-in」,也就是即装即用。开发者通过一行 npm i gg-friggin-ez 即可集成,无需复杂配置。其底层由所谓的 System 1 模型驱动,包括 TypeSafe AI 的 Jev 与 Laya,主打「快、准、便宜」三个特性。
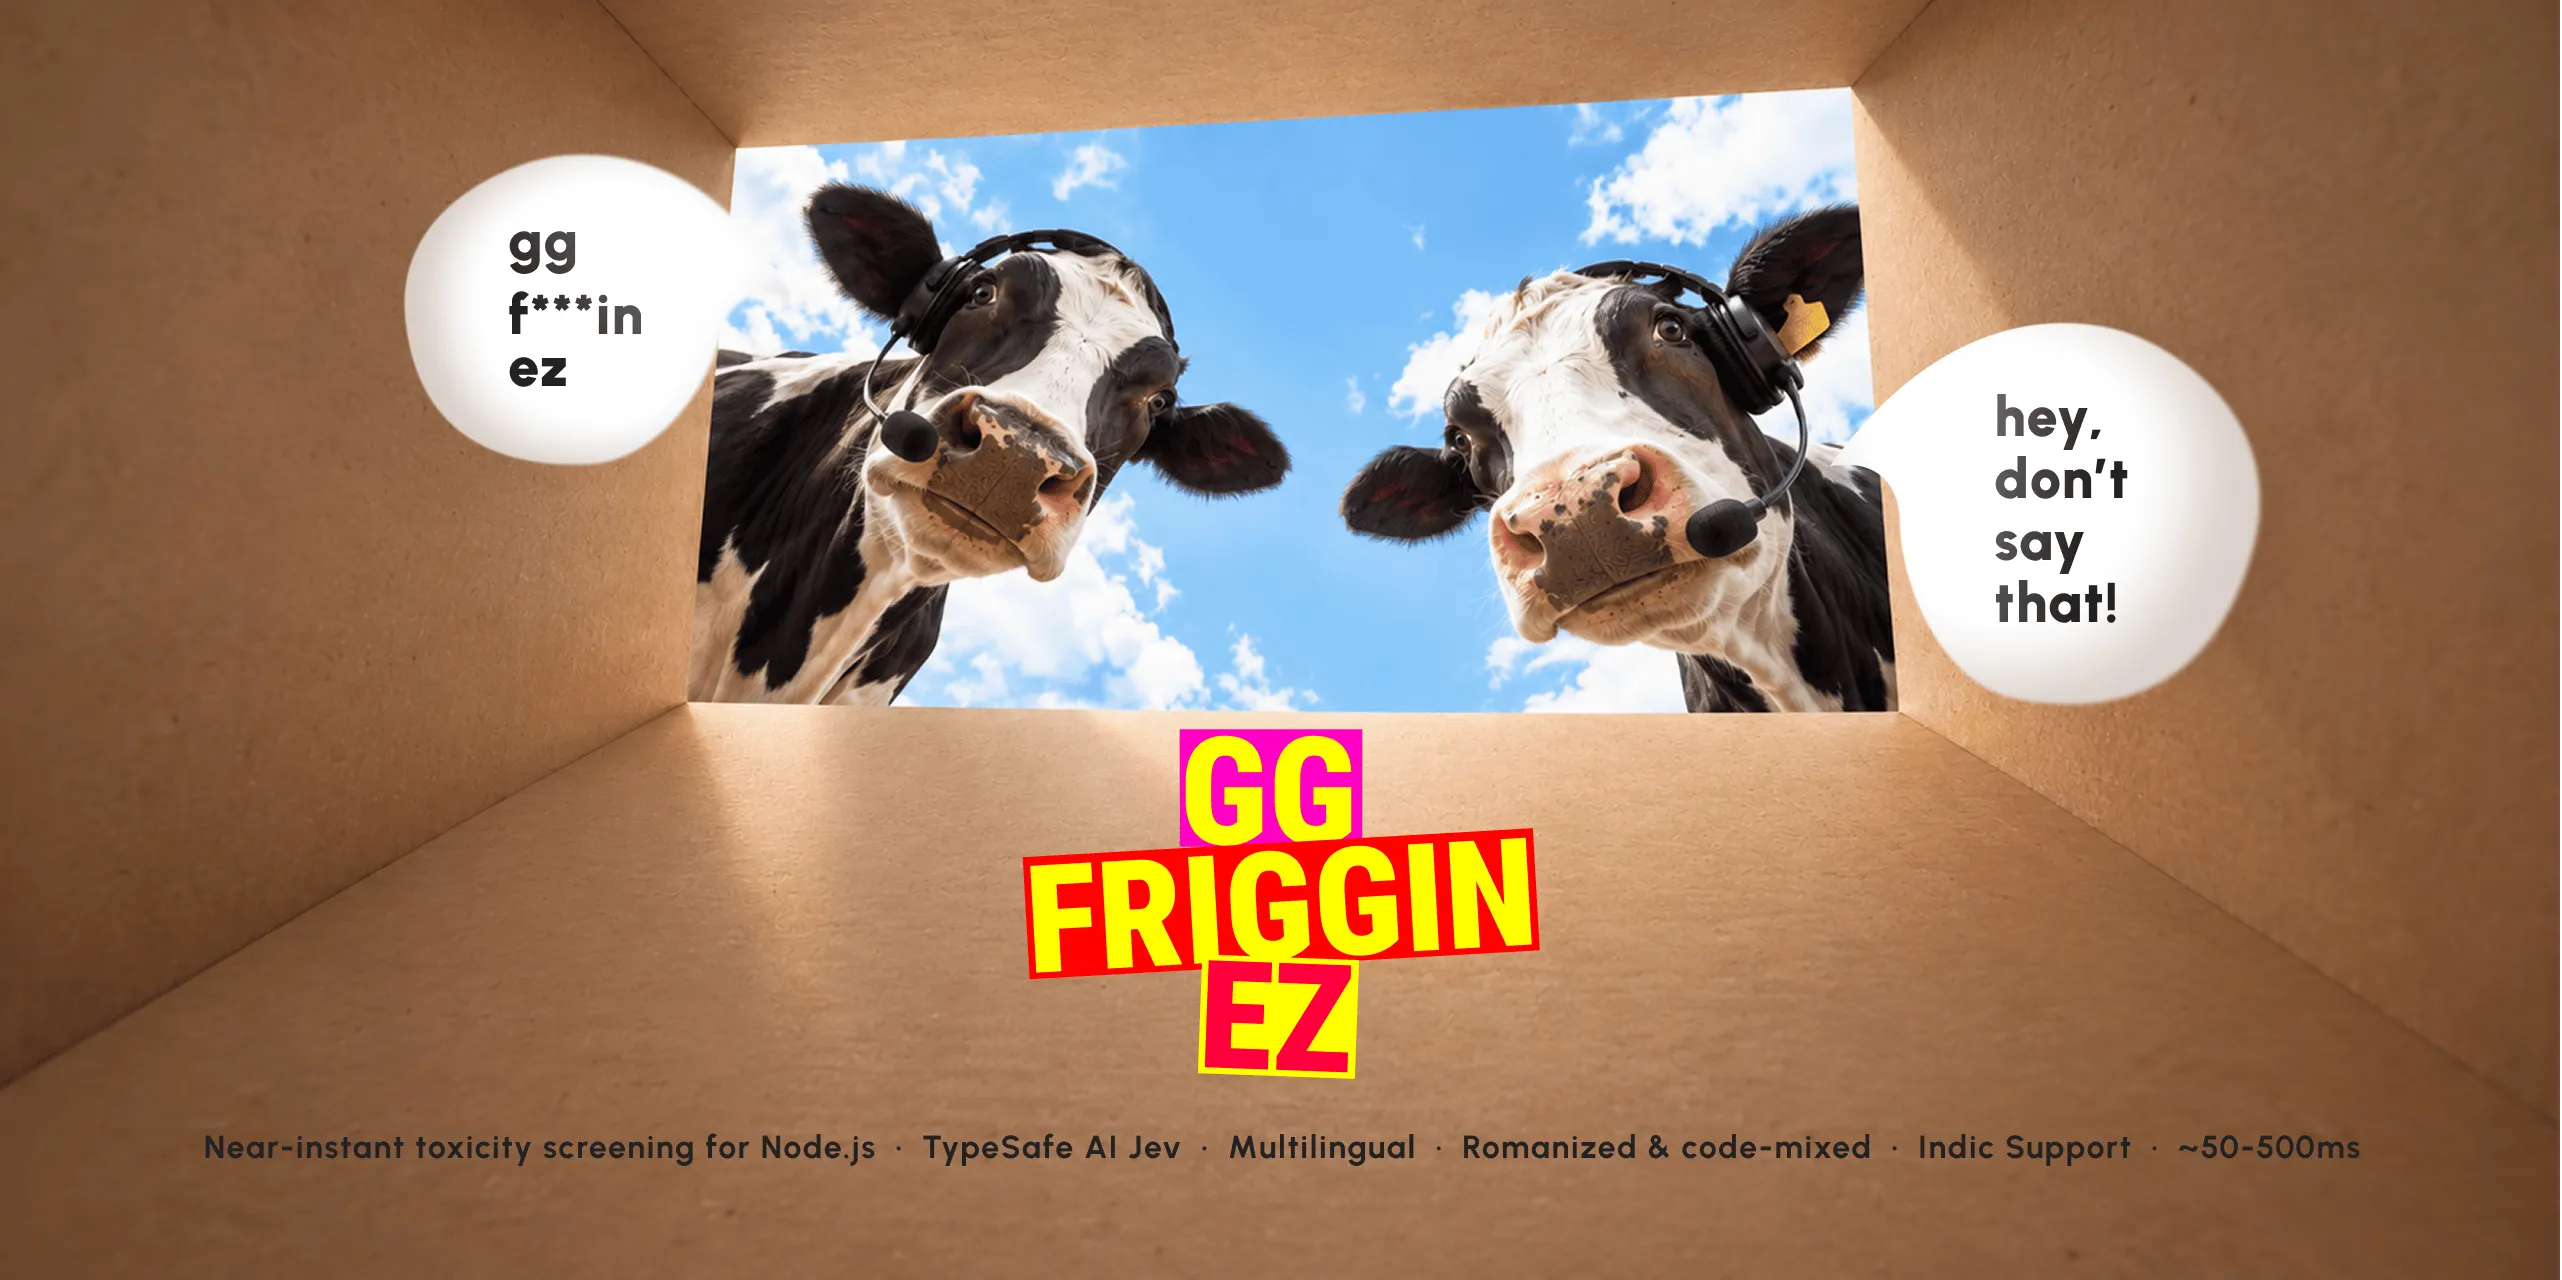
三大技术亮点:多语言、抗规避、超低成本
原生支持印度语系
与大多数只针对英语的审核工具不同,gg-friggin-ez 强调对印度语系的原生支持,覆盖卡纳达语(Kannada)、泰卢固语(Telugu)、泰米尔语(Tamil)、印地语(Hindi)和孟加拉语(Bengali)等。这对于面向印度及南亚市场的产品而言是一个明显的差异化优势——这些语言在主流内容审核方案中往往支持不足。
抗规避能力
内容审核的真正挑战在于用户的「花式规避」。gg-friggin-ez 宣称能够识别多种常见的绕过手段,包括 leetspeak(用数字和符号替代字母,如 h3ll0)、ASCII 图形、字符间加空格,以及罗马化拼写的脏话。这种 evasion-aware(规避感知)能力是判断一个审核工具是否实用的关键指标。
Leetspeak 起源于早期黑客和游戏社区,是一种将字母替换为视觉相似的数字或符号的书写习惯,例如将 "a" 写成 "@" 或 "4",将 "e" 写成 "3",将 "i" 写成 "1" 或 "!"。这类变体对基于关键词匹配的传统过滤器几乎完全失效,因为字符串在字面上已经发生了变化。罗马化(Romanization)则是另一种常见规避方式,指将非拉丁文字(如印地语的天城文、泰米尔文等)用拉丁字母拼写出来,使得原本针对本地字符集训练的模型无法识别其语义。这两类规避手段结合,构成了多语言内容审核中最难处理的技术挑战之一,也是 gg-friggin-ez 着重强调这一能力的背景所在。
性能与成本
据产品介绍,该工具的响应延迟低于 500 毫秒,每条消息处理成本约为 0.000004 美元。换算下来,处理 100 万条消息的成本仅约 4 美元,对于需要大规模处理 UGC(用户生成内容)的应用来说,这样的成本结构极具吸引力。
为什么这类工具值得关注
内容审核长期存在一个矛盾:商业化的第三方 API(如 Perspective API、各类云厂商的 moderation 接口)虽然功能强大,但存在成本高、多语言覆盖不均、数据需要出境等问题。而开源、自托管的方案则给了开发者更多控制权。
gg-friggin-ez 选择开源路线并挂靠在 npm 生态,降低了接入门槛。它把审核动作设计成可配置(configurable moderation actions),意味着开发者可以根据业务场景自定义命中后的处理逻辑——是直接拦截、打标记还是人工复审,交由使用方决定。
Perspective API 是由 Google 旗下 Jigsaw 团队开发的在线内容毒性检测服务,通过 REST API 调用,按请求量计费,对英语和部分欧洲语言支持较好,但印度语系覆盖有限。各大云厂商(如 AWS Comprehend、Azure Content Moderator)也提供类似服务,功能完整但价格随规模线性上升,且所有数据均需传输至第三方服务器,在数据本地化合规要求严格的场景(如印度 PDPB 法规、欧盟 GDPR)下可能产生合规风险。自托管开源方案能让数据全程留存在开发者自己的基础设施内,从根本上规避数据出境问题,这也是 gg-friggin-ez 强调开源与可配置性的重要背景动因。
需要理性看待的地方
作为一款处于早期阶段的产品,gg-friggin-ez 目前的社区反馈还比较有限(仅 1 条评论)。其宣称的多语言准确率、抗规避的实际效果,以及在生产环境下的稳定性,都还需要更多实践检验。
此外,「System 1 模型」这一表述以及 Jev、Laya 的具体技术细节在公开信息中并不清晰,开发者在选型时应结合自身的数据合规要求和审核精度需求,进行小规模验证后再大规模部署。
对于正在寻找轻量级、成本敏感、且需要覆盖非英语(尤其是印度语系)内容审核方案的团队来说,这款开源工具值得纳入候选清单进行评估。
「System 1 模型」这一命名借用了心理学与行为经济学中的概念——诺贝尔奖得主丹尼尔·卡尼曼将人类思维分为快速直觉的「系统1」和缓慢分析的「系统2」。在 AI 产品语境中,TypeSafe AI 用这一术语来指代其轻量、低延迟、以快速推理为优先的模型架构,与需要更多计算资源的深度推理模型相对。但目前 Jev 和 Laya 这两个模型的架构细节、训练数据来源、参数规模等关键信息均未公开,开发者无法独立评估其在特定语言或特定内容类型上的实际精度边界,这是选型前需要通过实测加以验证的核心不确定因素。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。