GitHub一周热点:五个高星项目满足不同开发需求
GitHub周榜五星项目盘点:用配套工具管住AI干活的过程。
本周GitHub趋势榜五个项目合计收获超四万星,共同指向AI工具能力已强、但记忆、隔离、远程访问与质量校验等配套环节仍靠人肉补位的痛点。claude-mem用钩子压缩工具调用记录,让AI助手跨会话保留上下文,但依赖Node.js 20.19以上及额外运行环境;Claude-Code-Game-Studios把对话拆成49个分层助手,作者盲测显示文档最多的版本反而最重;t3code复用原有订阅把编码助手接到手机网页,增速最快却处于早期且不收社区贡献;worktrunk用独立工作目录隔离并行任务,Windows存在命令冲突;反AI位设计规范以八分度检查和新手复审替代模板堆砌,浏览器检查需另装依赖。
这一周GitHub趋势榜被五个项目强势占领,合计收获超过四万颗星。它们分别瞄准记忆管理、游戏开发、远程控制、目录隔离和前端设计规范,每一个都试图解决开发者日常工作中的某个具体痛点。本文根据B站UP主的盘点视频,结合项目实际定位,逐一拆解这五个项目的核心能力与落地代价。
claude-mem:给AI助手装上持久记忆
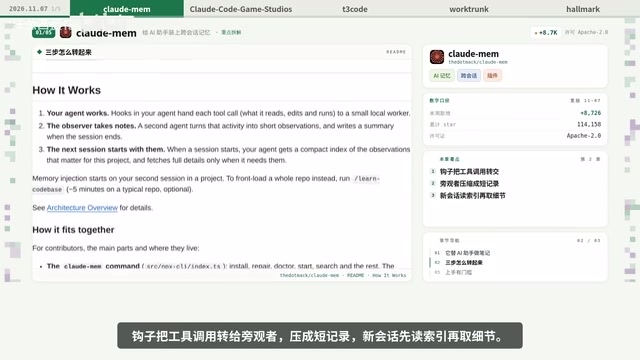
AI助手每次开启新会话都要从零交代背景,这是许多开发者共同的困扰。claude-mem插件的思路很直接:把每次任务执行的过程完整记录下来,下次开工时先读取索引,再按需取用细节。
实现上,它通过钩子把工具调用转交给一个旁观者进程,将冗长的操作日志压缩成短记录。这样既保留了上下文,又不会让记忆文件无限膨胀。代价同样明确:需要Node.js 20.19以上版本,还得额外安装两个运行环境。据UP主介绍,该项目一周涨了八千多星,说明“记忆断层”确实是高频痛点。
钩子(Hook)机制:在 Claude Code 这类 AI 编码助手的工作流中,钩子是指由工具在特定生命周期节点(如工具调用前后、会话开始或结束时)自动触发的回调脚本。claude-mem 正是借助这一机制,在不改变用户操作习惯的前提下,把每次工具调用的输入输出旁路给一个独立进程,由后者负责压缩和索引。理解钩子是理解该项目为何能做到“无感记录”的关键——它并不侵入 AI 的推理过程,只是在事件流上挂载了观察者。
Claude-Code-Game-Studios:把对话拆成一家游戏公司
一个人做游戏最怕流程失控。这套模板把单次对话拆成49个专属助手,分三层管理:3位总监把握方向,9位组长分管领域,30多位专员负责执行。层级分明,像一家真实运转的游戏工作室。
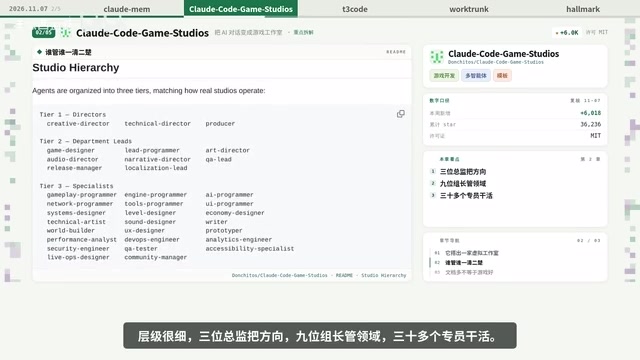
一周六千多星的增长印证了独立开发者对结构化协作的渴望。但作者自己的盲测结果值得注意:文档最多的版本反而得分最厚(即表现最重、最不灵活),且主力环境仍在Windows。这意味着模板的复杂度可能成为负担,使用者需要根据项目规模裁剪层级,而不是全盘照搬。
t3code:把AI编码助手装进手机
手机面板类工具并不新鲜,但t3code的卖点在于复用你原有的订阅,把AI编码助手接到手机、网页和桌面端。安装只需一条命令启动服务,常见系统都有现成安装包,一周涨了一万六千多星,是本周增速最快的项目。
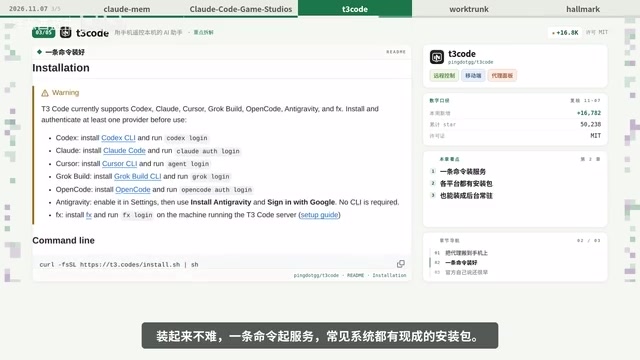
不过官方明确标注项目仍处于早期,基本不接受社区贡献,文档站也尚未搭建。对于想长期依赖它做远程开发的用户,这意味着遇到问题时缺少社区兜底,需要自己啃源码或等待官方更新。
worktrunk:一个助手一个目录,并行不打架
并行执行多个AI任务时,最大的风险是改动互相踩踏。worktrunk的做法是按分支名把每个助手隔离到独立工作目录,三条命令即可完成切换、拉起工具和合并清理。
这个思路朴素但有效,一周两千多星的增长虽然不算爆炸,却精准命中了多智能体协作的基础设施缺口。代价是安装后还需接一次外壳配置,Windows上命令名还会与系统冲突,跨平台体验有待打磨。
工作目录隔离与 Git worktree:worktrunk 所采用的“按分支名隔离到独立目录”思路,底层通常依赖 Git 的 worktree 能力——它允许同一个仓库同时检出多个分支到不同路径,共享对象库却互不干扰工作区。相比复制整个仓库,worktree 占用空间小、切换成本低,天然适合让多个 AI 助手并行修改不同分支。这也是该项目能用三条命令完成切换、拉起与合并的技术前提;若无 worktree,并行隔离将退化为笨重的完整克隆。
反AI位设计规范:用判断标准替代模板堆砌
设计领域不缺模板,缺的是判断标准。这套规范包含50套主题、700多张授权真图,按主题直接排出版式。它的做法很硬:八分度逐个检查,最后另派新手复审,页面结论写入一份文件。一周六千九百多星,说明开发者对“可验证的设计质量”有真实需求。
缺点是浏览器检查需要另装依赖,没装的话只能跑静态检查,动态渲染问题会被漏掉。对于追求上线前完整验证的团队,这笔安装成本不能省。
八分度检查:所谓“八分度”是一种把设计质量拆成多个可打分维度的审查方法,每个维度按八分制评估,逐项检查而非凭感觉判断整体好坏。它的价值在于把“这个页面好不好看”转化为“间距、层级、对比、对齐等各项是否达标”的可复核结论,并最终写入文件形成可追溯记录。这种量化审查配合新手复审,构成了该规范区别于普通模板库的核心——模板只提供起点,八分度检查才提供可验证的终点。
五个项目的共同信号
把这五个项目放在一起看,会发现它们都在解决同一类问题:AI工具的能力已经够强,但记忆、隔离、远程访问和质量校验这些配套环节仍靠人肉补位。四万多颗星不是投给功能,而是投给“把AI干活的过程管起来”这件事。选择哪个项目,取决于你当前最痛的那一环。
本文基于B站UP主的一周热点盘点整理,项目链接见原视频简介。
相关推荐
AI ഉറങ്ങുമ്പോൾ എന്ത് സംഭവിക്കും? Anthropic Agent Memory #TechMalayalam #AgenticAI #ClaudeAI
从Anthropic的Claude与Agent Memory机制出发,解析AI智能体在会话之间如何加载、整理与丢弃记忆,以及自评估循环、笔记规则对开发者的实际启发。
英伟达CEO绯闻背后:AI基建的"关键人风险"
英伟达CEO黄仁勋绯闻引发董事会独立调查,芯片股大涨而英伟达独自下跌。本文拆解AI基建背后的关键人风险,以及房地产投资者如何用三步核查保护自己的交易。
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。