GLM-5.3 Flash:智谱轻量模型如何抢占低成本推理赛道

一条推文背后的信号
近日,一条简短的推文在AI社区引发关注:「add oil. The best time to try GLM-5.3 Flash」(加油,现在正是体验 GLM-5.3 Flash 的最佳时机)。这句带着中式英语鼓励意味的推广语,指向的是智谱(Zhipu AI)GLM 系列中的轻量级模型——GLM-5.3 Flash。
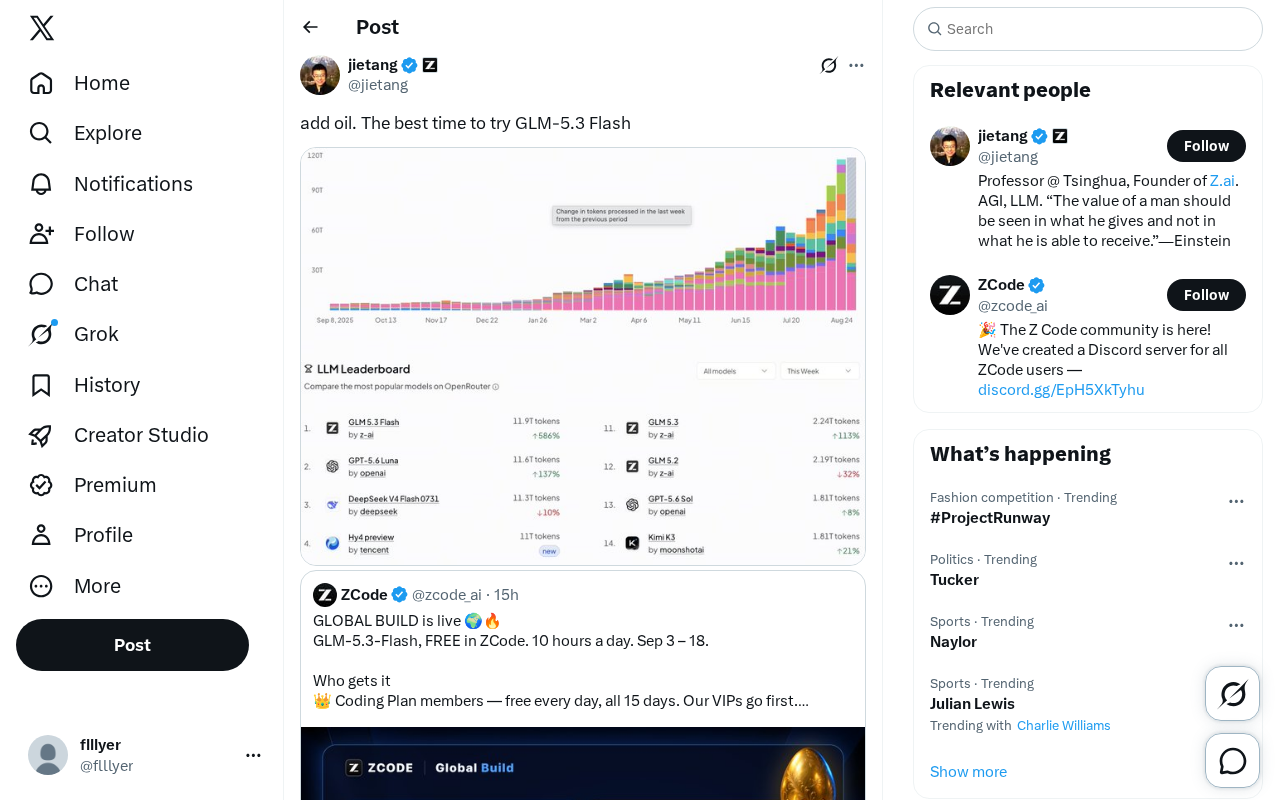
尽管原始信息极为简短,但它折射出当前大模型行业一个鲜明的趋势:头部厂商正在加速推出「Flash」类轻量高速模型,抢占开发者与低成本推理场景。对于长期关注国产大模型的用户而言,GLM 系列的每一次迭代都值得留意。
GLM 系列与「Flash」模型定位
Flash 型模型究竟解决什么问题
在大模型命名体系中,「Flash」通常代表一类追求高吞吐、低延迟、低成本的轻量化模型变体。它不以极致的推理能力或参数规模取胜,而是在性能与成本之间寻找最佳平衡点,专门服务于对响应速度敏感、调用量巨大的实际应用场景。
这一命名思路并非智谱独创。在大模型产品线中,'Flash'这一命名策略源自Google在2024年推出的Gemini 1.5 Flash。 谷歌的 Gemini Flash、以及众多厂商推出的「mini」「lite」系列,都在传递同一个产品逻辑:并非所有任务都需要最强的旗舰模型。
这类模型通常采用蒸馏(Distillation)、剪枝(Pruning)或混合专家(MoE)等技术,在保留核心能力的同时大幅降低参数量和计算开销。 典型特征包括:推理延迟降低50-80%、API调用成本下降60-90%、上下文窗口保持在32K-128K token范围。Flash类模型的轻量化并非简单地缩小参数规模,而是涉及一整套系统化的模型压缩技术栈。除了上述方法外,还包括量化(Quantization)技术——将模型权重从FP32/FP16降至INT8/INT4精度,可将模型体积缩小2-4倍且推理速度提升1.5-3倍,精度损失控制在1-2%以内。
此外,推测解码(Speculative Decoding)技术让小型草稿模型先快速生成候选token序列,再由大模型批量验证,可在不损失输出质量的前提下实现2-3倍加速。Flash模型通常还会针对特定硬件(如NVIDIA的TensorRT推理引擎)进行算子级优化,利用FlashAttention-2等内存高效注意力机制降低GPU显存占用。这类模型的技术权衡在于牺牲部分复杂推理能力(如多步数学证明、深度代码重构),换取在信息抽取、情感分析、内容审核等高频任务上的极致性价比。
对于内容分类、意图识别、简单问答、批量文本处理等高频轻量任务,一个又快又便宜的模型往往才是工程上的最优解。
GLM-5.3 的版本演进脉络
GLM 是智谱自研的通用语言模型系列,从早期的 ChatGLM 开源版本,到 GLM-4、GLM-4.5 系列,再到如今推文中提及的 GLM-5.3 Flash,其迭代节奏明显加快。GLM(General Language Model)系列采用清华大学自研的双向注意力架构,融合了自回归(Autoregressive)和自编码(Autoencoding)两种预训练范式。其核心创新在于通过'空白填充'(Blank Infilling)预训练目标,使模型同时具备文本生成和理解能力。
相比纯decoder架构(如GPT),GLM在中文NLU任务上平均提升8-15个百分点;相比encoder-decoder架构(如T5),推理效率提升约40%。GLM-4开始引入多模态能力,GLM-5系列则强化了长文本处理(支持128K上下文)和工具调用(Function Calling)能力。
智谱AI(Zhipu AI)成立于2019年,孵化自清华大学计算机系知识工程实验室(KEG Lab),核心团队包括唐杰教授等学术带头人。 公司在2022年发布ChatGLM-6B开源模型,迅速成为国内最广泛使用的开源中文大模型之一,GitHub星标数超过40K。智谱的商业化路径包括MaaS(Model-as-a-Service)平台「智谱清言」、企业级API服务「BigModel」、以及面向垂直行业的定制化解决方案。2024年,智谱完成新一轮融资,估值突破200亿人民币,投资方包括社保基金、中关村科学城等国资背景机构,体现了国家对自主可控大模型技术的战略重视。
版本号从 4 跨越到 5,通常意味着底层架构或训练数据经历了重要升级;而带上「Flash」后缀,则表明智谱正在完善自己的模型矩阵分层策略——用旗舰模型对标能力上限,用 Flash 模型覆盖规模化落地需求。
为何「现在正是最佳体验时机」
推文中「The best time to try」的措辞并非单纯的营销话术,背后往往对应着几种现实层面的激励:
- 免费或优惠额度:新模型上线初期,厂商普遍会开放免费调用额度或大幅折扣,以吸引开发者尝鲜并收集真实反馈。
- 性能拐点:GLM-5.3 相较此前版本,可能在推理速度、上下文长度或多语言能力上有了质的提升,达到了「值得一试」的临界点。
- 生态窗口期:在开发者尚未大规模锁定某一模型供应商之前,抢占心智是新品推广的关键。
对于开发者而言,模型上线初期恰恰是测试成本最低、迁移风险最小的阶段。趁着优惠额度充足、社区讨论活跃时进行评测,能够以最小代价判断该模型是否契合自身业务。
轻量模型竞赛的行业逻辑
成本是规模化落地的真正分水岭
随着大模型从「炫技」走向「落地」,企业越来越关注单次调用成本。大模型API通常按token计费,1 token约等于0.75个英文单词或0.5个中文字符。主流定价模式分为输入token(Prompt)和输出token(Completion)两档,后者价格通常为前者的2-3倍。 以GPT-4为例,输入$0.03/1K tokens、输出$0.06/1K tokens;而Flash类模型可降至输入$0.0015/1K、输出$0.002/1K,成本降幅达95%。
输出token比输入token定价更高,根源在于底层推理的计算不对称性。 输入阶段可以利用并行化的prefill操作一次性处理所有token,而输出阶段必须逐token自回归生成,每生成一个token都需要完整的前向传播。此外,KV Cache(键值缓存)是影响推理成本的关键因素——长上下文场景下,KV Cache的显存占用可超过模型权重本身。Flash模型通常采用GQA(Grouped-Query Attention)或MQA(Multi-Query Attention)技术,将KV Cache压缩4-8倍,从而在相同硬件上支持更高的并发请求数,这也是其低定价的技术基础。
一个能力略弱但价格只有旗舰模型十分之一的 Flash 模型,在海量调用场景下可能带来数量级的成本节约。在日均千万次调用的场景下,这意味着月度成本从数十万美元降至数千美元。因此,合理的模型选择策略是:用Flash处理80%的简单任务,仅对剩余20%复杂场景调用旗舰模型。 这也是为什么几乎所有主流厂商都在同步推进「顶配旗舰 + 高性价比轻量」的双线产品策略。
国产大模型的差异化突围
在国产大模型阵营中,智谱、DeepSeek、阿里通义、月之暗面等厂商竞争激烈。GLM-5.3 Flash 的推出,本质上是在中文场景优化、成本控制与开发者生态三个维度上寻求突破。
中文处理相比英文面临三大技术挑战:1)分词歧义(如'研究生命'可切分为'研究/生命'或'研究生/命');2)字符密度高(相同信息中文token数约为英文60%,导致上下文容量实际缩水);3)形近字干扰(模型容易混淆'己/已/巳''戊/戌/戍'等)。 国产模型通常采用针对性优化:扩大中文语料占比至70%以上、使用字-词混合tokenization、在预训练中加入汉字字形/拼音等辅助信号。
混合专家(Mixture of Experts, MoE)架构在Flash类模型的中文优化中扮演着重要角色。 MoE的核心思想是:模型虽然拥有庞大的总参数量,但每次推理时只激活其中一小部分「专家」子网络。例如,Mixtral 8x7B模型总参数46.7B,但每个token仅激活约12.9B参数(2个专家),推理成本接近13B参数的稠密模型,而性能可媲美70B级别。门控网络(Gating Network)负责为每个输入token动态选择最相关的专家。不同专家可以自然地「专精」不同语言或任务类型,这使得MoE架构特别适合需要同时处理中英文的模型场景。
相较于直接与 GPT 级旗舰正面硬碰,通过轻量高速模型切入高频应用市场,反而是一条更务实的路径。
开发者如何评估 GLM-5.3 Flash
面对新上线的 GLM-5.3 Flash,建议开发者以务实态度进行评估:
-
明确任务类型:Flash 模型适合高频轻量任务(如分类、摘要、简单问答)。Flash类模型的核心技术是知识蒸馏(Knowledge Distillation),由Hinton等人在2015年提出。其原理是用大型'教师模型'的输出概率分布指导小型'学生模型'训练,使后者学会模仿前者的决策模式而非简单拟合标注数据。 蒸馏过程中引入的「温度」参数(Temperature)控制概率分布的平滑程度——较高的温度使教师模型的softmax输出更均匀,帮助学生模型学习到类别之间的细微相关性(即「暗知识」dark knowledge)。若涉及复杂推理、长文创作或代码生成,仍需对比旗舰模型的表现。
-
实测延迟与吞吐量:Flash 的核心卖点是速度,务必在真实并发环境下测试其响应时延与稳定性。云端大模型服务通常实施限流(Rate Limiting)策略:按RPM(每分钟请求数)、TPM(每分钟token数)、并发请求数三个维度约束。 Flash模型因推理速度快(单请求耗时50-200ms vs 旗舰模型500-2000ms),在相同TPM限制下可支持更高QPS。评估时需用压测工具(如Locust、JMeter)模拟真实并发,测量P95/P99延迟和429错误率。此外,还需关注首token延迟(Time to First Token, TTFT)和逐token生成速度(Tokens Per Second, TPS)两个关键指标——前者影响用户的「等待感知」,后者决定长文本生成任务的整体耗时。
-
算清长期成本账:结合预估调用量计算长期成本,将其与现有方案横向对比,判断迁移的经济可行性。建议建立包含调用量预测、token消耗估算、错误重试成本在内的完整TCO(Total Cost of Ownership)模型,并预留20-30%的容量缓冲应对流量峰值。
-
重点验证中文能力:中文场景下的表现是国产模型的传统优势区,包括中文理解准确度、多轮对话连贯性等,值得优先验证。评估中文能力需重点测试成语理解、文言文处理、方言识别等英文模型薄弱环节。 当前主流评测体系包括C-Eval(中文综合能力评测,由上海交大等机构发布,涵盖52个学科)、CMMLU(中文多任务理解)等专门面向中文的基准。但值得注意的是,基准测试存在「古德哈特定律」风险——当指标本身成为优化目标时,它就不再是一个好的指标。因此,在真实业务数据上的A/B测试始终是最可靠的评估方法。建议构建包含50-100条代表性业务样本的「金标准测试集」,系统化比较不同模型的输出质量。
结语
一条简短的推文,折射出大模型行业从「拼参数」到「拼落地」的深层转向。GLM-5.3 Flash 的出现,既是智谱产品矩阵日趋完善的标志,也是轻量高速模型赛道竞争白热化的缩影。对于身处一线的开发者来说,与其持续观望,不如趁着尝鲜窗口期亲自上手——毕竟,真实业务中的表现,才是检验一款模型价值的唯一标准。
核心要点
- Flash模型定位明确:GLM-5.3 Flash代表智谱在轻量高速模型赛道的布局,通过蒸馏、量化、MoE等技术实现推理延迟降低50-80%、成本下降60-90%的优化目标
- 技术架构创新:GLM系列融合自回归与自编码范式,采用空白填充预训练,在中文NLU任务上比GPT类模型提升8-15个百分点,支持128K长文本与Function Calling
- 成本优化关键:API按token计费,输出token因自回归计算特性定价为输入token的2-3倍;Flash模型通过GQA/MQA技术压缩KV Cache至1/4-1/8,支撑低价策略
- 中文优化策略:针对分词歧义、字符密度、形近字等挑战,国产模型采用70%+中文语料、字-词混合tokenization及MoE架构实现多语言专精
- 评估方法论:建议开发者构建金标准测试集进行A/B测试,重点测量TTFT、TPS、P95/P99延迟等指标,并建立TCO模型核算长期成本,遵循80/20原则分配Flash与旗舰模型调用
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。