GLM 5.3模型登陆Ollama云端:私有化部署新选择

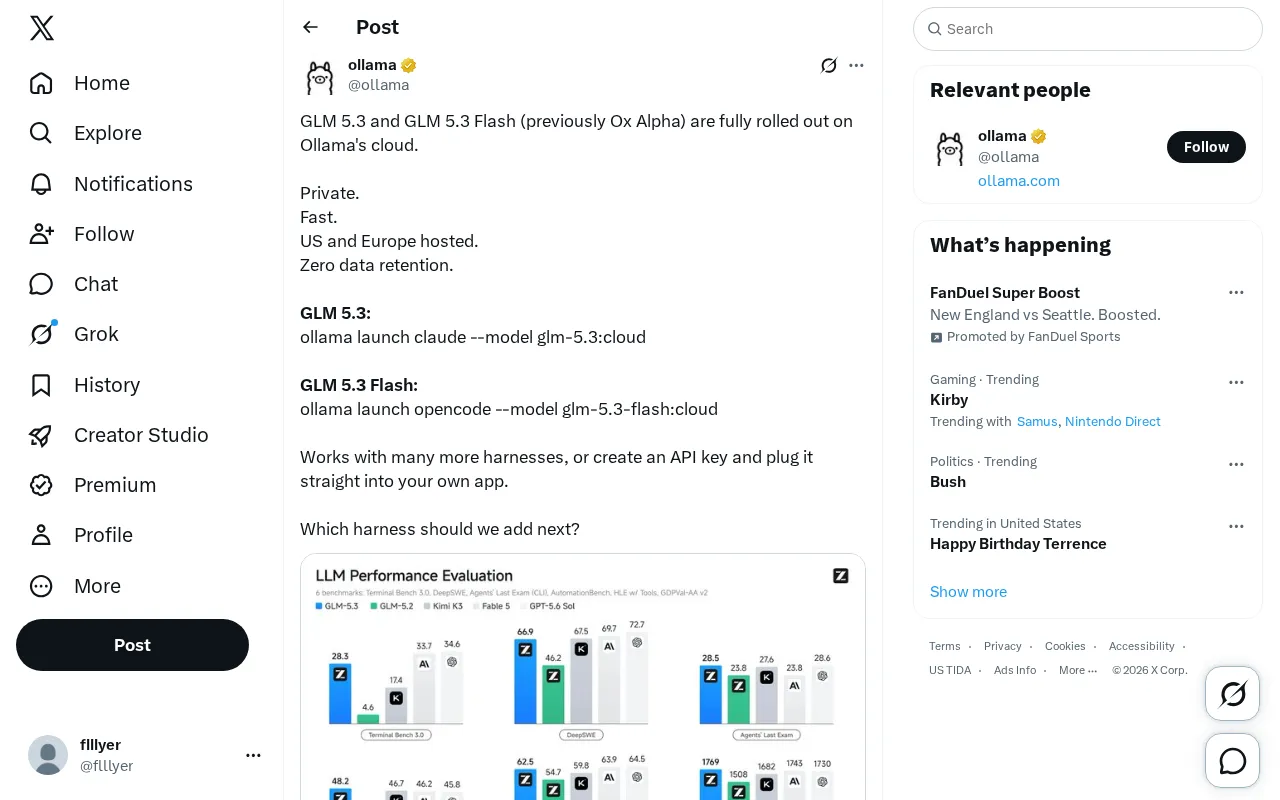
智谱AI旗下的GLM 5.3系列模型已全面部署至Ollama云端平台,为开发者提供了更便捷的私有化部署方案。此次上线包含GLM 5.3和GLM 5.3 Flash两个版本,后者此前代号为Ox Alpha。
智谱AI是中国领先的人工智能公司,由清华大学知识工程实验室孵化,其GLM(General Language Model)系列模型基于自主研发的GLM预训练架构。与GPT系列采用的纯Decoder架构不同,GLM最初采用了自回归填空的训练方式,在理解与生成任务上实现了统一建模。具体而言,GLM的自回归填空(Autoregressive Blank Infilling)训练方式是其区别于主流大模型架构的核心创新。传统的GPT系列采用纯因果解码器(Causal Decoder),只能从左到右单向生成文本;而BERT等模型采用双向编码器,擅长理解但不擅长生成。GLM通过随机遮盖文本中的连续片段,然后以自回归方式生成被遮盖的内容,巧妙地在一个统一框架内兼顾了双向理解和单向生成的能力。这一架构设计最早发表于ACL 2022,后续在GLM-130B等大规模模型上得到了验证。到了GLM-4和GLM 5阶段,智谱AI在保留核心设计理念的基础上不断吸收业界最新进展,包括FlashAttention加速、RoPE位置编码等技术,使模型在保持架构特色的同时具备了与Transformer Decoder-only架构相当的扩展性。GLM系列经历了从ChatGLM到GLM-4再到GLM 5的迭代演进,逐步在中英文双语能力、长上下文处理和工具调用等方面缩小了与国际顶尖模型的差距。
而Ollama则是一个专注于大语言模型本地化和云端部署的开源工具平台,最初以支持用户在个人电脑上一键运行Llama、Mistral等开源模型而闻名。它通过封装模型量化、推理引擎配置等底层复杂操作,将大模型部署简化为类似Docker的命令行体验。Ollama的底层技术栈主要依托llama.cpp推理引擎,该引擎由Georgi Gerganov开发,能够在纯CPU环境下高效运行量化后的大语言模型。Ollama在此基础上封装了模型管理、版本控制和服务化部署等功能,并引入了类似Dockerfile的Modelfile概念,允许用户自定义模型的系统提示词、温度参数和上下文窗口大小等配置。其模型注册中心(Model Registry)类似Docker Hub,开发者可以拉取、推送和共享模型。截至2025年,Ollama已积累了超过百万的月活跃用户,支持的模型格式从最初的GGUF扩展到了SafeTensors等多种格式,成为开源大模型部署领域的事实标准工具之一。Ollama的云端服务是其在本地部署基础上的延伸,允许用户将模型托管在远程服务器上运行,兼顾了本地部署的隐私性与云服务的便捷性。
核心特性与优势
隐私与性能保障
Ollama云端部署的GLM 5.3系列主打三大特性:私密性(Private)、高速响应(Fast)以及零数据留存(Zero data retention)。零数据留存是指服务提供商在处理完用户请求后,不在服务器上保留任何输入输出数据的技术承诺。这一机制通常涉及内存级推理处理、实时数据销毁和审计日志脱敏等技术手段,能有效防止商业机密和用户隐私通过模型服务商泄露。
在工程实现层面,零数据留存远比简单的"用完即删"复杂得多。它通常需要构建端到端的无状态推理管道:用户请求在TLS加密通道中传输到推理节点后,直接在内存中完成Token生成,生成结果通过流式传输返回客户端后立即从内存中清除。为防止操作系统层面的内存交换(Swap)导致数据残留,还需要配置内存锁定(mlock)机制。在日志层面,系统仅记录请求时间戳、Token消耗量等元数据,而对输入输出内容进行完全脱敏或不记录。部分厂商还会引入第三方安全审计和SOC 2合规认证来增强可信度。
这意味着用户的推理请求不会被平台记录或存储,满足企业对数据安全的严格要求。服务器分布在美国和欧洲,可为全球用户提供低延迟访问。
快速部署方案
开发者可通过简单的命令行快速启动模型服务。对于标准版GLM 5.3,使用命令ollama launch claude --model glm-5.3:cloud即可部署;而轻量级的GLM 5.3 Flash则通过ollama launch opencode --model glm-5.3-flash:cloud启动。这种云端部署方式无需本地配置复杂的运行环境——不再需要手动安装CUDA驱动、配置Python依赖或解决GPU显存分配问题——显著降低了使用门槛。
从成本角度来看,云端与本地部署之间存在显著差异。对于GLM 5.3这样参数规模的模型,本地部署通常需要配备多张高端GPU(如NVIDIA A100或H100),仅硬件成本就可能达到数万美元,还需要额外承担电力、散热和运维人员的持续成本。而Ollama云端部署采用按需付费模式,用户只需为实际推理调用付费,无需承担硬件折旧和闲置成本。对于推理量不稳定的中小企业和独立开发者而言,云端方案的经济优势尤为明显。不过,对于日均调用量超过一定阈值的大型企业,自建推理集群的单次推理成本可能更低,因此实际选择需要根据具体业务规模做精细的ROI(投资回报率)计算。
生态集成与扩展性
多框架兼容
GLM 5.3系列已支持与多种AI开发框架(harnesses)集成,开发者可根据自身技术栈选择合适的工具链。AI开发框架是连接大语言模型与实际应用之间的中间层工具,常见的包括LangChain、LlamaIndex、Semantic Kernel、Dify等。这些框架提供了提示词管理、检索增强生成(RAG)、Agent工作流编排、记忆管理等标准化组件,使开发者无需从零构建就能快速搭建基于大模型的应用。模型对多框架的兼容性直接影响其生态渗透力——支持的框架越多,开发者迁移成本越低,模型被采用的概率就越高。Ollama官方正在积极收集社区反馈,计划支持更多主流框架,以扩大模型的应用场景。
API密钥直连
除了预置的集成方案,用户还可以创建API密钥,将GLM 5.3直接接入自有应用程序。这种灵活的接入方式使得企业能够快速将大模型能力整合到现有业务系统中,无论是聊天机器人、代码助手还是内容生成工具,都可以通过统一的API接口调用。对于已有OpenAI兼容API接口的应用,理论上只需修改端点地址和密钥即可无缝切换到GLM 5.3,大幅降低了技术迁移的工作量。
市场意义与展望
GLM 5.3系列登陆Ollama云端,标志着国产大模型在海外基础设施层面的重要突破。Ollama作为开源模型部署领域的知名平台,其云服务为GLM模型触达全球开发者提供了便捷通道。特别是GLM 5.3 Flash版本,以更快的推理速度和更低的成本,有望在实时交互场景中与GPT-4o mini、Claude 3 Haiku等国际主流轻量模型展开竞争。
轻量级大模型是当前AI行业的重要竞争赛道。这些模型通过模型蒸馏、架构优化和推理加速等技术,在大幅降低计算成本和响应延迟的同时,保持了接近全尺寸模型的核心能力。具体而言,轻量级大模型的核心技术路径包括三种主要方法。第一种是知识蒸馏(Knowledge Distillation),即用大模型(教师模型)的输出分布来指导小模型(学生模型)的训练,使小模型能够"继承"大模型的推理能力。第二种是架构优化,包括采用分组查询注意力(GQA)替代传统多头注意力以减少KV缓存开销,以及使用混合专家(MoE)架构在不增加推理计算量的前提下扩大模型参数总量。第三种是推理加速技术,如推测解码(Speculative Decoding)——使用小型草稿模型快速生成候选Token序列,再由主模型并行验证——可在不损失输出质量的情况下将推理速度提升2-3倍。GLM 5.3 Flash很可能综合运用了上述多种技术来实现速度与质量的平衡。
轻量模型特别适合高并发实时交互、移动端部署和成本敏感的企业应用场景,是大模型从技术验证走向大规模商业化的关键环节。GLM 5.3 Flash进入这一赛道,将直接面对OpenAI的GPT-4o mini、Anthropic的Claude 3.5 Haiku以及Google的Gemini Flash系列的挑战。
零数据留存的承诺也契合了当前欧美市场对AI合规性的高要求。随着GDPR等隐私法规的严格执行——GDPR要求数据处理必须遵循最小化原则和目的限制原则,违规企业可能面临全球年营收4%的巨额罚款——这一特性可能成为GLM系列在企业市场的差异化优势。接下来值得关注的是Ollama是否会进一步扩展框架支持,以及GLM 5.3在实际生产环境中的性能表现。
核心要点
核心要点
相关推荐

Antigravity调用Gemini报错真相:IP风控实测与应对
Google Antigravity IDE调用Gemini模型频繁报错?实测发现同一账号仅切换IP即可恢复,且同IP在AI Studio仍可正常使用。本文解析这一基于IP的风控策略、成因推测及排查应对思路。
AI超级员工系统拆解:营销自动化工具的能力与风险
一款宣称"全接管基础岗位"的AI超级员工系统在B站流传,本文拆解其视频生成、数字人克隆、智能体和批量获客等功能,并客观分析其中的合规与安全风险,提醒用户警惕"免费领取"营销套路。
群像才是团体的灵魂:内娱几首氛围感满满的合唱盘点
从07届快男到NINE PERCENT,盘点内娱几首氛围感满满的群像合唱歌曲。相比单人高光与数据热度,一群人并肩同行的情谊才是团体无可替代的灵魂。