公平与可解释并重:强化学习多实例学生预警系统的挑战

融合RL-MIL与公平性约束的学生风险预测框架,基线可行但偏好调节机制因模式崩溃而失效。
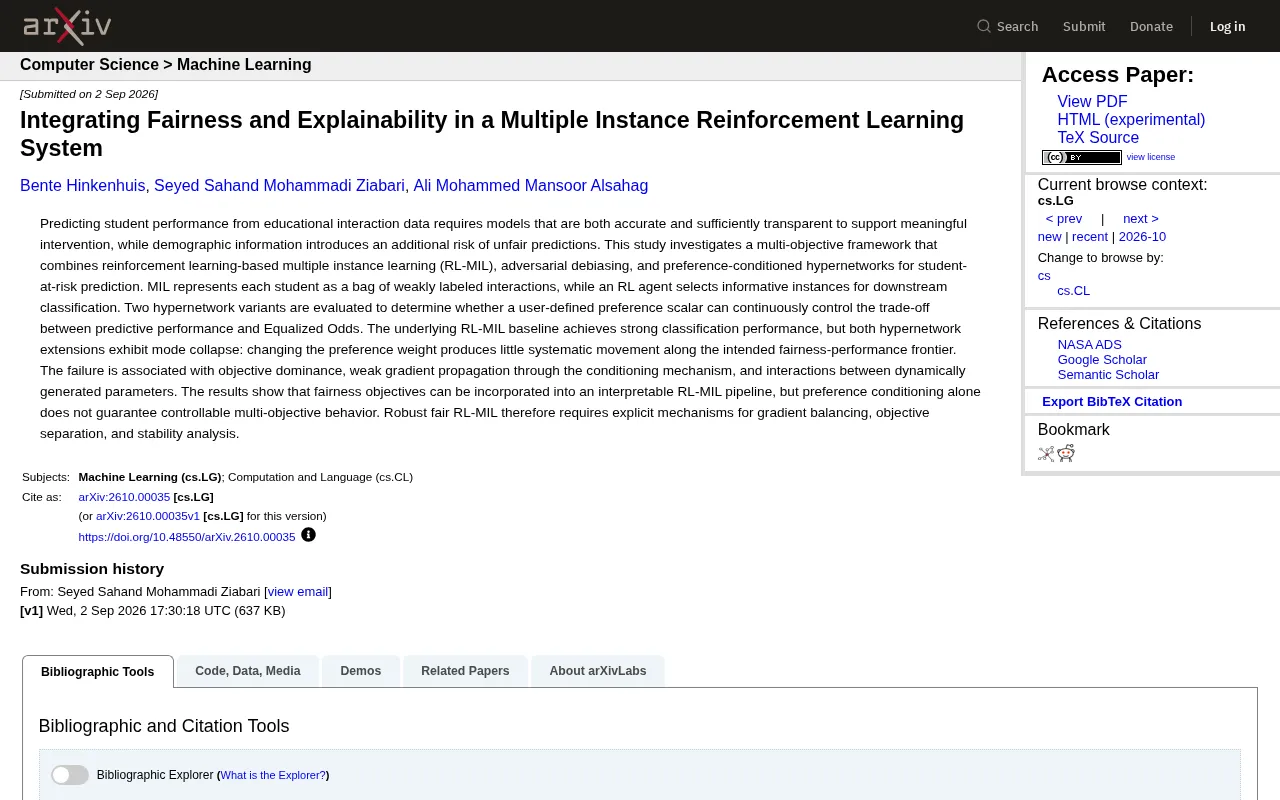
这篇arXiv研究针对教育场景中预测学生学业风险的双重难题——可解释性与公平性——提出了一个多目标框架,融合了基于强化学习的多实例学习(RL-MIL)、对抗去偏与偏好条件超网络三种技术。RL-MIL基线模型取得了强劲的分类性能,证明该可解释管线在实践中可行,公平性目标也能被纳入其中。然而,两种超网络扩展均遭遇模式崩溃:用户调节偏好标量无法有效驱动模型在"公平—性能"帕累托前沿上移动。研究将失败归因于目标支配、梯度传播薄弱与动态生成参数交互三大症结,并指出稳健的公平RL-MIL系统需要引入显式的梯度平衡、目标分离与稳定性分析机制。这份诚实报告负面结果的研究,为教育AI与多目标机器学习领域提供了重要的工程教训。
教育数据分析正在成为AI落地的重要场景之一。一项新发布的arXiv研究(arXiv:2610.00035v1)探讨了一个颇具挑战性的问题:如何在预测学生学业风险时,既保证模型的准确性与可解释性,又能避免因人口统计学信息(如性别、种族)引入的不公平偏差。研究结果既有突破,也揭示了当前多目标优化方法的深层局限。
研究背景:为什么学生预警需要公平与透明
从教育互动数据中预测学生表现,是智慧教育领域的典型任务。但这类预测有两个绕不开的前提:模型必须足够透明,教师或管理者才能据此采取有意义的干预措施;同时,模型一旦接触到人口统计信息,就可能对特定群体产生系统性偏见,从而放大教育资源分配的不公。
换句话说,一个黑箱式的高准确率模型在教育场景中价值有限——如果老师不知道为什么某个学生被标记为"高风险",就无法给出针对性帮助。而如果模型对某个族群存在偏差,则可能加剧而非缓解教育不平等。这正是该研究试图同时解决的两个维度:可解释性与公平性。
技术框架:RL-MIL、对抗去偏与超网络
该研究提出了一个多目标框架,融合了三种技术组件。核心是基于强化学习的多实例学习(RL-MIL)。多实例学习(MIL)将每个学生表示为一个"包"(bag),包内是大量弱标注的交互行为数据,而强化学习智能体负责从中挑选出最具信息量的实例,供下游分类器使用。这种设计天然带来一定可解释性——被选中的实例揭示了模型判断的依据。
为了处理公平性问题,研究引入了对抗去偏(adversarial debiasing),通过对抗训练抑制模型从人口统计特征中学习偏见。
偏好条件超网络的尝试
框架中最具探索性的部分是偏好条件超网络(preference-conditioned hypernetworks)。研究者评估了两种超网络变体,希望通过一个用户自定义的"偏好标量"来连续调节模型在预测性能与**公平性(以Equalized Odds衡量)**之间的权衡。理想情况下,管理者只需调整一个参数,就能在"更准"和"更公平"之间平滑滑动,找到符合特定教育场景需求的平衡点。
多实例学习(Multiple Instance Learning, MIL) 是一种弱监督学习范式,最初用于药物活性预测,近年被广泛引入医学影像、文本分类与行为分析等领域。其核心思想是:训练标签只附着在"包"(bag)这一层级,而非包内的每个"实例"(instance)。对于学生建模而言,一名学生的所有学习行为记录(点击、提交、观看视频等)构成一个包,而每条单独的行为日志是一个实例——我们只知道这名学生最终是否通过课程,并不逐条标注哪些行为是"决定性"的。强化学习在此扮演的角色是训练一个"实例选择器":智能体从包内采样最具代表性的实例子集,这些被选中的实例既用于下游分类,也自然形成人类可读的解释——"模型认为这名学生高风险,是因为其在第三周连续未提交作业"这类解释便由此产生。
超网络(Hypernetwork) 是一种"生成网络权重的网络":一个小型网络(超网络)接收某种条件输入,动态输出另一个主网络的参数,从而让主网络的行为随条件连续变化。在多目标场景中,这一条件输入通常是代表目标权重偏好的标量或向量——理论上,超网络只需训练一次,便可在推理时通过改变偏好输入,即时"生成"出位于帕累托前沿(Pareto front)不同位置的模型参数,无需为每个权衡点分别重训练。Equalized Odds(机会均等) 则是算法公平性中常用的一项度量标准,要求模型对不同人口群体的真阳性率和假阳性率均保持一致,即模型犯错的概率不应因受保护属性(如种族、性别)不同而产生系统性差异。
关键发现:基线表现强劲,但偏好调节失灵
研究得出了一个值得深思的分裂性结论。一方面,底层的RL-MIL基线模型取得了强劲的分类性能,证明这套可解释的管线在预测学生风险上是可行的。公平性目标也确实可以被纳入这个可解释的框架之中。
另一方面,两种超网络扩展都出现了模式崩溃(mode collapse):改变偏好权重几乎无法让模型沿着预期的"公平—性能前沿"产生系统性移动。也就是说,无论用户如何调节那个偏好标量,模型的行为都没有可控地变化——这个本应提供灵活控制的机制实际上失效了。
模式崩溃(Mode Collapse) 这一术语源自生成对抗网络(GAN)训练中的常见病症:生成器陷入只生成少数几种输出的局面,无法覆盖目标分布的多样性。在多目标优化的语境下,该词被借用来描述类似现象:模型无论接收到何种偏好输入,输出行为几乎不发生变化,始终"坍缩"到同一个解附近。这意味着超网络并未真正学习到偏好空间到帕累托前沿的映射,而是忽略了条件输入,退化为一个固定输出的普通网络。这种失效模式在需要细粒度控制的高风险应用中尤为危险——决策者以为自己在调节系统,实际上系统根本没有响应。
失败归因:多目标优化的三大症结
研究对失败原因的分析,对整个多目标机器学习领域都有参考价值。问题主要归结为三点:
- 目标支配(objective dominance):某个目标在优化中压倒性地主导了梯度方向,使得另一目标难以得到体现。
- 梯度传播薄弱:通过条件机制传递的梯度信号过弱,导致偏好标量对模型参数的影响微乎其微。
- 动态生成参数间的交互:超网络动态生成的参数之间存在复杂相互作用,破坏了可控性。
这些发现说明,仅靠"偏好条件化"并不能保证可控的多目标行为。要构建稳健的公平RL-MIL系统,必须引入显式的梯度平衡、目标分离与稳定性分析机制。
梯度平衡(Gradient Balancing) 是应对多目标冲突的一类技术方向,代表性方法包括 PCGrad(将相互冲突的梯度投影到无冲突子空间)和 MGDA(多梯度下降算法,寻找使所有目标同时下降的方向)。目标分离(Objective Decoupling) 则指在架构或训练流程上将不同目标的优化路径显式隔离,避免梯度相互干扰。在对抗去偏框架中,如果分类器的梯度与对抗器的梯度在同一参数空间中强烈竞争,便容易出现文中描述的"目标支配"现象。这些方向已在自然语言处理与计算机视觉领域有所探索,但在结合强化学习的教育场景中仍属空白,本文的负面结果正为后续研究划定了明确的技术难点边界。
对AI公平性研究的启示
这项研究的价值不仅在于提出方法,更在于诚实地报告了负面结果。在当前许多论文倾向于只展示成功案例的背景下,对模式崩溃现象的深入剖析提供了难得的工程教训:多目标优化中那些看似优雅的"一键调节"机制,往往会被底层优化动力学所破坏。
对教育AI实践者而言,这意味着公平性不能作为事后补丁简单接入,而需要在架构设计层面就考虑梯度流与目标间的平衡。可解释性与公平性可以共存于同一框架,但让二者"可控地权衡"仍是一个开放的研究难题。随着AI越来越多地介入涉及个人命运的高风险决策,这类扎实的基础研究显得尤为重要。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。