Google Dreambeans登陆印度:AI生成个人故事支持13种语言

Google实验项目Dreambeans登陆印度,支持13种本地语言生成个人故事。
Google的AI实验项目Dreambeans正在向印度市场扩展,并新增支持13种印度语言,被视为将AI生成个人故事推向大众用户的关键一步。Dreambeans聚焦“个人故事”场景,帮助用户把经历、记忆或想象转化为可阅读的故事文本,降低叙事创作门槛。印度语言高度多元、英语普及率有限,多语言支持使产品得以触达更广泛的非英语用户,符合Google在新兴市场以本地化争取增量用户的一贯策略。文章同时指出,这类产品面临用户隐私保护与内容模板化的双重挑战,而Dreambeans仍属实验性项目,印度多语言落地效果将成为观察AI叙事产品能否走向大众的重要样本。
Google的AI实验项目Dreambeans正在向印度市场扩展,并新增支持13种印度语言。这一举措被视为Google将AI生成个人故事能力推向大众用户的关键一步。
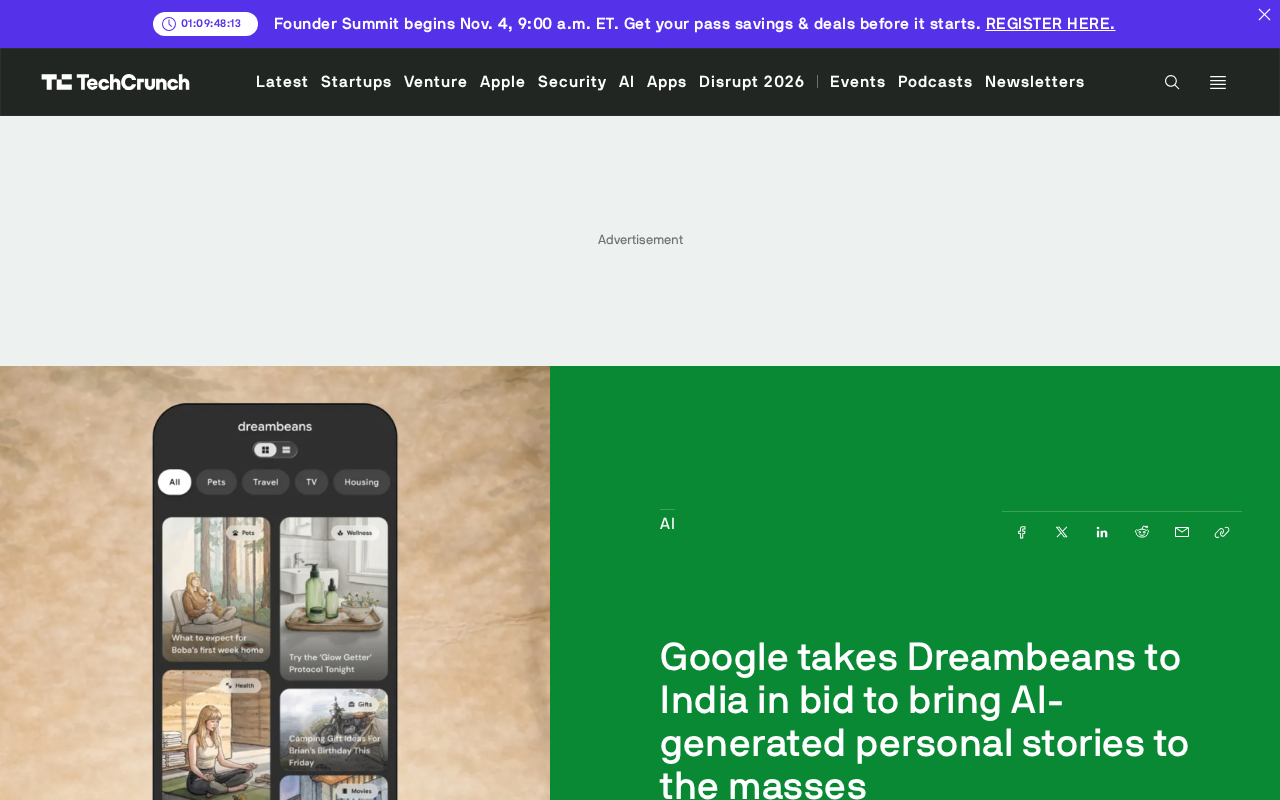
Dreambeans是什么:让AI替你讲述个人故事
Dreambeans是Google旗下最新的AI实验项目,核心能力是生成个人化的故事内容。与通用聊天机器人不同,Dreambeans聚焦于"个人故事"这一细分场景——用户可以借助AI将自己的一段经历、记忆或想象转化为可阅读的故事文本。
这类产品的价值在于降低了叙事创作的门槛。并非每个人都擅长写作,但几乎所有人都拥有值得被讲述的经历。Dreambeans试图用AI填补"有故事"与"会写故事"之间的鸿沟,让普通用户也能获得个性化的叙事体验。
Dreambeans属于Google Labs旗下的实验性产品。Google Labs是Google用来孵化和测试前沿技术产品的内部平台,曾推出NotebookLM、Project IDX、MusicFX等项目。被归入Google Labs意味着产品尚未纳入Google的正式商业化体系,功能、界面与可用范围都可能随实验反馈快速调整,也通常只在有限地区开放。这与“实验项目”的定位密切相关:它既是技术验证,也是一种低风险的市场测试方式——若用户反馈积极,产品可能逐步升级或并入更大的产品线;若效果不佳,则可低成本关停。理解这一归属,有助于判断Dreambeans当前的功能稳定性和长期走向都存在较大不确定性。
印度市场:13种语言背后的本地化逻辑
Dreambeans此次登陆印度,最直接的升级是语言支持扩展至13种印度语言。印度是一个多语言社会,英语普及率有限,大量潜在用户日常使用的是印地语、泰米尔语、泰卢固语等本地语言。如果AI产品只支持英语,实际可触达的用户群会被大幅压缩。
支持13种语言意味着Dreambeans在印度不再是"英语用户的玩具",而具备了面向更广泛人群的基础条件。这也符合Google在印度市场的一贯策略——通过语言本地化争取增量用户,而不是只服务已有的英语互联网人群。
据原始报道,Google将这次扩展定位为"把AI生成的个人故事带给大众"的努力。"大众"一词值得注意:它暗示Dreambeans的目标不是技术尝鲜者,而是普通内容消费者和创作者。
印度宪法承认的官方语言包括印地语和英语,但各邦另有指定官方语言,实际使用的语言超过百种。据印度人口普查数据,以印地语为母语者约占四成多,而使用泰米尔语、泰卢固语、孟加拉语、马拉地语、古吉拉特语、卡纳达语、马拉雅拉姆语等语言的人口各有数千万至上亿规模。与此同时,印度的英语使用者比例仍然有限,且高度集中在城市与受教育程度较高的人群中。这意味着数字产品的语言覆盖直接决定了其潜在用户池的大小。印度政府近年推动的数字公共基础设施与本地语言互联网倡议,也反映出“非英语互联网用户”是下一阶段增长的主要来源,这解释了Google为何把多语言支持作为进入印度市场的首要动作。
AI个人故事生成的机会与边界
从产品形态看,AI生成个人故事有几个天然的落点:家庭记忆的记录与传承、儿童睡前故事、社交分享内容、以及轻量的自我表达。这些场景对"文学性"的要求并不苛刻,更看重情感共鸣和易用性,正好是生成式AI可以稳定发挥的区域。
但这类产品也面临共同的挑战。个人故事涉及大量用户私人信息,数据隐私和内容安全如何保障是绕不开的问题。此外,AI生成的故事容易陷入模板化,如何在规模化生成的同时保留"个人化"的质感,是产品体验能否成立的关键。
Dreambeans目前仍被Google标注为实验性项目,这一定位本身说明产品尚在验证阶段。印度市场的多语言落地效果,将成为观察这类AI叙事产品能否真正走向大众的重要样本。
AI生成个人故事的模板化倾向,根源在于大语言模型依赖训练数据中的统计规律进行生成,倾向于输出结构完整、情节圆融但缺乏独特细节的叙事。要缓解这一问题,常见做法包括:让用户提供更多具体素材(人物、场景、关键细节)作为约束条件,采用多轮交互逐步细化故事,或在生成后提供风格与结局的多样化选项。另一方面,个人故事天然包含姓名、家庭关系、健康、住址等敏感信息,不同司法辖区对个人数据的处理要求差异明显——印度近年通过了数字个人数据保护法,对数据处理者的告知、同意与用途限制提出了要求。产品在跨境处理用户故事素材时,如何在数据最小化、存储期限和用户可控性上做出设计,会直接影响其合规成本与用户信任。
小结
Google Dreambeans进入印度并支持13种本地语言,是一次典型的新兴市场AI本地化尝试。它把"AI生成个人故事"从英语世界的实验品,推向了一个语言高度多元、用户基数庞大的市场。产品最终能否兑现"大众化"的目标,取决于本地化质量、隐私保护与内容个性化三者的平衡。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。