GPT-5.6三款模型实测:So/Terra/Luna性价比全面解析
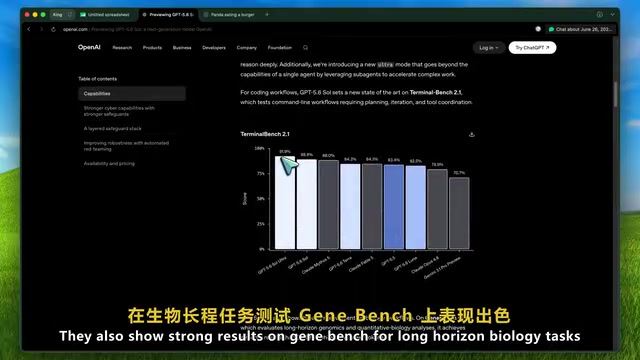
OpenAI发布GPT-5.6系列:三档定位一次到位
OpenAI正式发布了GPT-5.6系列预览版,一次性推出三款定位清晰的模型。据拿到早期内测权限的测评博主分享,三款模型分别是:旗舰款So、主打日常办公的均衡型Terra,以及极速低价的Luna。
值得关注的是,OpenAI这次采用了全新命名逻辑——数字代表模型代际,So、Terra、Luna则是固定的「能力等级」标签,未来将各自独立迭代,也就是说这三个名字会长期沿用,而非一次性的营销噱头。
目前这批模型仅通过API提供有限预览权限,并向少数合作伙伴开放了Codex接入,官方预计几周内全面开放。
一个耐人寻味的细节:分阶段发布
据博主透露,模型正式发布前,OpenAI曾率先向美国政府展示其能力,并应政府要求采取「分阶段发布」策略——这在OpenAI历史上尚属首次。
这一做法折射出当前AI治理领域的深层博弈。自2023年以来,美国行政部门通过一系列行政令要求前沿AI模型在发布前向联邦机构(如NIST、NSA)进行安全汇报,尤其关注模型在网络攻击辅助、生物武器设计等「双用途」风险上的能力边界。OpenAI此前已在其《准备框架》(Preparedness Framework)中承诺对高风险能力实施额外的安全评估与发布管控。此次分阶段发布,既是履行监管承诺的表态,也为网络安全领域的能力描述增添了可信背书——毕竟政府关注的往往是最具颠覆性的能力维度。
基准测试:后端与智能体任务成为最大亮点
本次测评使用了一套自编测试集,涵盖前端开发(React、SVG生成)、数学难题,以及一项高难度长程智能体任务——要求模型自主生成数据集、在本地微调模型并独立构建Web UI。
各模型综合得分如下:
- So:55分(约78.6%)
- Terra:44分(约62.9%)
- Luna:31分(约44.3%)
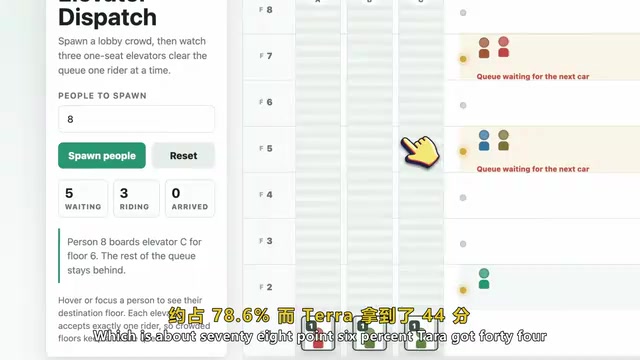
单看总分,So表现看似平平,但拆解细分数据后,真正的看点才浮出水面。
长程智能体任务:三款模型全部满分
在最考验综合能力的智能体微调任务中,GPT-5.6三款模型全部拿到10分满分。即便是最低价的Luna,也能独立完成数据集生成与Web UI微调的完整流程,得分与顶级模型Fable 5持平。
值得在此说明长程智能体任务的技术门槛。长程智能体(Long-horizon Agent)任务与单轮问答有着本质区别:模型需要在多步骤、跨工具、跨时间窗口的环境中维持一致的目标追踪与状态管理。它不仅要理解初始指令,还要自主规划子任务序列、调用外部工具(如代码执行器、文件系统、Web UI框架),并在中间步骤出错时进行自我纠错。这类任务对模型的「持久记忆」、「工具调用稳定性」和「错误恢复能力」提出了极高要求——这也正是为何GPT-5.5及Opus 4.7在同一任务上的得分通常仅有2到3分。GPT-5.6在这一维度上的集体满分,意味着长程后端代理任务实现了质的飞跃。
短板依旧:前端与视觉任务
模型的明显短板集中在前端与视觉任务上。在React折叠动画、SVG生成等案例中,So仅得6到7分,而Fable 5能拿到9甚至10分。
由于本次测试集本身偏重前端与视觉方向,这类任务的失分对GPT-5.6总分影响较大。正如评测博主所说:「前端开发依然不是OpenAI的强项。」这也提醒我们,单一总分并不能完整反映模型的真实定位。
价格策略:性价比才是真正的杀手锏
如果说能力提升是常规操作,那么这次的定价才是最具攻击性的部分。三款模型定价(每百万Token)如下:
| 模型 | 输入价格 | 输出价格 |
|---|---|---|
| So | $5 | $30 |
| Terra | $2.5 | $15 |
| Luna | $1 | $6 |
官方表示,Terra在对标GPT-5.5性能的同时,价格砍去了一半。此外,模型通过缓存断点优化了提示词缓存机制,并提供至少30分钟的缓存有效期。
提示词缓存(Prompt Caching)是大模型API服务中的一项重要成本优化技术。其核心原理是:当用户在多次API调用中使用相同的前缀提示词(如系统提示、长文档上下文)时,服务端可将该前缀的KV Cache(键值缓存)保留在显存中,后续请求直接复用,无需重新计算,从而大幅降低延迟与计算成本。GPT-5.6通过「缓存断点」机制进一步精细化了缓存控制——开发者可以显式标记缓存边界,30分钟有效期的设计则在保证命中率的同时控制了显存占用。这对于需要频繁调用且上下文较长的智能体应用(如代码助手、客服系统)具有显著的实际价值。
So还将在Cerebras平台上线,推理速度可达每秒约750个Token。Cerebras是硅谷一家专注于AI推理加速的芯片公司,其旗舰WSE(Wafer Scale Engine)是目前世界上最大的单片芯片。与英伟达GPU以并行计算见长不同,Cerebras架构尤其擅长减少内存带宽瓶颈——这正是大模型自回归逐Token解码的核心性能瓶颈。每秒750个Token大约是传统GPU集群的3-5倍,意味着在对话延迟敏感的场景(如实时编码辅助、交互式智能体)中,用户体验将有质的提升。从成本与速度双维度来看,这套组合颇具市场竞争力。
新增能力:Ultra模式与最大推理强度
GPT-5.6还新增了「最大推理强度」功能,以及全新的「Ultra模式」——支持多个智能体协同处理复杂任务。
Ultra模式代表了当前AI应用的一个重要范式演进方向——多智能体系统(Multi-Agent Systems)。在传统单模型调用中,所有任务由同一个模型上下文串行处理;而多智能体架构允许将复杂任务分解为多个子任务,由不同的「专家智能体」并行或协作处理,最终由一个协调者(Orchestrator)整合结果。这种架构的优势在于:可以突破单次上下文长度限制、实现任务并行化加速、以及通过专业化分工提升各环节质量。GPT-5.6三款模型在长程智能体任务上的集体满分,很可能正是受益于Ultra模式带来的任务分解与协同能力的系统性提升。
横向对比:逼近Fable,但尚未登顶
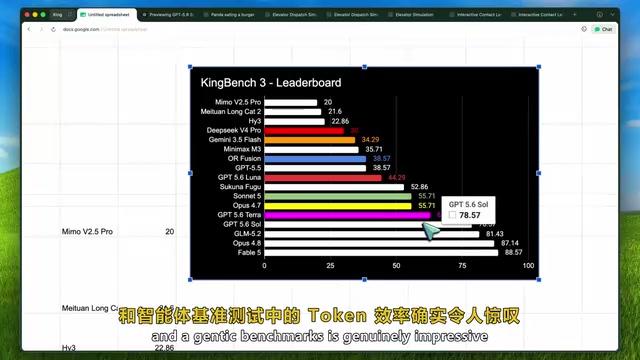
综合评测排行榜得分如下:
- Fable 5:88.57%(榜首)
- Opus 4.8:87.14%
- GM 5.2:81.43%
- So(GPT-5.6):78.57%
关键对比在于:GPT-5.5此前约为87.4%,So看似退步,但评测博主指出这主要源于测试集偏重前端。若按实际能力提升幅度来看,So相较上一代几乎实现了倍增式进步。
选型建议:三种场景三种答案
第一,这是迭代而非范式转移。 GPT-5.6本质上仍是GPT-5.5的常规升级。So、Terra、Luna的命名带有明显的营销考量——这或许是OpenAI在Anthropic将Fable定位为「新一代模型类别」后,希望让自家发布更具新鲜感的策略。
第二,还没追上Fable。 综合来看,Fable依然是目前最强的模型,在几乎所有类别保持领先。但So已非常接近,在网络安全、智能体基准的Token效率上表现惊艳,分析任务上与Fable完全持平。Fable的主要软肋是成本——它是市面上最昂贵的选择之一。
第三,基于场景的选型建议:
- 前端或视觉繁重任务:Fable或Opus 4.8仍是首选。
- 后端代理或长程任务:So是性价比极高的选择。
- 极致成本的代理场景:Luna凭借超低输入成本($1/百万Token),可能是目前最具性价比的代理模型。
结语:一次务实且激进的价格战
综合实测与分析,GPT-5.6虽然算不上「彻底颠覆」式的范式革命,但确实是一次强劲且性价比极高的迭代升级。它大幅缩小了与Fable的差距,尤其在后端代理与长程智能体任务上的表现堪称惊艳。
对开发者而言,真正值得关注的或许不是它能否登顶排行榜,而是OpenAI这次以「能力接近顶级、价格砍半」的策略,将整个API市场的定价基准又拉低了一个档次。当预览版正式转正后,这场性价比之战恐怕才刚刚开始。
注:本文基于单一测评来源整理,模型名称与部分数据可能因预览版调整或口播误差存在偏差,正式版发布前一切以官方为准。
相关推荐

Anthropic递交S-1:半年营收163亿、净亏807亿,谁在控制公司?
Anthropic递交S-1申请纳斯达克上市:2026上半年营收163亿美元、净亏损807亿美元源于估值重估而非现金流出,创始人持Class F股份掌握50.1%投票权,发行价与日期尚未公布。

Anthropic递交S-1:163亿营收与807亿亏损背后的真相
Anthropic S-1文件披露2026上半年163亿美元营收与807亿美元净亏损,其中724亿为会计效应。文件同时揭示2656亿美元算力承诺、云协议细节及创始人50.1%投票权控制结构,IPO定价仍留白。

Anthropic财务数据曝光:营收远超算力成本,Claude推理毛利率达68%
Anthropic泄露财务数据显示,其营收约为总算力成本两倍,Claude推理毛利率达68%,而前沿训练单季烧掉28亿美元。本文拆解推理与训练两笔账,分析AI公司估值逻辑的变化与数据的审慎解读。