GPT-6.1 Sol深度实测:OpenAI用超低价反击Opus 5.5
GPT-6.1 Sol以激进低价在基准测试中比肩顶级模型,但前端设计与长任务自主性仍是明显短板。
OpenAI在Anthropic发布Opus 5.5后一周内推出GPT-6.1 Sol,被认为是针对性的临时反击之作。该模型最大杀招并非能力本身,而是激进定价:每百万输入token仅2美元,缓存读取折扣高达95%——在Agent工作负载中96%为缓存读取的背景下,实际成本大幅低于账面价格。基准测试中,它以十分之一时间、七十分之一价格达到与Opus 5.5相当的分数。真实任务中,它改善了前代Astra"又聪明又犯蠢"的毛病,代码审查能力出色,但在前端设计和长时间无人值守重写任务上仍有明显短板。博主的最终建议是以Opus 5.5写代码、6.1 Sol做审查的协同模式使用,并指出此次激进定价可能标志AI模型补贴时代开始走向终结。
OpenAI的快速反击
Anthropic发布Opus 5.5引发业界震动后,OpenAI在短短一周内接连推出多款模型。前两款GPT-6 Sol和GPT-6 Luna反响平平,但真正的重头戏是紧随其后发布的GPT-6.1 Sol。
据获得早期访问权限的YouTube博主实测,GPT-6.1 Sol在GPT-6 Sol发布仅一周后就上线,这种异常紧凑的发布节奏本身就传递出一个信号:这款模型很可能原本不叫6.1,而是OpenAI为应对Opus 5.5的"内部红色警报"而临时调整的产物。
从技术迹象看,6.1相比GPT-6 Sol"显著更聪明",且每秒生成token速度明显变慢——后者通常意味着模型体量更大。这些都表明6.1并非简单的小版本号升级,而是存在根本性差异。
价格才是真正的杀招
这款模型最震撼的地方不在能力,而在定价策略。GPT-6.1 Sol的价格为每百万输入token 2美元、输出10美元,仅为Astra的五分之一。
但真正的核武器是缓存读取(cache read)定价。OpenAI一直将缓存读取价格固定在正常读取价格的10%(即90%折扣),而这次直接降到每百万token 10美分,相当于95%折扣——缓存成本直接砍半。
这一点至关重要,因为博主引用Opus自己的分析指出:真实的Agent工作负载中96%都是缓存读取。换句话说,缓存价格比2美元和10美元的"头条价格"重要得多。在实际测试中,当博主让Opus 5.5评估自己所有会话的成本时,基于旧估算是5700美元,而按新价格重算后仅为1550美元,降幅巨大。
博主据此推断,OpenAI历史上高达95%的利润率(花10美元成本仅5毛)正在被压缩,这可能标志着"补贴时代"开始走向终结。同时有消息称Pro $200订阅回归,但用量计算方式改变,实际净值约为旧版的一半API消费额。
**缓存读取(Cache Read)**是大模型API定价体系中的关键机制。当同一段上下文(如系统提示、长文档或代码库)被反复发送给模型时,提供商可以将其存储在高速缓存中,后续请求直接读取缓存而无需重新处理,从而大幅降低计算开销。对于Agent工作流而言,每一步操作往往需要携带完整的任务上下文和历史记录,这意味着每次API调用中绝大部分token实际上是重复的缓存内容。正因如此,缓存读取价格对于真实Agent场景的总成本影响远超"头条输入/输出单价"——96%的缓存读取占比意味着,缓存折扣从90%提升至95%,实际上将这部分成本再砍一半,最终账单降幅可能比单看标价变化直观感受到的大得多。
基准测试:同分但便宜一个数量级
在Terminal Bench 4上,GPT-6.1 Sol拿下了博主见过的最高分之一,即便在High和X High档位也超越了此前所有模型。
更夸张的是成本对比。在Deep SWE基准上,6.1 Sol在Low档位花费0.21美元就达到了Astra在Low档位1.46美元、Opus 5.5在Max档位14.65美元才能达到的同等分数。博主完成整个基准仅用4.8分钟、21美分,而Opus 5.5在Max档位每个任务耗时50分钟——十分之一的时间、七十分之一的价格,换来同样的分数。
博主也坦言自己"比以往任何时候都更怀疑基准测试",尤其是在自己动手跑了大量测试之后。这些数据虽然亮眼,但不代表真实的日常代码工作表现。
Terminal Bench和Deep SWE是目前常用的代码能力评测基准。Terminal Bench考察模型在终端环境中完成真实工程任务的能力,包括调试、文件操作和命令行交互;Deep SWE(Software Engineering)则聚焦于更接近实际软件开发的任务,如代码修改、缺陷修复和仓库级别的理解。这类基准相比传统的数学或问答测试更贴近工程实践,但也更容易因测试集泄露或模型针对性优化而出现"基准失真"——即模型在评测中表现亮眼,却未必反映日常开发中的真实稳定性。博主对此保持警惕,其判断最终仍以实际任务中的表现为主要依据。
真实工作中的表现:告别"又聪明又犯蠢"
GPT-6 Astra最让人头疼的不是不够聪明,而是"又聪明又犯蠢"——它会毫无征兆地突然犯下低级错误,这种"spikiness"(尖刺性波动)严重到让博主几乎放弃使用。
GPT-6.1 Sol在这方面有明显改善。博主甚至放心让它遍历所有邮件、找出遗漏的账单、在Chrome里为每笔投资开好标签并填写电汇信息,"没有一个地方出错",还主动指出了他自己会漏掉的事项。他直言:"我真的信任这个模型去电汇转账。"其他测试者Julius称其"难以置信",Ben则评价"无聊得难以置信"——对这类模型发布而言,这恰恰是最好的状态。
在代码审查方面,6.1 Sol延续了OpenAI模型的"罗威纳犬本性"——会死咬住问题不放,挖出每一个缺陷。在Orchestrator V2审计中,它表现与Astra几乎相同,但成本仅297美元对584美元。在T3代码改进任务中,它以87.4分击败了Astra(83.8)和Grok 4.7(80.7),而成本仅2.15美元,比Sonnet的近9美元和Opus的5美元都低。
短板依然明显:前端与长任务
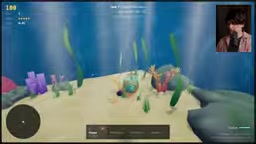
在"Fish Slop"游戏生成测试中,6.1 Sol暴露了严重问题。虽然3D图形保真度很高(鱼、潜艇、螺旋桨模型都更出色),但它在游戏周围堆砌了"绝对垃圾的UI",到处是毫无必要的文案("休息一下""你的小世界可以等等"等二十多条)。博主毫不客气地表示:这个模型在前端和设计上烂透了,没有任何审美,想做不烂的前端请把钱花在别处。
游戏操作手感也明显不如Opus和Sonnet版本,移动卡顿、帧率更低。不过它在Blender建模上表现出色——给个截图让它用CLI建3D模型,完成度相当高。
另一大短板是长时间无人值守的重写任务。博主的TypeScript到Rust移植项目,用Astra和Sol折腾了数月、烧掉数十万token的token仍毫无进展;而Opus 5.5仅用两个订阅、一晚上、约一千美元就从头重写搞定。6.1 Sol在这类任务上会"固执地遵守流程规则,即便进度完全停滞也不求助"。
博主提到的TypeScript到Rust移植任务代表了一类特殊的AI编程挑战:大规模无人值守重写(Unattended Rewrite)。与逐步交互式编码不同,此类任务要求模型在没有人工干预的情况下,自主规划、执行并在遇到阻碍时灵活调整策略,可能持续数小时甚至更长。这对模型的"元认知"能力要求极高——它需要感知自身是否陷入死循环、何时应主动中止并寻求帮助。GPT-6.1 Sol在此类任务中"固执地遵守流程规则"的表现,揭示了当前模型在自主性与适应性之间的普遍权衡难题:规则遵从度高的模型往往稳定可预期,但面对非标准情况时缺乏跳出框架的灵活性。
最佳用法:与Opus协同作战
博主的结论是:6.1 Sol可以作为默认编码模型,但他仍更愿意用Opus 5.5做日常主力。
他找到的最优组合是让两者协同:Opus 5.5负责实际写代码(更好的协作者、不会频繁卡住),6.1 Sol负责审查、深挖细节、根因排查和代码库分析。有个典型案例:Opus重写TS-Rust移植后,6.1 Sol审查发现180万行代码中有130万行根本没被使用——因为Opus判定其他Agent的代码是垃圾、从头重写却没清理旧代码。于是6.1 Sol又被派去收拾这些残局。
对于不再需要Sonnet,博主态度明确:6.1 Sol将有效取代它的位置。他会调整Claude配置,让Opus在合适时机调用6.1 Sol来审查工作和调查代码库。
这是一次"了不起的发布",以极具竞争力的价格提供了强大能力。但它没能把Opus 5.5拉下日常主力的宝座,博主也不打算取消任何Claude订阅。更深远的影响是:这次激进定价可能真的拉开了AI模型"补贴时代终结"的序幕。
相关推荐

零基础用Claude Code搭建AI Agent:从工作区到云端自治
无需编程,用Claude Code桌面应用四步搭建AI Agent:从工作区配置、Agent Designer生成第一个智能体,到Skill固定流程、Memory自我进化,最终部署云端定时自治运行。

无需Python基础:Cursor AI编程如何重塑自动化测试与测试开发
测试工程师不学Python也能做自动化测试?本文梳理Cursor等AI编程工具如何赋能功能测试、自动化脚本、测试平台开发与性能调优,并对比国内外主流工具的成本与访问限制,给出测试人员的能力转型建议。

近5000人中招!AI编程插件被植入后门,官方紧急下架
Claude Code的VS Code扩展2.1.313版本被恶意篡改,植入后门可远程登录并持久化控制,最多5000名用户或受影响。官方已下架恶意版本,本文详解攻击手法与清理步骤。