GPT-6.1 Sol实测:价格打平Sonnet 5.5,3D能力却逊色一筹

GPT-6.1 Sol以Sonnet同等价格发布,细节任务惊艳但3D生成整体落后于Claude Sonnet 5.5。
OpenAI发布的GPT-6.1 Sol与Claude Sonnet 5.5定价完全一致(输入2美元/输出10美元每百万token),主打"接近顶级智能、价格更低"。科技博主Bijan Bowen围绕3D生成与游戏构建任务进行实测,结论呈现明显的两面性:在泳池派对、GTA克隆等视觉生成任务上,效果明显不如Sonnet 5.5,被形容为"没有可比性"的差距;但在《宋飞传》公寓复刻、RuneScape 2007 UI还原、滑板trick回放等细节精度任务上,表现则相当惊艳。模型token效率高、高强度测试仅消耗3%用量,性价比突出。整体而言,GPT-6.1 Sol更像是一个擅长细节与软件底层任务的专才,而非3D视觉生成领域的全能选手。
OpenAI在开发者日之后迅速推出了GPT-6.1 Sol,这款模型最大的卖点是以更低价格逼近顶级智能水平。科技博主Bijan Bowen第一时间进行了实测,重点围绕他频道常做的3D生成、游戏构建和建模任务展开。结论耐人寻味:模型本身相当能打,但偏偏撞上了24小时前刚发布、同价位的Claude Sonnet 5.5,对比之下显得有些尴尬。
定价与规格:直接对标Sonnet 5.5
这次发布的核心信息是,OpenAI宣称GPT-6.1 Sol已经接近Astra级别的智能(Astra是当前最强的OpenAI模型),但价格只有其五分之一。具体定价为输入每百万token 2美元、输出每百万token 10美元——这与前一天发布的Claude Sonnet 5.5完全一致。
从规格看,模型知识截止到2026年4月30日,拥有略超100万token的上下文窗口,最大输出128k token,输入模态支持文本和图像。在DeepSWE基准上,它相比前代GPT-6 Sol仅0.1的版本号提升却带来了相当可观的能力进步。
博主特别指出一个现象:模型在更高推理强度(如max、ultra)下并不总是产出更高效的结果,有时基准分数下降反而是因为模型做了超出评测范围的事情。基于这点,他大部分测试选择在max effort下运行,以探底模型的最大能力。
值得关注的是定价带来的定位变化。在过去GPT-5.6和Sonnet 5的时代,Sol更接近Opus级别的竞争者;而如今Sol与Sonnet同价,意味着它从Opus对手降维成了Sonnet对手,这一点直接影响了后续所有测试的评判基调。
DeepSWE是一个专门评估大语言模型软件工程能力的基准测试,全称为Deep Software Engineering Benchmark,主要考察模型在真实代码库中完成任务的能力,包括Bug修复、功能实现和代码重构等场景。与SWE-bench等传统编程基准相比,DeepSWE更侧重长上下文、多文件协作和工程判断力,因此被视为衡量模型"实战编程"水平的重要参考。文章中提到GPT-6.1 Sol在该基准上相比前代有可观进步,意味着它在处理复杂软件任务时的能力提升幅度超过了版本号所暗示的增量。
游戏与3D生成:竞争力明显落后Sonnet
测试的重头戏是几款自制游戏生成任务。首先是全新的"后院泳池派对"测试(Backyard Pool Party),这是前一天Sonnet视频中新引入的,目的就是避免模型"刷榜"已知测试。博主清空了系统上所有缓存和暂存文件夹,确保没有任何先前结果残留。
结果让他略显失望:无论是在ultra+fast模式还是重做的纯max模式下,生成效果都与前代几乎一模一样,视觉表现明显不如Sonnet 5.5——尤其是角色建模。博主直言"这没有可比性,Sonnet是把地板拖得干干净净那种碾压"。唯一的优势是GPT-6.1 Sol速度快得多,且是在最高推理强度下完成的。
GTA克隆游戏、Orbital Run、Halo风格的桌面OS等测试结果则被评价为"能力合格但没有惊艳"。有意思的是,多个来自不同厂商的模型都收敛出了类似行为,比如把邮件应用与游戏功能联动,这种跨模型的趋同现象本身就很值得玩味。
机械臂抓取测试中出现了一个有趣结果:模型运行约18分钟后主动放弃了任务,机械臂停在垂直位置并给出"我做不到"的信息。博主对此反而给予尊重——Sonnet 5.5虽然完成了任务,但过程"破坏性极强、基本靠运气",而GPT-6.1 Sol的动作明显更细腻克制,知道何时该停手。
文中提到的"ultra+fast"与"max effort"是OpenAI模型推理强度(reasoning effort)的不同档位设置。OpenAI在推出o系列及后续推理模型时引入了可调节的推理强度机制:强度越高,模型在生成答案前投入的内部"思考步骤"越多,通常能处理更复杂的逻辑问题,但同时消耗更多token、响应更慢。"fast"模式则相反,优先速度和效率,适合对延迟敏感的场景。博主选择在max effort下测试,目的是排除推理强度不足导致的能力低估,确保看到模型的真实上限——这也解释了为何同一任务会产生截然不同的输出质量和运行时长。
转折点:细节精度惊艳的几个结果
尽管整体偏弱,几个测试还是展现了模型的闪光点。C++滑板游戏(早期2000年代纽约街区、禁用raylib)在加入了评论区建议的"回放功能"后表现不俗:按Z键触发的电影级trick回放被博主称赞为"X Games专业模式",水面效果和建筑倒影相当精致。
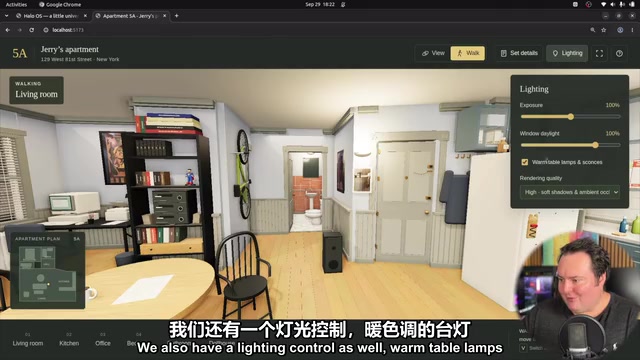
最令人印象深刻的是《宋飞传》Jerry公寓复刻测试。博主评价为"绝对出色、相比以往是巨大飞跃"。门上的多重锁、电脑屏幕上的文字彩蛋("飞机花生到底怎么回事""周四新素材")、绿色Klein自行车的链条细节、卧室的保时捷海报,甚至引用了参考来源——单从场景搭建的个体细节看极其用心。不过它仍未能百分百还原剧中真实的空间布局,这是所有模型至今都没攻克的难点。
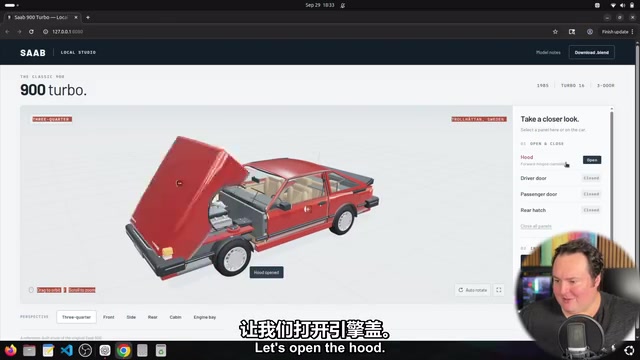
RuneScape 2007 PVP复刻同样亮眼,UI元素(鲨鱼、药水图标、物品栏)"像素级完美"到让博主怀疑模型直接从某处裁剪了素材。Saab 900 Turbo的3D建模测试则体现了模型在处理非常规车型(这类车形状古怪、难以套用标准跑车模板)时的能力:引擎舱细节、减震塔、电池、轮毂都有相当还原度,还支持开启引擎盖交互和换色。
《宋飞传》(Seinfeld)公寓复刻是AI生成测试中的一个经典挑战场景。该公寓因在剧中出现频次极高、陈设细节有大量粉丝记录,成为测试模型"长尾知识记忆与空间推理"双重能力的理想用例。难点在于:模型需要同时记住大量散落于多集剧情中的道具细节(如Klein自行车、保时捷海报、门上多重锁),又要在3D空间中正确还原它们的相对位置关系——前者考验知识广度,后者考验空间布局理解。目前没有任何模型能完美还原剧中真实平面格局,说明即便记忆层面表现出色,"知识到空间"的映射仍是现阶段模型的普遍瓶颈。
效率与定位:便宜、省额度,但方向感迷失
整轮高强度测试(含多个ultra模式任务)只消耗了约3%的用量(从98%降到95%),博主认为这款模型在token效率上表现相当respectable。考虑到相对低廉的价格,性价比是实打实的优势。
博主在视频中罕见地坦承了测试困境:他的频道以3D和游戏生成为主,而这恰恰可能不是GPT-6.1 Sol的强项。他推测模型可能在更底层的软件能力、边缘设备优化等未被探索的领域有优势,并尝试用一台老旧的Pentium III笔记本做物理设备交互测试,但因USB-to-USB无法建连、模型被降级等原因未能成功。
他的结论保持克制:不愿仅凭视觉3D任务就给模型下定论。但在Sonnet 5.5刚刚"令人叹为观止"的衬托下,同价位的GPT-6.1 Sol在视觉表现上确实没那么惊艳。"它很能打、不怎么耗额度、价格也相对便宜"——这是博主留下的最终评价,同时也暗示这款模型的真正价值可能藏在游戏之外的软件任务里。
相关推荐

奥特曼称本地部署不如数据中心,开源AI路线之争再起
奥特曼称开源大模型本地部署不如数据中心集中运算,B站UP主瓜熟迪落拉拆解这一表态背后的技术路线之争与中美AI业态差异,讨论本地部署是否真的该被放弃。

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。