GPT-6.1 Terra实测:低价模型能否当日常主力?

GPT-6.1 Terra 主打低价快速,日常够用但电脑操作受网络拖累。
文章基于 B 站 UP 主的实测视频,介绍 OpenAI 新模型 GPT-6.1 Terra 的定位与表现。它主打低价与快速响应,API 价格约为上一版 Terra 的一半,与 GPT-5.6 Luna 同处较低价位档,额度消耗更友好,建议日常任务从旧的 5.6 Terra 切换过来。开放范围覆盖 Pro/Plus 订阅用户,并同步上线 ChatGPT Worker 与 Codex;免费用户仅有三个模型可选。能力方面,开发日常任务可胜任,前端页面美观性较 5.6 系列明显提升;但电脑操作测试出现断连,主要归因于代理网络延迟和 Windows 版 Codex APP 的负优化。选型建议是按任务匹配:日常先用 6.1 Terra,复杂任务再升级到 6.1 Luna 或 GPT-6 Extra。
OpenAI 新模型 GPT-6.1 Terra 发布,主打低价与快速响应,定位是能以更低成本提供足够强的日常能力。B站 UP 主在第一时间做了实测,并重点拆解了定价逻辑和模型选择策略。这篇文章整合视频内容,帮你判断它是否值得成为你的日常主力模型。
定价逻辑:为什么你的额度总是不够用
很多人抱怨 Plus 额度不够,原因往往不是用量大,而是选错了模型档位。UP 主在视频里列出了一张 API 价格比例表,指出不同模型的消耗差异显著。
- 最高一档是 GPT-6 Extra,价格最高;
- 其次是 GPT-5.6 Terra,价格处于较高水平;
- GPT-6.1 Terra 和 GPT-5.6 Luna 处于同一较低价位档;
- GPT-6.1 Terra 的价格进一步下探,约为上一版 Terra 的一半。
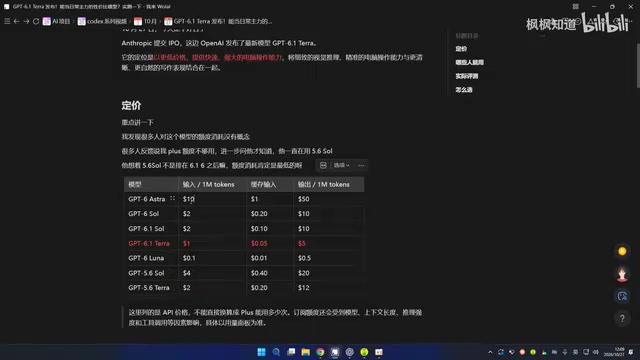
这里展示的只是 API 价格,不能直接等同于订阅额度消耗,但比例关系有参考价值。UP 主特别提醒:不要再用旧的 5.6 Terra 做日常任务,有条件的优先切换到 6.1 Terra 或 Luna,额度消耗会友好很多。
文中反复提到的"额度消耗"与 API 价格有关但并非同一概念。ChatGPT 订阅(Plus/Pro)的用量限制通常以消息条数或计算量配额的形式体现,不同模型在后台被赋予不同的"权重":调用更强的模型会按更高倍率扣减配额,而轻量模型倍率较低。因此 API 每百万 token 的定价比例,可以粗略反映订阅侧各模型的消耗倍率,但两者并不严格等价,实际额度还受上下文长度、推理模式、是否启用工具等因素影响。这也解释了为什么选错模型会让人感觉额度"莫名不够用"——同样的对话轮次,用高倍率模型可能数倍于低倍率模型的消耗。
谁可以用 GPT-6.1 Terra
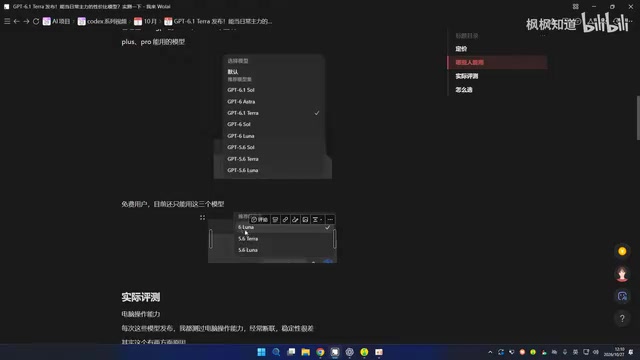
GPT-6.1 Terra 的开放范围覆盖 ChatGPT 订阅用户,包括 Pro 和 Plus 套餐。此外,它在 ChatGPT Worker 和 Codex 中同步上线,开发者可以直接在编码环境里调用。
免费用户目前只能用三个模型:6.1 Luna、5.6 Terra 和 5.6 Luna。如果你发现自己的模型列表只有这三个,那基本可以确认套餐到期了。
文中提到的 Codex 与 ChatGPT Worker 属于不同的产品形态。Codex 是面向开发者的编码代理环境,可在本地或云端读取代码库、执行命令并提交改动,模型在其中承担规划与写码的角色;ChatGPT Worker 则更偏向任务型/代理型工作流,让模型在后台连续执行多步骤操作。二者与网页版 ChatGPT 共用同一套模型家族,但调用方式、上下文窗口和工具权限不同,因此同一模型在不同入口的实际表现可能存在差异。对开发者而言,这意味着可以在熟悉的编码环境中直接评估新模型,而不必先切回聊天界面。
电脑操作能力:连接稳定性是短板
UP 主每次新模型发布都会测试电脑操作能力,此前的模型常常出现乱点、稳定性差的问题。这次测试 6.1 Terra 时出现了断连。
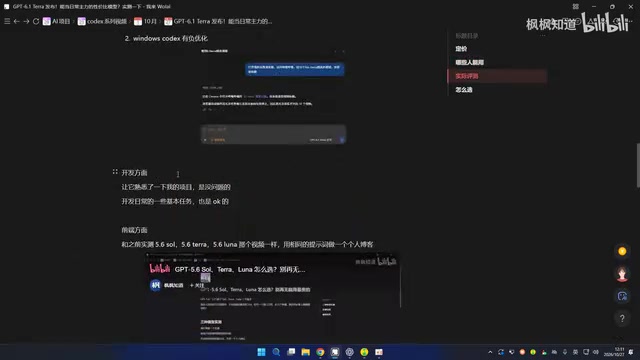
断连的原因被归结为两点:一是国内通过代理连接 ChatGPT 本身延迟很高,这是关键因素;二是 Windows 版 Codex APP 存在负优化,Mac 上的效果会好一些,Windows 上体验明显更差。这不能完全归咎于模型本身,但确实影响实际可用性。
"电脑操作能力"指模型通过截图识别界面、移动鼠标、点击按钮并输入文字来代用户完成软件操作,属于 GUI 代理(computer use)能力。这类任务对延迟极其敏感:每一步操作都需要上传屏幕截图、等待模型推理、再回传动作指令,形成一次往返。若单次往返延迟高,整个任务链条会被显著拉长,且中途任一步超时或丢包都可能导致会话中断,表现为"断连"。因此 GUI 代理的实际可用性不仅取决于模型本身的识别与规划能力,还高度依赖网络质量、客户端实现和本地执行环境的稳定性。
开发与前端能力:日常任务够用,审美有提升
在开发方面,UP 主让模型熟悉之前的项目,模型能够梳理出项目结构,日常的基本开发任务也能完成。
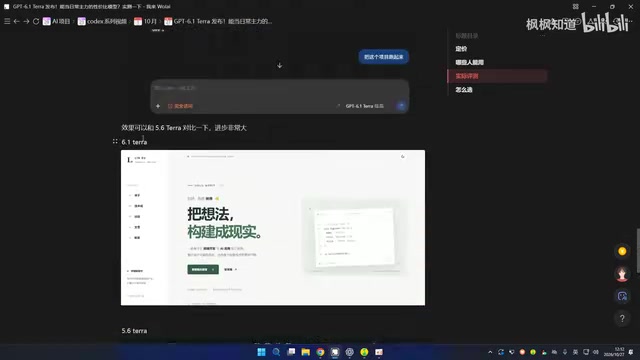
前端能力用相同提示词做了对比。此前 5.6 Terra 和 5.6 Luna 生成个人博客页面时,美观性一般;换成 6.1 Terra 后,页面效果有明显提升,整体更耐看。UP 主也承认这部分带有主观感受,但差距肉眼可见。
怎么选:按任务匹配,而不是追新
模型越来越多,选择策略反而简单了:按任务选。日常改代码、做页面、写东西,先试 6.1 Terra,能完成就继续用;如果搞不定,再升级到 6.1 Luna 或 GPT-6 Extra。没有绝对标准,灵活匹配任务才是关键。
综合来看,GPT-6.1 Terra 在价格和日常能力之间找到了一个不错的平衡点,适合作为主力模型处理大多数常规工作。但电脑操作类任务受网络环境拖累明显,这方面别抱太高期待。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。