GPT 6.1 Terra实测:能否打败国产守门员?

GPT 6.1 Terra实测总分78.4,性价比突出但视觉创意与3D建模落后旗舰。
B站UP主对GPT 6.1 Terra进行了七项实测,涵盖SVG动画、网页设计、全栈系统、2D/3D游戏、长文本和办公处理。该模型定位速度与效率优先,计算机操作跑分超过GPT 6.1 Sol并与旗舰GPT 6 Astro持平,成本却低得多。七项总分78.4,仅次于GPT 6 Astro的88分,与DeepSeek 4.1 Flash不相上下。全栈派单系统(94.8)和办公处理(96)表现最佳,但视觉创意、游戏手感和3D建模明显逊色。Terminal Bench仍落后Claude Sonny 5.5约20%,写作能力有提升但需验证。整体是高性价比的日常办公与多步骤计算机任务选择。
模型定位:速度与效率优先
据B站UP主实测,GPT 6.1 Terra(视频中亦写作Tero)定位为速度快、效率高的模型,官方强调其在视觉理解、计算机操作以及写作表达上的提升。与上一代GPT 5.6 Terra相比,新模型在起草提案、解读图纸、视频剪辑等日常办公任务中均有显著进步。UP主特别提到,此前GPT系列在写作方面表现糟糕,这次提升值得肯定。
官方跑分显示,GPT 6.1 Terra在计算机操作能力测试中超过了同代GPT 6.1 Sol,与旗舰模型GPT 6 Astro基本持平,但成本远低于后者。视觉能力虽与Sol有差距,但差距已非常小。在桌面应用多步骤任务中,其与Sol仅有微小差距,而相比Claude Sonny 5.5仍有约20%的落后,不过成本优势明显。幻觉控制方面,UP主称其最高可达4%左右,与GPT 6 Astro不相上下。Terminal Bench跑分中,GPT系列整体落后于Claude Sonny 5.5,UP主认为这一块仍需努力。
Terminal Bench 是评估大语言模型在真实终端环境中执行命令行任务能力的基准测试,涵盖文件操作、系统管理、脚本编写等场景。它要求模型不仅能生成命令,还要理解执行结果并迭代修正,因此能反映模型作为“计算机操作代理”的端到端能力。文章中提到GPT系列在Terminal Bench上落后Claude Sonny 5.5约20%,说明其在纯命令行环境下的任务完成率和纠错能力仍有差距,这与模型在图形界面计算机操作上的表现形成对比。
实测项目:七道题全面检验
UP主将“提壶测试”从1.0升级到2.0,题目从六道增至七道,新增日常办公与计算机操作考察。每道题均为独立项目,考验模型交付能力,涵盖审美、SVG、业务理解、3D游戏、长文本及办公等维度,逐题评分后排名。
第一题:SVG动画叙事
题目要求绘制提壶骑自行车送布丁、过减速带爆胎后抬车前进的约10秒SVG动画。GPT 6.1 Terra的作品中,后轮破损、提壶下车抬车等关键动作到位,但脚部层级与踩踏方向有误,抬车缺少重量感。对比GPT 6 Astro,效果差距明显。UP主在空间关系上给6.5分(因脚部问题),动作衔接6分(略生硬),构图7分,总分65.5。
第二题:静态网页设计
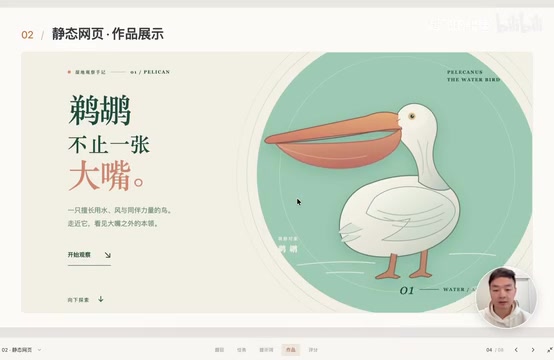
要求制作600字提壶介绍的静态网页。作品配色舒服、设计简约,但页面全静态,未按提示词加入动画。UP主指出“俯冲”部分的提壶配图存在问题,但三种提壶的SVG对应正确。视觉冲击与创意5分,画面动画与浏览体验5分(动画基本没有),主题内容准确性5分,总分65分。
第三题:全栈派单系统
要求开发提壶派单系统的前后端。作品采用商务后台风格,点击切换生硬,拍单选择界面较丑,搜索功能有闪烁问题,但配送员新增删除正常,已有配送的无法删除逻辑正确。接口脚本测试满分,高并发搜索、拍单性能及接口正确性均通过,业务实现无遗漏给10分,页面设计统一完成度10分,交互体验6.5分,总分94.8,为表现最佳的一题。
第四题:2D游戏开发
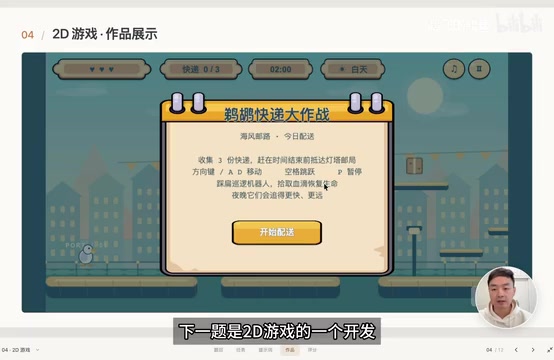
UP主升级了测试,提供部分游戏素材以考察视觉理解与素材使用。GPT 6.1 Terra使用了提供的弹框与UI素材,背景音乐正常,跳跃手感一般,踩踏后雪地补充雪、上升气流、昼夜切换、灯光效果等基础功能均有实现,但敌人卡顿、角色悬空等设计问题明显。对比GPT 6 Astro,后者在音效、画面丰富度、操作反馈上全面占优。角色控制、平台碰撞、战斗生命值、游戏循环均正确,视觉表现4.5分,手感与动作反馈4.5分,音效4.5分,总分72.5。
第五题:3D建模与游戏构建
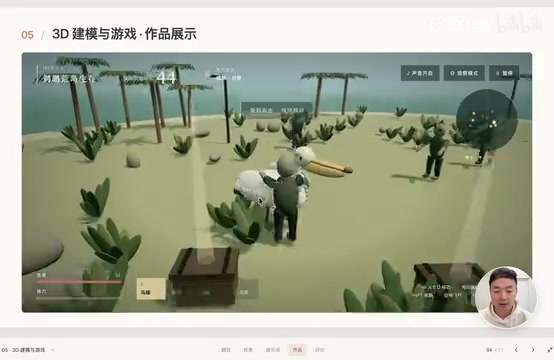
题目要求制作“提壶荒岛求生”恐怖紧张氛围游戏,考验模型对氛围的理解与建模能力。作品建模精细度一般,飞行正常,僵尸攻击无视觉效果,火箭筒爆炸效果平淡,无AK武器,60秒后过关。观察模式下模型由各种体素拼装,较为粗糙。对比GPT 6 Astro,画面丰富程度与音乐氛围感差距较大,攻击特效与建模精细度不在一个量级。建模贴图基础偏下,材质光影5分,画面与氛围6.5分(完整但粗糙),音效4分,动作手感4分,总分60分。
第六题:长文本理解与推理
提供50篇论文与《三体:死神永生》小说,设计18道题目考察长文本理解与推理。GPT 6.1 Terra得分94,仅错一道关于小说内容的题,UP主认为其在长文本理解与推理上有轻微不足。
长文本理解与推理 测试通常要求模型在数万至数十万token的上下文中定位、整合和推理信息,考察的是上下文窗口的有效利用能力,而非单纯的支持长度。文章中的测试提供50篇论文和一部小说,设计18道题,其中涉及跨文档信息比对和叙事细节推理。模型仅错一道小说题,说明其在长上下文中的信息检索和逻辑整合已接近可用水平,但轻微不足可能源于对文学文本中隐含因果关系的把握。
第七题:办公处理
要求根据Excel与PPT完成数据报表及计算修改,交付表格、PPT及PDF。评分96分,UP主指出中间有一处不正确。
排名与对比:与国产模型不相上下
综合七题,GPT 6 Astro以88分居首,GPT 6.1 Terra以78.4分紧随其后,与DeepSeek广告 4.1 Flash不相上下。UP主表示实际使用中两者差距不大。垫底的是MiniMax M3.1 Flash。
从实测看,GPT 6.1 Terra在计算机操作、接口实现、办公处理上表现扎实,但在视觉创意、游戏手感、3D建模等需要“惊艳感”的维度上明显逊于旗舰GPT 6 Astro,与国产头部模型DeepSeek 4.1 Flash处于同一梯队。其核心优势在于成本与效率的平衡——跑分接近旗舰,价格却低得多。对于日常办公、多步骤计算机任务等场景,它是高性价比选择;但若追求视觉表现与游戏开发质量,仍需旗舰模型或更强国产模型。
UP主也指出,GPT系列在Terminal Bench上仍落后于Claude Sonny 5.5,写作能力虽有提升但过往积弱,能否真正扭转口碑还需更多验证。
幻觉控制 指模型生成内容时避免编造事实或产生与输入不符信息的程度,通常以幻觉率衡量。文章提到GPT 6.1 Terra的幻觉控制最高约4%,与旗舰GPT 6 Astro相当。这一指标在长文本问答和办公数据处理中尤为关键,因为低幻觉率意味着模型更少输出错误数据或虚构引用。4%的水平在当前模型中属于较好表现,但仍需结合具体任务类型评估,例如开放域问答的幻觉率通常高于封闭域抽取任务。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。