GPT-6.1-Terra实测:性价比与速度的平衡之作

GPT-6.1-Terra成本仅为竞品零头,后端强但前端偏弱,适合按场景拆分任务
B站UP主实测显示,新发布的GPT-6.1-Terra在成本上优势显著:完成相同任务费用仅0.85,远低于Claude Opus 5.5的13.41和GPT-6.2的7,相差十几倍。其综合评分排第八,后端处理位列第三,但前端交互仅第18位,能力分布不均衡。实战中,3D停车场网页开发不到10分钟完成,效果符合预期但前端精细度不及DeepSeek。Computer Use点击速度较6.1版提升,但仍有选择时的停顿卡顿。两项测试Pro额度消耗均约1%,省token特性明显。作者建议按能力矩阵拆分任务:前端交给专精模型,后端与流程自动化交给Terra。
在模型迭代速度越来越快的当下,单纯比拼跑分已经很难指导实际选型。真正影响开发体验的,往往是单位任务成本、响应速度以及特定场景下的完成质量。B站UP主的最新实测视频,恰好提供了这样一个观察样本:新发布的GPT-6.1-Terra在价格和速度上表现突出,但在前端设计等环节仍有明显短板。
价格优势:完成相同任务成本仅为竞品零头
视频中最直观的对比来自费用消耗。完成相同任务时,GPT-6.1-Terra的费用消耗为0.85,而Claude Opus 5.5高达13.41,GPT-6.2也达到7。这意味着Terra的成本与部分竞品相差十几倍。
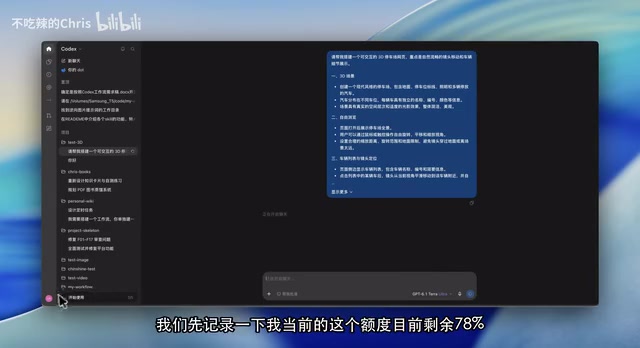
对于需要频繁调用模型、批量处理任务的开发者来说,这种量级的成本差异会直接改变工作流设计——原本因为token费用而需要精打细算的场景,现在可以更放心地交给模型处理。UP主在测试Pro订阅额度时也印证了这一点:完成一个完整的3D停车场网页搭建任务,额度消耗仅约1%。
Token费用是大模型API调用成本的核心计量单位。模型将输入文本和输出文本分割为token(约为一个汉字或英文单词的一部分),按token数量计费。不同模型的单价差异巨大,且输出token通常比输入token贵数倍。对于批量处理或高频调用的场景,单价差异会随调用量线性放大,直接决定项目可行性。文章中的"完成相同任务费用"正是以token消耗量乘以单价计算得出的横向对比指标。
综合评分第八,后端能力亮眼但前端偏弱
从评分维度看,GPT-6.1-Terra的综合评分排在第八位。其中后端处理能力位列第三,这是它相对强势的领域。前端交互的排名则靠后,大约在第18位。
UP主在视频中直言,如果涉及前端设计相关任务,DeepSeek广告在前端方面的评分非常高,是更合适的选择。这种能力分布的不均衡,说明Terra的定位并非全能选手,而是有明确侧重的生产力工具。
Computer Use(计算机使用)指AI模型通过模拟鼠标点击、键盘输入等操作直接控制图形界面完成任务的能力,区别于通过API调用工具。它依赖视觉理解屏幕内容并规划操作序列,对模型的感知与决策连贯性要求很高,因此实际表现常受网络延迟、界面渲染速度等因素影响。文中UP主测试面试系统页面点击,正是典型的Computer Use场景。
3D停车场实战:不到10分钟出可交互成果
为了验证实际表现,UP主给模型下达了一段提示词,要求搭建一个可交互的3D停车场网页,并将思考深度拉到最高档Ultra。模型通过Codex完成开发,总用时10分52秒——其中还包含几分钟的网络连接问题排查,实际纯开发时间不到10分钟。
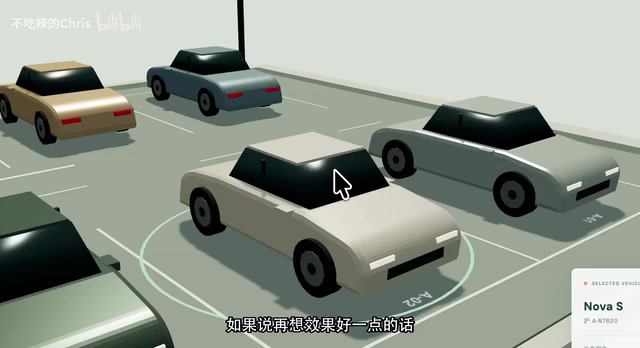
从成品效果看,视角可以随意切换,放大后能查看细节,点击任意车辆即可切换到该车附近视角。UP主评价称,这么快的时间做出这样的效果符合预期,但若要进一步提升效果,还需在前端设计上继续调整,且坦承效果不如DeepSeek。
Codex在此处指OpenAI提供的代码生成/执行环境(或基于该能力构建的编程代理),模型可在其中编写、运行和调试代码,从而完成网页搭建等开发任务。与纯文本生成不同,Codex环境让模型能实际执行代码并观察结果,适合需要迭代验证的工程类任务。UP主将思考深度调至"Ultra"档,意味着模型在生成前进行更长的推理链,通常能提升复杂任务的完成质量,但也会增加响应时间。
Computer Use实测:点击提速但仍有卡顿
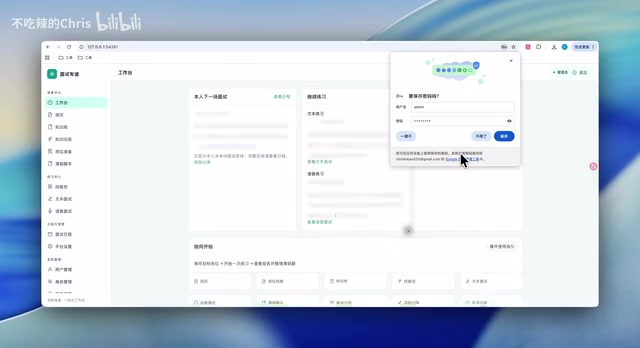
在Computer Use环节,UP主用自己开发的面试系统测试业务主流程的页面点击。模型被要求通过实际点击的方式完成测试。
实测显示,GPT-6.1-Terra的点击速度比之前使用的6.1版本更快,但过程中仍会出现卡顿——在选择某些选项时会停顿思考,UP主不确定这是否与网络状况有关。整个业务自测流程下来,额度消耗甚至不到1%,再次印证了其省token的特性。
选型建议:按场景分配任务
综合来看,GPT-6.1-Terra的定位相当清晰:它适合对成本敏感、需要快速响应的后端处理和自动化操作场景;而在前端设计这类需要精细审美的任务上,DeepSeek等模型仍有优势。对于同时使用多个模型的开发者,将任务按能力矩阵拆分——前端交给专精模型、后端和流程自动化交给Terra——可能是现阶段更务实的策略。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。