GPT-6.2 Astra vs Sol实测:Blender钟表、Neon Cube与Godot赛车三项对比
GPT-6.2 Astra 执行力强但贵,Sol 便宜却偷懒,两者均未超越竞品。
B 站 UP 主用同一套简报实测 OpenAI 新发布的两款模型 GPT-6.2 Astra 和 Sol,涵盖 Blender 钟表工坊、霓虹方块设计和 Godot 赛车游戏三项任务。Astra 三次总花费 419 美元,Sol 仅 197 美元,但 Sol 在多个任务上表现明显更差:钟表测试中两者都未造出真正的擒纵机构;霓虹方块中 Sol 耗时 9 小时才花掉第一个 100 美元且敌人设计偷懒;赛车游戏中 Sol 版本掉到每秒两帧。Astra 完成度更高,会听意见并花光预算,但 UP 主认为 Fable 和奥普斯在细节与操控上仍更优。结论是模型价格与能力并非线性关系,单位任务完成质量比单次调用价格更值得关注。
同题测试背景:两款新模型,差距悬殊
OpenAI 一次发布了两款新模型:GPT-6.2 Astra 和 GPT-6.2 Sol。据 B 站 UP 主实测,两者跑同一套由 Collectable 5.2 上周设计的简报——同样的规则、同样的任务——结果差异大到令人意外。其中一个在时钟测试上只花了 5 美元,另一个在同一项测试上花了 400 多美元;其中一个游戏帧率掉到每秒两帧,另一个则能正常跑完。
OpenAI 官方页面给出的定位是:Astra 面向最难的专业工作,Sol 是日常模型,价格只有 Astra 的四分之一。官方基准数据旁列出了 Collectable 5.2 和 OPS 5.5 作为对比:Astra 在大部分任务上胜出,且每个任务成本低得多。但在 BenchC 的前沿代码评测上,Collectable 5.2 仍居第一;在人工分析指数上也是如此。
UP 主的态度很明确:不信表格,只跑自己的测试。测试共三项:Clockwork(Blender 里的钟表工坊)、Neon Cube(纽约风格霓虹方块设计)和 Formula(Godot 里的赛车游戏)。两款游戏都在 Godot 中运行,两者都基于 Astra Hi-F4,最多三个辅助代理,图像生成关闭,全部跑在 UP 主当前的订阅上,每一美元都是按付费价格估算的。
Collectable 5.2 与 OPS 5.5 是文中反复出现的两个竞品模型,分别来自不同厂商。Collectable 系列以代码能力见长,5.2 版本在 BenchC 前沿代码评测中排名第一;OPS 系列则强调多模态与游戏开发场景的平衡,5.5 版本在人工分析指数上领先。两者在钟表、霓虹方块和赛车游戏测试中均被 UP 主作为审美与操控的参照系,尤其在手部模型、光影氛围和驾驶手感上被认为优于 GPT-6.2 Astra。
BenchC 是一个专注于前沿代码生成与工程任务的第三方评测基准,覆盖算法实现、系统调试和长程项目构建,与官方基准不同,它更强调模型在真实开发流程中的自主性。Collectable 5.2 在该榜单上居首,说明其在代码逻辑和工程细节上仍有优势。
测试一:Clockwork 钟表工坊——都能建模,但都不会走
Clockwork 的设定是波兰德里日出前一座旧钟楼里的工坊。只给一个提示词,没有参考图,没有说明,没有 MCP,模型需要自己写 Python 脚本并运行 Blender 无头模式,全程命令行,全靠自己。
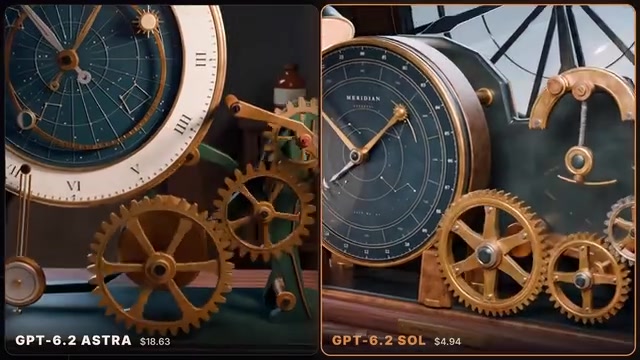
Astra 的整体效果不错,背景里创建了很多细节,但钟看起来有点沉重。Sol 的钟更沉重。把两者并排打开,布局几乎一样:中间靠后的大表盘、旁边的齿轮、左边的玻璃,几乎所有东西都在同一位置。UP 主查看需求说明后发现,提示词只要求大塔钟表盘、台面上滴答走动的钟和玻璃,各个部分放哪由模型自己决定。再查日志,两者都没打开过对方的文件夹。
更有意思的是,更早的 GPT-6.2 版本布局不同但颜色相似:表盘上相似的绿色、金色和新谱色,两个星钟甚至拿到了同一个编号——7 号。这说明同一个模型家族在相似任务上存在趋同的审美偏好。
但真正的问题是:这钟能走吗?UP 主打开两个文件,测量了每个轮子。齿轮没问题,三个轮子相互咬合,转向相反,速度也匹配,滴答完全准确。然而白锤只是自己摆动,不驱动任何东西,没有擒纵机构。也就是说,两者都只是带白锤的齿轮箱,不是钟。相比之下,GPT-6.2 Astra 之前做的 Faber 和奥普斯都造出了真正的擒纵机构,一个真正会滴答走的钟。
价格方面,Astra 花了 18 美元,Sol 不到 5 美元,确实便宜。UP 主还对比了历次钟表测试的成本:Faber 5.2 花了 36 美元,奥普斯 5.5 成本更高,GPT-6 Astra 花了 30 美元,Sol 花了 16 美元,老板 Faber 5.1 花费更多。Sol 是这次测试里最便宜的模型,在 UP 主看来也是最差的。
擒纵机构 是机械钟表的核心调速装置,由擒纵轮、擒纵叉和摆锤(或摆轮)组成。它负责将齿轮系的连续旋转转化为周期性的停顿与释放,从而让钟表“滴答”走动并保持走时精度。没有擒纵机构,齿轮组只能空转,摆锤的摆动也无法反馈控制轮系速度。文中 Astra 和 Sol 虽然做出了咬合正确的齿轮,但白锤只是独立摆动,未与轮系联动,因此本质上只是齿轮箱而非真正的钟。此前 Faber 和奥普斯成功造出擒纵机构,说明模型在理解机械联动逻辑上存在代际差异。
测试二:Neon Cube——Astra 完成度高,Sol 慢且偷懒
Neon Cube 要求在立方体内设计,每面墙都是夜晚霓虹城市的街道,还能沿墙走上去,预算上限 200 美元。
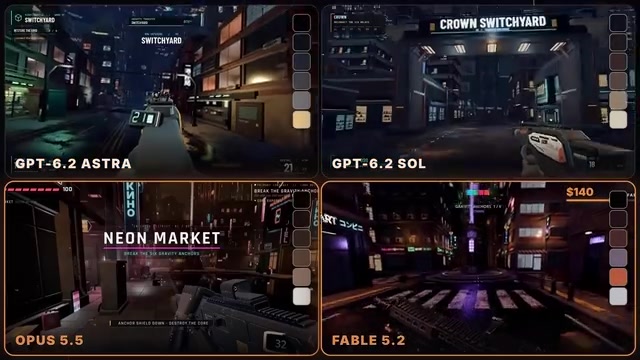
Astra 花 100 美元做出的效果:一开始看着不错,墙上好像没有不紧,战斗设计手感挺好,手正好握在枪上,但敌人太少,右键没有缩放,夜晚有点太亮。
Sol 则非常慢,花了 9 小时才花掉第一个 100 美元。UP 主又给了它一些预算并提示多用携带力把预算花掉,结果几乎没有敌人——原来敌人要等玩家打开祭奠器才出来。颜色方面,GPT 模型有自己的调色板,Sol 6.1、Sol 6.2 和 Astra 6.2 看起来差不多,更亮一点,橙色更少。Astra 6.2 最好,但奥普斯和 Fable 更暖偏橙色,UP 主更偏好那种风格。
把笔记发过去继续做之后,Astra 的最终游戏右键缩放能用,夜晚更暗,200 美元预算全部花光,总体挺不错,但还没到奥普斯和 Fable 的水平。Sol 的最终游戏敌人一开始就在街上,预算只花了 145 美元。Astra 游戏里有一个亮点:水洼会反射城市的真实招牌和建筑,Astra 甚至专门为此写了自己的 Shader;而 Sol 的街道只是发亮,能看到一些灯光反射。对 UP 主来说,Fable 和奥普斯仍然更胜一筹,就是更喜欢那种风格和静态效果。
Shader(着色器)是运行在 GPU 上的小型程序,用于控制像素或顶点的颜色、光照和反射等效果。文中 Astra 专门为水洼编写了自定义 Shader,使其能实时反射城市的真实招牌和建筑,这需要模型理解渲染管线并编写 GLSL/HLSL 代码。Sol 的街道只是简单发亮,缺乏动态反射,说明它没有主动实现复杂的渲染逻辑。自定义 Shader 是游戏开发中区分“能跑”和“有质感”的关键技术点,也是 Astra 完成度更高的体现。
测试三:Formula 赛车游戏——Astra 能修好,Sol 掉到每秒两帧
Formula 是一款与车手竞速的赛车游戏,模型要做车、赛道和人群,预算 200 美元,实际上给 Astra 和 Sol 各 100 美元。
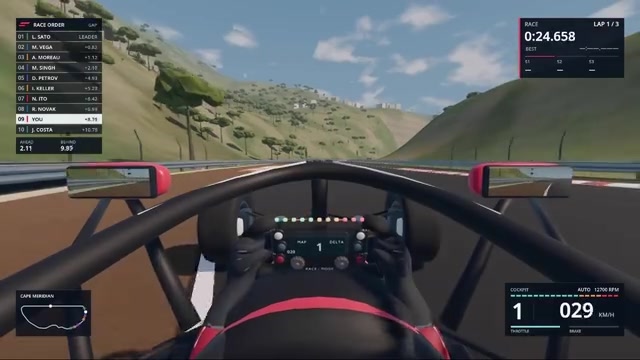
Astra 的第一版看起来不错,但 UP 主开不了:每个弯道都把他转得打转,背景有点弱,坐舱视角里方向盘上的手指也很糟糕。Sol 这边,UP 主犯了一个错——告诉 Sol 它能应付,因为 Sol 花预算花得很慢。结果确实如此,27 分钟只花了 28 美元。客观说,28 美元这样不算差,比上次 Sol 6.1 好多了:有山丘、低多边形树木、非常漂亮的天空,操控其实比 Astra 更好,因为真的能开得动。但还是感觉像个玩具,没有速度感,引擎声很弱,方向盘上的手也做得很糟。
修复之后,Astra 的最终版驾驶终于修好了,不会再每个弯都打转,新增的山脉看起来非常棒,四种树带中楼的存装,而且用光了全部预算。Sol 的最终版车感觉更重,镜头会随速度变化,引擎声更响,衣服也是新的。但有一个问题:在 Sol 游戏里的某个时刻,每次尝试都会掉大约每秒两帧,最后只能作罢,不再修了。
Formula 这一项,UP 主认为 Fable 和奥普斯仍然赢,差距在细节上,比如手部模型差距巨大,而且不只是静态画面——AnswerPic 模型的操控就是好得多。UP 主承认它们更慢,但对游戏的感觉更好,至少对他测试的游戏是这样。
账单与结论:Astra 执行力强,Sol 便宜但偷懒
三次测试的总账单:Astra 419 美元,Sol 197 美元。UP 主注意到 Astra 花钱很快,两个游戏都在约 5 小时内达到 200 美元上限。
对 GPT-6.2 Astra 的评价是:很强的模型,能把事情做完,会听意见,给它每一美元它都会用掉。对 Sol 的评价是:便宜又偷懒,但做这种商店只要 5 美元,太疯狂了。相比 Fable 和奥普斯,UP 主仍然认为它们更胜一筹,但 Astra 已经很接近了。
这次对比揭示了一个关键点:模型价格与能力并非线性关系。Sol 在简单任务上成本极低,但在需要持续投入和复杂推理的任务上,它要么花不出去钱,要么产出质量掉队。Astra 则表现出更强的任务执行力和预算利用效率,尽管它在某些细节审美上仍不及竞品。对于需要模型自主完成复杂工程的场景,单位任务的完成质量比单次调用价格更值得关注。
人工分析指数(Humanity's Last Exam 等人工评测的统称)与自动化基准不同,它由领域专家设计高难度问题,覆盖数学、逻辑、代码和视觉推理,用于衡量模型在开放复杂任务上的上限。文中提到 Collectable 5.2 在该指数上居首,而 Astra 虽在官方基准胜出,却未在人工分析指数上超越竞品,说明官方表格与第三方人工评测之间存在落差。这也解释了 UP 主“不信表格、只跑自己的测试”的态度——基准分数无法完全反映模型在长程工程任务中的预算利用效率和审美一致性。
相关推荐
OpenAI发布GPT-6.2 Astra与Sol:长上下文与双模型策略解析
OpenAI 发布 GPT-6.2 系列 Astra 与 Sol,均支持 105 万 Token 上下文,Astra API 单价降 20%。结合社区实测,解析双模型定位、知识新鲜度与不确定性表达的真实表现。
Bot-sitting:AI时代的新工作陷阱?
Bot-sitting现象揭示AI生成内容背后的校验负担:60%工作者认为从AI获取优质成果的努力不亚于培训新人。本文分析AI效率幻象、工作形态转变及应对策略。
Pandex:通过MCP让AI智能体接入欧洲官方法律
Pandex项目通过MCP协议将欧洲官方法律开放给AI智能体调用,探索智能体合规的新路径。本文分析该方案的架构思路、现实优势与落地挑战,以及它对AI应用开发者的参考意义。